- 日期:2026-10-08
- 讀者:研究生、科研新人和工程型研究者
- 範圍:一個小模型、64條開發樣本、兩組四示例及正反順序;不是完整基準或未見測試集。
摘要:給了例子,不等於教對了
給模型四個帶答案的例子,再讓它判斷新句子,直覺上應當比直接提問更可靠。但例子不僅提供任務信息,也改變輸入長度、標籤位置和上下文分佈。“加了四個例子”不是足夠完整的實驗條件。
**本次實際驗證:**固定SmolLM2-135M-Instruct和SST-2的64條開發樣本,零示例答對32條;同樣四個示例,正序答對31條,反序答對37條。另一組的兩種順序分別答對33條和44條。我們沒有找到普遍更好的順序,而是發現:示例數量相同、長度相同,內容和排列仍會改變測量。
復現價值:從總分轉向配對觀察
Few-shot在本文指上下文學習:把少量輸入與答案放進提示,模型在推理時利用它們;沒有梯度更新,也不是用四條數據微調。零示例同樣不意味著模型從未經過指令訓練。
**論文報告:**Lu等在ACL 2022研究示例排列敏感性,指出一個模型上的好排列未必能遷移給另一個模型。[1] Zhao等在ICML 2021討論提示帶來的答案偏向及上下文校準。[2] 這些工作支持檢查順序與答案先驗,不意味著它們的提升幅度會在本篇重現。
近期工作中,Cobbina與Zhou的EMNLP 2025論文區分了“示例內部怎樣排列”和“整組示例放在系統提示、用戶消息的什麼位置”,同時衡量準確率與預測變化。[3] 本篇只處理前者,示例始終在問題之前;不把兩類變量混為一種位置效應,也沒有復現該論文的完整評測。
相對上一篇,我們保留模型、題目、候選和計分方法,只增加示例集合與排列。新增產物不是最好的一行分數,而是五種條件下同一道題的對應記錄。
核心思想:同一題才是比較單位
令為示例集合,為順序,為第道問題。拼接後的上下文記為,候選得分為:
是候選位置,是候選token數,是凍結權重。選擇總對數似然較大的候選,不做長度歸一化;並列時取第一個。候選仍為negative與positive,不改成字母,不自由生成,也不增加答案抽取器。
對條件與,先計算每道題的正確性差值,再求平均:
為零或一,本次。五種條件產生320條預測,但不是320道獨立問題。配對記錄才能說明多答對的題來自哪裡,不能把重複測量當作樣本量增長。
預測翻轉率回答另一個問題:
是預測類別。準確率不變也可能有很多題改了答案,只是得失抵消。因此同時報告錯轉對、對轉錯和預測翻轉數,不能只看總分。
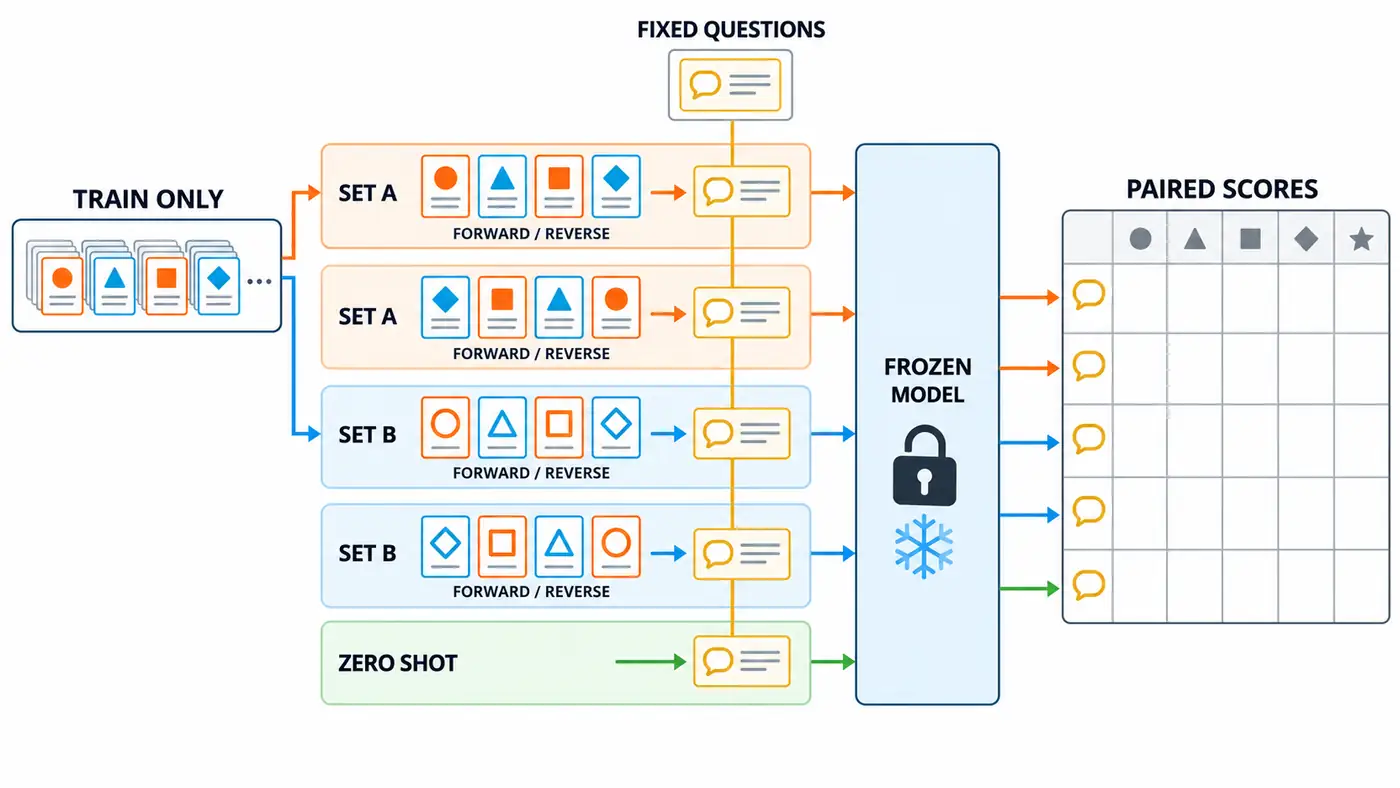
每條通道是一次獨立條件評測,不是把兩組示例同時塞入一個提示;右側網格以問題為行、五種條件為列,僅示意配對關係,不展示測量值。
官方代碼閱讀路線
先讀固定提交的SST-2配置,確認模板、候選順序、標籤映射和acc指標。[4] 接著讀ContextSampler:sample負責選例子,get_context負責拼接題幹、答案與分隔符。[5] “隨機種子固定”不能替代保存具體示例編號,尤其當遍歷順序或調用次數發生變化時。
本地FixedSampler只覆蓋sample方法,返回凍結的訓練行,其餘拼接調用官方實現。同時獨立構造完整提示,與fewshot_context逐字符比較。custom_dataset讀取固定parquet,改變的是離線傳輸,不是任務內容。
最後追到simple_evaluate與HFLM的候選似然路徑。[6] 官方返回之外,再用Transformers獨立前向計算每個候選token。輸入形狀為,輸出為;上下文有個token時,第一個候選token取位置的分佈。兩個實現覆蓋同一批640個候選,不是隻比較五個均值。
最小實驗:先凍結,再看結果
模型revision為12fd25f77366fa6b3b4b768ec3050bf629380bac;數據使用GLUE的固定SST-2副本,revision為bcdcba79d07bc864c1c254ccfcedcce55bcc9a8c。[7][8] 評測器固定為0.4.9.2,commit見源碼地圖,不聲稱是當前最新版。
開發題沿用既定哈希順序選出的64條。另留128條SST-2確認樣本,不送入模型;此前預留的新聞確認樣本也未使用。開發集已經反覆出現,因此這是探索性協議實驗,不能重新包裝成未見數據上的最終驗證。
示例僅來自官方train。排除與validation任一句子規範化後完全相同的文本,再排除八個示例之間的重複;篩查只使用文本,不使用驗證標籤。按固定哈希排序,每個標籤取四條滿足長度條件的訓練記錄;A、B各用兩正兩負,正序按負、正、負、正排列,反序完整倒置。
每個含答案和分隔符的示例塊單獨分詞為42個token,四塊相連的前綴實際為171個token,不能簡單乘四。完整輸入還要再次分詞:四個few-shot條件對每道題的上下文長度都相同,為191至233;零示例為19至61,均低於512,沒有截斷。
這些是有意選取的短、平衡、等長示例,不代表整個訓練分佈。控制成本混雜的同時,也引入了範圍限制。示例身份與全部條件在推理前寫入plan.json,不根據分數更換樣本,不追加排列搜索。
CPU單精度、四線程、eager注意力、候選批量一,不套聊天模板、不加BOS或EOS、不開請求或響應緩存。四個few-shot條件各處理26522個候選輸入token;零示例僅4506。因此組內順序比較等長,但few-shot與零示例並不是等計算量比較。
本次實際驗證:負結果與改善一起報告
正式運行從第三方導入後計時102.77秒,峰值RSS為1994588160字節,未測GPU顯存。五條件共320條預測,官方與獨立實現的640個候選分數最大絕對差為零;題號、金標籤、提示哈希和候選邊界全部通過核對。
| 條件 | 正確數 | 準確率 | 預測為positive |
|---|---|---|---|
| 零示例 | 32/64 | 50.00% | 3 |
| A正序 | 31/64 | 48.44% | 0 |
| A反序 | 37/64 | 57.81% | 6 |
| B正序 | 33/64 | 51.56% | 2 |
| B反序 | 44/64 | 68.75% | 13 |
A正序比零示例少對一題,實際有三題翻轉:一題由錯轉對,兩題由對轉錯。這個淨差不能證明few-shot總體有害,但說明“例子更多所以本次必然更好”的預設不成立。
A正序到反序有六題由錯轉對、沒有對轉錯,提升9.375個百分點;B相應有十一題由錯轉對,提升17.1875個百分點。分母始終是相同64題,不能把兩項變化相加,當作一種新方法的收益。
示例選擇也影響結果:相同正序位置下,B比A多對兩題;相同反序位置下,多對七題。這提示集合效果與排列有關,但兩組集合、兩個排列遠不足以估計穩定的總體交互效應。我們保留全部條件,不以最高分替代完整報告。
沿著一條記錄看變化
以編號400為例,金標籤為正面。零示例時,negative與positive的對數似然約為負三點八七四和負四點七六五,模型選了負面;B反序時,兩者約為負零點七六三和負零點六五一,正面候選才取得更高分。這道題在A的兩個順序和B正序中都沒有改對,不能僅用“有了示例”解釋變化。
讀記錄時應先核對題號和金標籤,再對照候選順序,最後觀察分數。不同提示下單個答案的絕對對數似然變化,不等於準確率的變化,也不能直接稱為置信度校準改善。本文只在同一道題、同一種條件的兩個候選之間取最大值,然後統計預測變化。
這個案例是結果產生後用於解釋計算鏈的例子,不是提前指定的主要指標。不能因為它恰好支持某個故事,就忽略其餘六十三題。完整逐題文件保留成功、失敗和沒有變化的記錄,讀者可以重新聚合,而不必相信作者挑出的少數例子。
失敗排查:控制長度,也要控制解釋
最初試跑把任務初始化時間也按樣本數放大,觸發600秒預算檢查。分離固定開銷後,保守預測仍為816.96秒,故在正式運行前明確把本地CPU上限改為1200秒,內存仍為4GiB。最終試跑預測944.89秒並通過,正式運行實際約103秒。兩次失敗、日誌和修訂原因均保留,沒有藉資源調整更換表現不好的條件。
需要防範四類靜默錯誤:示例從評測題洩漏、反序時標籤配錯、長提示自動截斷、結果沒有按真實編號對齊。獨立審計重新讀取數據和分詞器,驗證身份,再重算候選與配對統計。八項測試包含故意刪除記錄、重複題號、篡改預測或配對計數,確認錯誤會被攔截。
算術檢查由獨立腳本完成,不要求真人逐題按計算器,也不聲稱有人新增語義金標。數據卡許可標記不明確,公開包只保留索引、哈希與派生分數;不上傳完整影評、提示、題幹token、權重和緩存。固定版本下載腳本負責獲取資源。
可檢驗問題:不要只尋找最好順序
**作者推斷:**排列變化明顯影響了類別偏向,但不能據此鎖定“最後一個標籤”機制。A正序末例是正面,模型卻全部預測負面;反序同時改變首尾和中間位置,當前對照沒有隔離哪個位置負責。
更可檢驗的設計是固定首尾只交換中間,或者固定內容只改變末例位置,並在獨立開發劃分預先確定策略。校準應作為單獨變量,保留未參與選擇的確認集。不要在這64題上一直試到最高分,再宣佈順序問題已經解決。
還有一個重要邊界:沒有規範化後的完全重複,不代表不存在同源片段、語義近鄰或預訓練汙染。當前篩查只能排除明確檢查過的那一類重疊。擴展實驗時,應記錄示例與題目的來源關係,再分別控制相關性、長度和標籤位置;如果一次改變所有因素,即使分數提升,也難以回答究竟改善了什麼。
總結起來,few-shot不是隻有示例數量的開關。記錄選了誰、排在哪裡、用了多少token、同題怎樣變化,才能區分任務信息、標籤偏向和評測偶然性。本篇完成的是可審查的局部實驗,不是新的提示詞配方。
源碼與復現入口
完整源碼、依賴、凍結計劃與逐題記錄已公開:固定版本源碼目錄、README運行說明、SOURCE_MAP源碼地圖。匿名下載的51個文件與本地歸檔逐一核對一致;公開副本的獨立審計、八項測試和真實模型試跑全部通過。
安裝README中的依賴、用prepare.py獲取並校驗資源後,最小真實入口為:
HF_HUB_OFFLINE=1 TOKENIZERS_PARALLELISM=false python run.py --cache ./cache --out smoke-new --private private-new --smoke
該命令對兩道開發題執行全部五種條件,並檢查官方與獨立評分。去掉--smoke運行完整64題;再執行python audit.py --cache ./cache --out results核對保存結果。輸出目錄須用新名稱,避免覆蓋證據。當前已完成五條件正式運行,沒有訓練模型、沒有使用確認集,也沒有把論文數字當成本地結果。
參考資料
檢索日期:2026-10-08。近期工作與經典論文圍繞本篇問題選取,不宣稱覆蓋所有最新論文。
- Yao Lu等,ACL 2022:Fantastically Ordered Prompts and Where to Find Them: Overcoming Few-Shot Prompt Order Sensitivity。
- Zihao Zhao等,ICML 2021:Calibrate Before Use: Improving Few-shot Performance of Language Models。
- Kwesi Adu Cobbina、Tianyi Zhou,EMNLP 2025:Where to show Demos in Your Prompt: A Positional Bias of In-Context Learning。
- EleutherAI:固定SST-2任務配置。
- EleutherAI:固定ContextSampler、fewshot_context。
- EleutherAI:simple_evaluate、Hugging Face後端。
- HuggingFaceTB:固定SmolLM2-135M-Instruct模型卡。
- NYU:固定GLUE數據卡。