- 日期:2026-10-22
- 讀者:研究生、科研新人和工程型研究者
- 資料截止:2026-10-22;檢索近12個月相關工作,並保留必要經典研究。本文為四篇論文的證據深讀,未運行模型編輯實驗,不聲稱全面覆蓋。
摘要:改對一句話,還不等於修好一條知識
假設某研究所從甲城遷到乙城。模型終於能答對“研究所現在在哪裡”,但換成簡稱又回答甲城;問它所屬省份,也沿用舊地址。另一套系統已經更新文檔,卻因檢索到舊副本而給出同樣的錯誤。這是說明問題的假設場景,不是本文實驗。
兩個系統都可以宣稱“更新成功”,卻沒有完成同一種糾錯。本文的判斷是:**外部記錄通常更便於定位和替換修改對象,但答案是否隨之可靠改變,仍取決於檢索、適用範圍與推理;參數編輯可以改變不附帶文檔時的回答,卻不能僅憑目標問句成功就推斷關聯知識已經一致更新。**這個判斷來自對下述論文設置的綜合分析,並非某一榜單的冠軍結論。
先給“糾錯”劃出邊界
參數記憶,是知識通過訓練影響模型權重,回答時不必顯式取回原始記錄。參數知識編輯則試圖局部改變這些權重,使指定事實對應的輸出發生變化。外部記憶把更新寫在模型之外,回答時再調取記錄。檢索增強生成通常把文檔送入模型;檢索式編輯還可能訓練專門的路由器與回答模塊,兩者不能直接畫等號。
糾錯至少包含三件事。有效性問原問題是否答對;泛化問改寫、別名和關聯問題是否一起改變;局部性問不應受影響的行為是否保留。這種劃分在編輯研究中有明確依據,但各論文的測量方式不同。SERAC,§2、§4
邊界還必須由任務決定。研究所遷址不意味著它的成立地點也改變。“現在在哪裡”和“當年在哪裡”應有不同答案;若只是新增一個合作機構,也不能順手抹去原有合作方。實驗開始前需要寫清時間、關係是否允許多個取值、哪些後果是必然的。否則,傳播得越廣未必越正確,保持得越多也未必越可靠。
改變權重與改變讀取路徑,各自解釋了什麼
ROME(NeurIPS 2022)把特定前饋模塊視作可編輯的關聯映射,通過秩一更新修改權重。它在 GPT-2 XL、GPT-J 的 CounterFact 實驗中,同時考察目標改寫、換問法和鄰近主體,展示了局部編輯的可行性。這裡的“秩一”指更新矩陣具有受限結構,不是“只改了一個神經元”。論文的主指標比較新舊目標的概率,因此也不是任意開放問題的生成正確率(§3.1、§3.3、表4)。
這支持一種解釋:新答案可以通過模型內部的變化變得更容易輸出。本篇進一步指出,編輯能奏效,並不自動證明所有相關知識位於同一個可獨立更換的“事實格子”;局部測試也不能覆蓋所有可能後果。把修改算子叫作知識編輯,與證明模型形成了完整一致的新世界,是不同強度的主張。
SERAC(ICML 2022)提供另一條路徑:保存編輯記錄,由範圍分類器判斷當前問題是否受編輯影響;範圍內交給條件於記錄的反事實回答模型,範圍外沿用基礎模型。兩個輔助模塊都需要訓練,所以“基礎權重不變”不等於沒有學習成本。原文 QA-hard 在 T5-large 上同時施加十條編輯;結果與組件誤差分析表明,複雜問法的範圍判別仍是重要瓶頸(§3—5、表3—4)。
這支持另一種解釋:改善來自更準確地識別“何時應用這條更正”,不必是基礎模型本身重新記住了事實。對研究者而言,可檢查的記錄讓調試更直接,但路由錯誤仍可能把正確更正送給錯誤問題。若只演示一次成功檢索,就沒有檢驗容易混淆的近鄰問題。
兩種解釋可以同時成立。參數編輯解決的是一部分內部關聯修改,外部記錄改變的是獲取更新的通道;二者共同面對“更新應影響哪些輸入”的難題。不能把一個用任務訓練過的輔助系統,與一個只收到單條編輯的權重更新器相比,再把所有差異歸因於知識的存放位置。
真正拉開證據邊界的是關聯問題
RippleEdits(TACL 2024)把評測擴展到關係推論、組合問題、別名及應保留的事實。所測編輯方法未能一致處理這些後果;直接把新事實放入上下文的 ICE 基線總體較強。但 ICE 直接獲得對應編輯,並不是從混雜文檔中自行找到它;評測還篩選目標編輯成功、所需舊知識已能答對的情況,並以生成文本命中目標別名計分(§5.1—5.2)。
因此,它提供的是有條件的關聯更新診斷,不能證明完整檢索系統在真實資料庫中更可靠。不同模型和方法留下的可評樣本也可能不同,不能把篩選後的均分當作同一總體的成功率。
這裡需要防止另一種誤讀:關聯問題失敗,不必然等於“更新根本沒寫進去”。可能是新事實沒有推廣到反向問法,也可能是模型不知道另一跳知識,或者知道兩條事實卻沒有組合起來。反過來,回答出關聯答案,也可能是讀懂了當前提示。只有分別改變這些條件,才能區分解釋。
新基準擴大了問題,也改變了分數含義
近12個月檢索納入的 UniEdit(NeurIPS 2025,數據集與基準賽道)用知識圖譜構造更廣的領域與關係組合。表2中,IKE、SERAC 的泛化表現較強,但局部性較低;GRACE 保持性強,泛化則接近未編輯起點。最關鍵的閱讀細節在附錄 D.1:泛化和局部性檢查目標詞元是否進入前五候選,判斷題用第一候選;多跳任務會臨時補入模型不知道的非編輯跳。IKE 還使用訓練樣例作為上下文,SERAC 使用訓練後的輔助模塊。
所以,這組結果可以說明該協議下的取捨,不能翻譯成自然語言問答成功率,更不能直接與 RippleEdits 排名拼接。其數據主要圍繞英語、知識圖譜關係與生成問句,本篇也不將結論外推到中文開放文檔。論文能揭示舊指標遺漏什麼,但新增的評測支架必須算進解釋裡。
| 證據 | 核心條件 | 觀察支持什麼 | 不能據此證明什麼 |
|---|---|---|---|
| ROME | 特定模型、局部權重修改、概率指標 | 關聯可被定向修改 | 任意推論都已更新 |
| SERAC | 訓練輔助模塊、顯式編輯緩存 | 可分開處理範圍與回答 | 外部記錄天然不會誤用 |
| RippleEdits | 直接提供編輯、篩選可評樣本 | 關聯一致性值得單測 | 完整檢索鏈路的優劣 |
| UniEdit | 候選排序及中間知識補入 | 泛化與保持性存在取捨 | 無支架自由生成的成績 |
表中結論對應前文所引原文。它們沒有形成整齊的正反陣營:共同指向的是,單一目標問句不足以驗收糾錯;分歧更多來自任務範圍、輔助信息和計分方式。
把“更容易糾錯”變成可區分的實驗
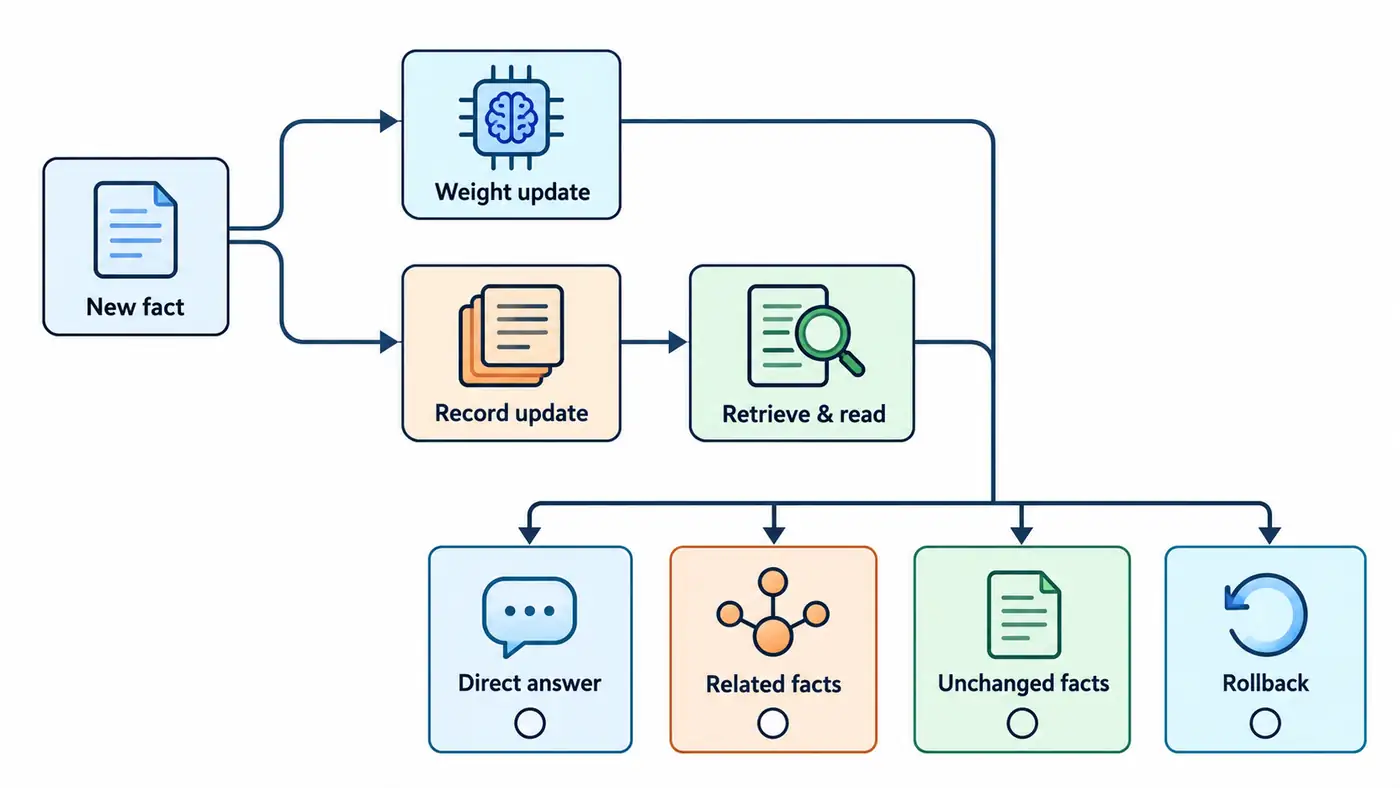
圖:本篇提出的干預與評測流程。兩條路徑接受同一更正,再分別檢查直接回答、關聯事實、無關事實與撤銷恢復。箭頭表示流程,空圓表示待測項目,不表示論文已證明成功,也不是知識存儲機制圖。
下面是尚未執行的研究設計。固定一個開放模型、同一組更正和同一批問題;把事實分成真實時效更新與明確標註的反事實更新,分別報告,避免把遵循假設誤算成掌握現實。
設置四個條件:原始閉卷模型、參數編輯、直接提供正確記錄、真實檢索後提供記錄。後三者使用同一更正文案;直接提供記錄是診斷參照,不算檢索方法的實際成績。如果真實檢索失敗而直接提供成功,優先檢查召回和排序;如果兩者都失敗,應繼續排查閱讀、範圍判斷或組合推理,不能把責任統統推給存儲形式。
每條更正提前配齊原問句、未見改寫、別名、反向關係、多跳問題,以及措辭很像卻不應改變的負例。測試問句和關係組合不能參與調參。需要語義裁定的項目,應由真實標註者按凍結規則確認;不能讓同一模型生成答案、裁定答案,再宣稱獲得獨立證據。
所有方法先報告完整樣本上的端到端結果,再單列“目標編輯成功且其餘跳已知”的條件結果。遇到原本不知道的中間事實,分別保留“不補入”和“補入”兩種評測,不把後者悄悄併入主成績。若只在補入後拉開差距,更合理的結論是特定信息條件下的利用能力不同。
資源也不能藏起來。參數編輯報告優化與保存成本,外部路徑報告索引更新、輔助模塊訓練、檢索次數和上下文長度;同時記錄推理耗時。固定輸入與生成預算是第一層控制,有訓練過的編輯器時,還要另列其訓練數據與費用。無法完全對齊時,應明確這是系統比較,不能聲稱隔離了存儲位置的因果效應。
最後做撤銷測試:恢復編輯前權重,或撤下更正並恢復舊記錄及索引狀態,檢查輸出是否回到預期。全量恢復檢查點,與從連續多次參數編輯中單獨撤回一條,並不是同樣的操作;外部系統也要納入重複文檔、緩存與派生摘要。記錄刪除成功只驗證了存儲動作,答案不再受舊更正影響才驗證了行為恢復。這是本篇提出的檢驗要求,不是四篇論文已完成的結論。
如果某方法只提升原問句,應稱為局部糾正;若關聯問題改善但近鄰負例惡化,則應報告影響範圍過寬。真正有說服力的結果,是在預先約定的範圍內同時說明改對了什麼、保住了什麼,以及撤銷時恢復了什麼,而不是尋找一個能掩蓋取捨的平均分。
總結:容易修改與可靠生效,是兩項證據
知識放在外部,往往更方便指出“這次改了哪份記錄”;知識寫入參數,則可能讓更新後的回答不依賴每次附帶資料。但可追溯的記錄仍需被正確使用,局部成功的參數編輯仍需通過關聯與保持性檢查。
對科研新人,更值得追問的是:**這篇論文究竟驗證了修改對象、更新範圍,還是最終行為?**先把三者分開,才能討論哪種路徑在什麼條件下更容易糾錯,也才能提出下一步真正能推翻某種解釋的實驗。
參考資料
- Kevin Meng、David Bau、Alex Andonian、Yonatan Belinkov. Locating and Editing Factual Associations in GPT. NeurIPS 2022。正式論文
- Eric Mitchell、Charles Lin、Antoine Bosselut、Christopher D. Manning、Chelsea Finn. Memory-Based Model Editing at Scale. ICML 2022。會議頁面 · 正式論文
- Roi Cohen、Eden Biran、Ori Yoran、Amir Globerson、Mor Geva. Evaluating the Ripple Effects of Knowledge Editing in Language Models. TACL 2024(預印本始於2023)。期刊頁面 · 正式論文
- Qizhou Chen、Dakan Wang、Taolin Zhang、Zaoming Yan、Chengsong You、Chengyu Wang、Xiaofeng He. UNIEDIT: A Unified Knowledge Editing Benchmark for Large Language Models. NeurIPS 2025,Datasets and Benchmarks Track。正式論文