- 日期:2026-10-20
- 讀者:研究生、科研新人和工程型研究者
- 資料截止:2026-10-20;檢索近12個月研究,並保留解釋爭議的經典論文。本文為證據深讀,未運行模型實驗,不聲稱全面覆蓋。
摘要:先確定“正確”指什麼
模型原本回答甲,看到檢索材料後改答乙。這究竟是成功更新,還是被錯誤信息帶偏?僅觀察答案變化,無法作出判斷。我們還需要知道:任務要求複述材料,還是回答現實事實;材料是否可靠;問題問的是哪個時間點。
**本文的判斷是:沒有脫離任務與證據質量的固定優先級。上下文遵循、事實正確和衝突下的不確定性,應當分別測量。**四項研究提供了不同切口:實體替換測試材料讀取,連貫反證測試答案偏移,混合材料測試錯誤覆蓋,顯式衝突分析嘗試改進裁決。它們沒有構成“相信檢索”與“相信記憶”兩個可以直接比總分的陣營。Longpre等、Xie等、Yigit-Sert、Peng等
同一個改口,可能對應三種解釋
參數記憶指訓練後保存在模型權重中的信息;實驗通常通過不提供材料的“閉卷回答”間接探測它。上下文知識則來自本次輸入的文本。檢索增強生成,簡稱RAG,就是先查找相關內容,再把內容交給生成模型。檢索分數主要幫助選取相關文本,不能自動為文本真實性背書。
這裡至少有三種可區分解釋。第一,模型識別出可信的新證據,修正過時答案。第二,模型遵循了“依據材料回答”的任務要求,即使材料描述的是反事實世界。第三,模型受措辭、篇幅或重複陳述影響,接受了錯誤信息。前兩種可能都是合理行為,第三種才是我們希望識別的風險;而三者都可能表現為從甲改成乙。
設想一個明確標為假設的例子:某機構舊址在甲城,新公告說遷至乙城。如果問題問“公告寫在哪裡”,材料中的乙就是目標答案;如果問“去年在哪裡”,舊址反而可能正確;如果公告來自無法核驗的轉載,最新日期本身也不足以決定可信度。把這三個問題混在同一準確率裡,評測會先於模型失去方向。
因此,閉卷答對一次只能證明該次輸出正確;寫出一段“記憶依據”也只是可觀察文本。它們都不能直接證明模型內部存有穩定、唯一且可完整讀出的事實記錄。後續研究需要保留這個測量邊界,而非把“內部知識”當作已經拿到的數據庫。
對研究者而言,衝突檢測和衝突解決也應分開:指出兩段話不一致,只完成了第一步;確定它們是否談論同一對象、同一時間與同一口徑,才可能判斷哪句話適用於問題。若兩份材料其實分別描述過去與現在,簡單刪除其中一份,反而可能損失有效信息。
四項研究,分別把什麼當作證據?
實體替換:能否服從給定材料
Longpre等在EMNLP 2021把問答材料中的答案實體替換掉,並相應改變目標答案。研究使用T5生成式閱讀器與RoBERTa抽取式閱讀器;推理時直接提供原始或替換後的正確支撐段落,繞過檢索器。這使問題集中在閱讀器如何處理衝突,而非搜索系統有沒有找到文檔。原文§2、§3.2
論文觀察到部分模型仍輸出原答案;替換數據訓練可以改善材料遵循。但這裡的成功首先是遵循修改後的文本,不能自動解釋為現實世界的事實核驗能力。作者也在§2.3承認自動替換有流暢性和答案質量缺口。原文§2.3、§4.4
其“記憶比率”還有一個重要分母:只在原答案和替換答案之間計算相對比例,其他答案不計入分母;分析又先限制在原始題答對的樣本。低記憶比率因此不等於高總體正確率,更不能直接讀成“模型學會辨別真假”。原文§3.3、§4
連貫反證:堅持舊答案並非穩定性格
Xie等的ICLR 2024研究在PopQA與StrategyQA上,先獲取閉卷答案及解釋,再構造支持另一答案的材料,並用文本蘊含與回答一致性檢查篩選。文本蘊含檢查問的是“材料是否支持這句話”,並不核驗材料在現實中是否為真;研究也保留了閉卷答錯的樣本。原文§3.1–3.5
研究報告:相比直接換詞,完整生成的連貫反證更容易改變答案;同時呈現支持原答案的材料與反證時,又常出現偏向原答案的行為。由此較穩妥的結論是,材料構造與組合會影響選擇。作者用連貫性解釋差異,但整段重寫同時改變很多文本屬性,尚不足以把效果完全歸因於某一種心理機制。原文§4.1–4.2
這裡不是後來的模型“推翻”了早期模型。數據、模型世代、材料生成方式與作答形式都不同;後者採用原答案、反答案和不確定三種選項,篩選後各模型的題目集合也不完全相同。所謂固執或易受影響,是特定協議下的行為描述。
錯誤覆蓋:指標能否承擔作者的解釋
Yigit-Sert的ROMCIR 2026工作坊論文抽取100道TruthfulQA題目,以GPT-4o和LLaMA-3.1-8B比較正確、錯誤及混合材料。其參數覆蓋率只統計閉卷原本答對、加入材料後答錯的比例。乾淨材料檢索使用“問題加正確答案”構造查詢,因此這是有答案輔助的受控診斷,不是普通用戶查詢下的端到端檢索評測。原文§3–4.1
表1報告錯誤覆蓋現象,但不能據此宣稱汙染比例越高,錯誤率必然逐檔增加:LLaMA的Mixed-67為0.583,全汙染條件為0.563,恰好不是單調上升。其“置信度”又來自人工標註回答語氣,而非預測概率;更肯定的措辭不等於更高的正確概率。不同條件下錯誤題目集合可能變化,語氣均值也混合了樣本構成變化。原文§4.2、表1;工作坊PDF第7頁
論文承認只有少量題目、兩個模型和合成錯誤材料。本文將它用於說明“原本會答也可能被材料帶偏”的診斷設計,不把局部結果升級成RAG普遍有害的結論。
顯式裁決:收益中還有哪些額外資源
2026年預印本MACR先估計回答不確定性,再把模型生成的知識或外部信息顯式寫出,藉助規則歸納、衝突分析和裁決模塊作答。表I在Llama3.1-8B、Qwen2.5-7B及三個基準上報告改善;表III的組件替換實驗也支持繼續研究這種流程。原文§III–IV
但§IV-A中的外部知識實際由GPT-4o-mini生成,不應讀成已經核驗的網頁證據。作者把同樣的信息也提供給基線,這控制了信息來源的一部分差異,卻沒有證明總調用次數和生成預算相等;§V明確承認額外調用成本。驗證集還參與閾值選擇,規則來自示例歸納,收益不能全歸於“模型終於知道該相信誰”。
該版本另有一處報告歧義:§IV-C文字說上下文數從2到4,表II卻列3到5;是否計入基礎上下文,那裡沒有清楚對齊。本文不復用其噪聲比例曲線,不猜測作者的具體口徑。它提供了候選方法,但還不是一個已充分驗證、可獨立裁定所有來源真偽的裁判。
可比的單位不是論文總分
| 研究 | 主要操作與觀察 | 不能直接證明 |
|---|---|---|
| Longpre等 | 替換實體,觀察材料遵循 | 遵循材料就是事實正確 |
| Xie等 | 改寫或組合反證,觀察答案選擇 | 單獨由連貫性導致改變 |
| Yigit-Sert | 固定題目,比較混合材料 | 一般檢索收益或普遍單調關係 |
| MACR | 增加顯式分析與規則流程 | 等預算收益或來源已被獨立核驗 |
這四行首先要對齊任務目標,其次才是模型起點、信息來源、題目劃分、調用預算和指標。前兩項主要診斷選擇行為,第三項以現實參考答案檢查錯誤,第四項還引入示例、驗證集與多次調用。直接比較它們的百分比,會把測量對象和額外資源誤認為算法差距。
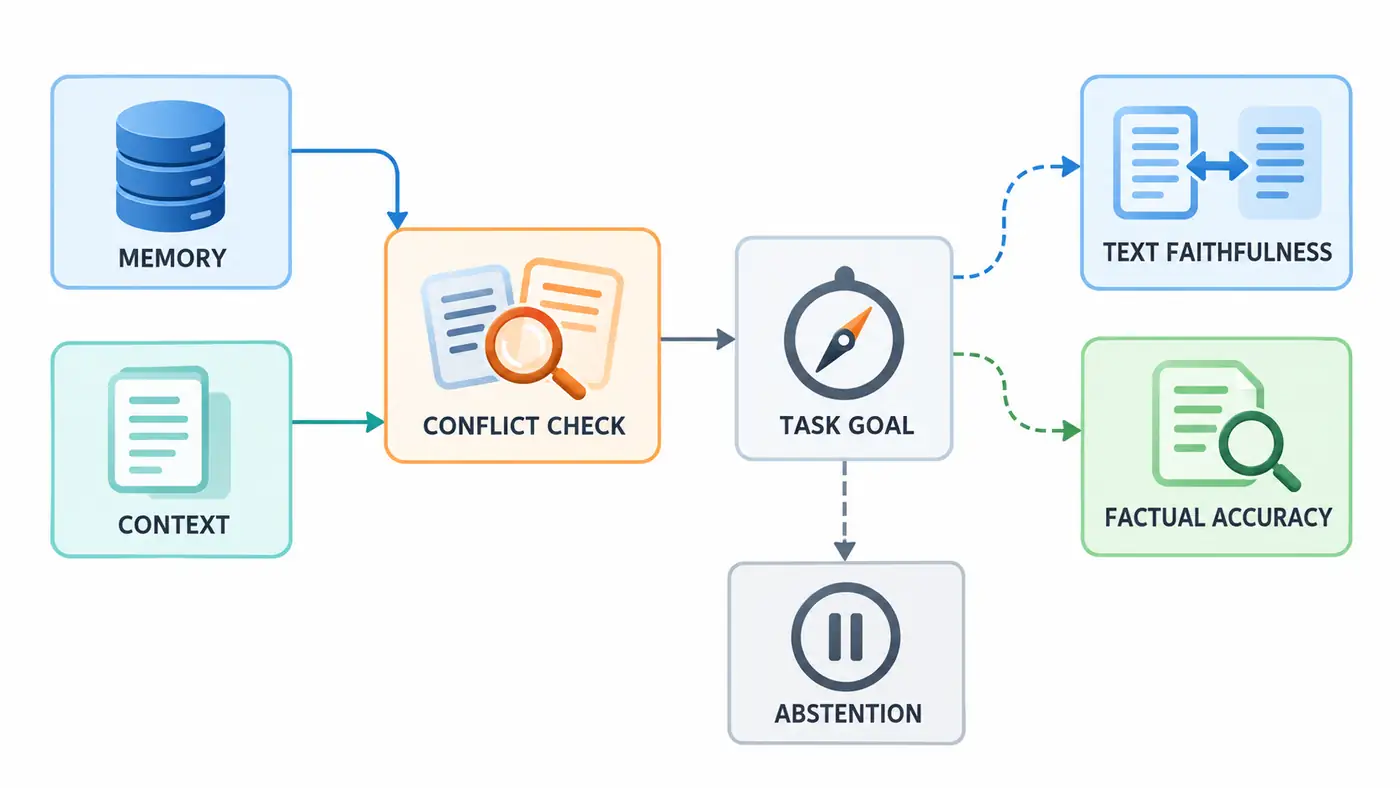
圖:本篇提出的評估框架。實線僅表示候選信息進入檢查流程;虛線表示依據任務目標選擇的評估路徑,並非已驗證的改善關係。論文觀察的是具體條件下的答案行為,圖中沒有宣稱“衝突檢查”必然提高事實準確率。暫緩作答也要單獨記錄,不能從分母中悄悄消失。
怎樣設計真正能區分解釋的實驗
以下是尚未執行的後續實驗建議。首先為同一問題準備來源和時間均可核驗的材料,標出事實在哪個時點成立。保留兩套目標:材料內答案,以及指定時間的現實答案。正確材料、過時材料、錯誤材料和證據不足材料分別成組;對於偽造內容必須清楚標記實驗用途,不能混入真實知識庫。
然後把事實內容和表面線索分開改變。固定事實命題,只交換材料順序、來源顯示方式、日期位置與表述長度;再固定這些形式屬性,改變材料是否真實。如果模型只跟隨權威名頭,交換標籤就會改變判斷;如果利用可驗證事實,行為應更能跟隨內容變化。這是可檢驗預測,不是本文已經證明的機制。
還應設置“新材料正確、舊記憶錯誤”和“新材料錯誤、舊記憶正確”兩個方向。只測試第二類,會獎勵一律拒絕材料的系統;只測試第一類,又會獎勵盲從材料的系統。對閉卷表現要重複測量,並把篩選與正式評估分開,避免偶然答對後失誤被全部解釋為材料造成的傷害。
比較裁決方法時,給單次提示、額外思考和多模塊流程相同的材料池,分別報告調用次數、輸入輸出長度與檢索成本。固定資源的比較回答效率問題;允許更多資源的比較回答可達效果問題。兩者都有價值,但不能共用一個“公平預算”的標籤。
最終應同時保存事實正確性、材料遵循、衝突識別、拒答比例以及逐題變化。拒答策略要報告覆蓋率,即系統實際回答了多少題,再看這些回答中的錯誤情況。來源真實性與時間標籤需要真實證據和明確標註流程,不能讓被測模型自己生成答案、自己確認真實性,最後再自己宣佈糾錯成功。
總結:信任應當落在可核驗的命題上
面對衝突,值得追問的不是模型有沒有堅持己見,而是它憑什麼改變、改變後符合哪個目標。可靠新證據可以糾正過時答案,錯誤材料也可以誘發同樣的改口;一段流暢解釋不能替代來源核驗。
現有證據支持把材料構造、任務約定和評測分母放回結論中。下一步真正有區分力的問題是:當事實內容與來源外觀被分別干預後,系統還能否在兩個方向都正確更新,並在證據不足時恰當地暫緩回答。這樣的結果,才更接近回答“應該相信誰”。
參考資料
- Shayne Longpre, Kartik Perisetla, Anthony Chen, Nikhil Ramesh, Chris DuBois, Sameer Singh. Entity-Based Knowledge Conflicts in Question Answering(2021,EMNLP正式論文)。會議頁面 · 全文
- Jian Xie, Kai Zhang, Jiangjie Chen, Renze Lou, Yu Su. Adaptive Chameleon or Stubborn Sloth: Revealing the Behavior of Large Language Models in Knowledge Conflicts(2023首次預印本,2024 ICLR正式論文)。正式全文 · 已讀arXiv v4
- Sevgi Yigit-Sert. Evaluating RAG Reliability under Clean, Misleading, and Mixed Retrieval(2026,ROMCIR工作坊,隨ECIR舉辦;非ECIR主會論文)。工作坊全文 · arXiv v1
- Huang Peng, Jiuyang Tang, Weixin Zeng, Hao Xu, Xiang Zhao. Navigating Unreliable Parametric and Contextual Knowledge: Explicit Knowledge Conflict Resolution for LLM Inference(2026,arXiv v1預印本,未確認正式錄用)。版本頁面 · 全文