日期:2026-06-22
適合讀者:正在建設企業知識庫問答、客服助手、內部合規助手、研究助理或高風險 Agent 的工程師、產品負責人和技術負責人。
摘要
前文講了混合檢索與重排:如何把關鍵詞檢索、向量檢索、融合排序和 reranker 組合成一個可評測的排序閉環。
但即使檢索鏈路做得不錯,RAG 仍然會遇到一個更關鍵的問題:什麼時候不應該直接回答?
很多系統把“拒答”當成 prompt 裡的最後一句話:
如果不知道,请说不知道。
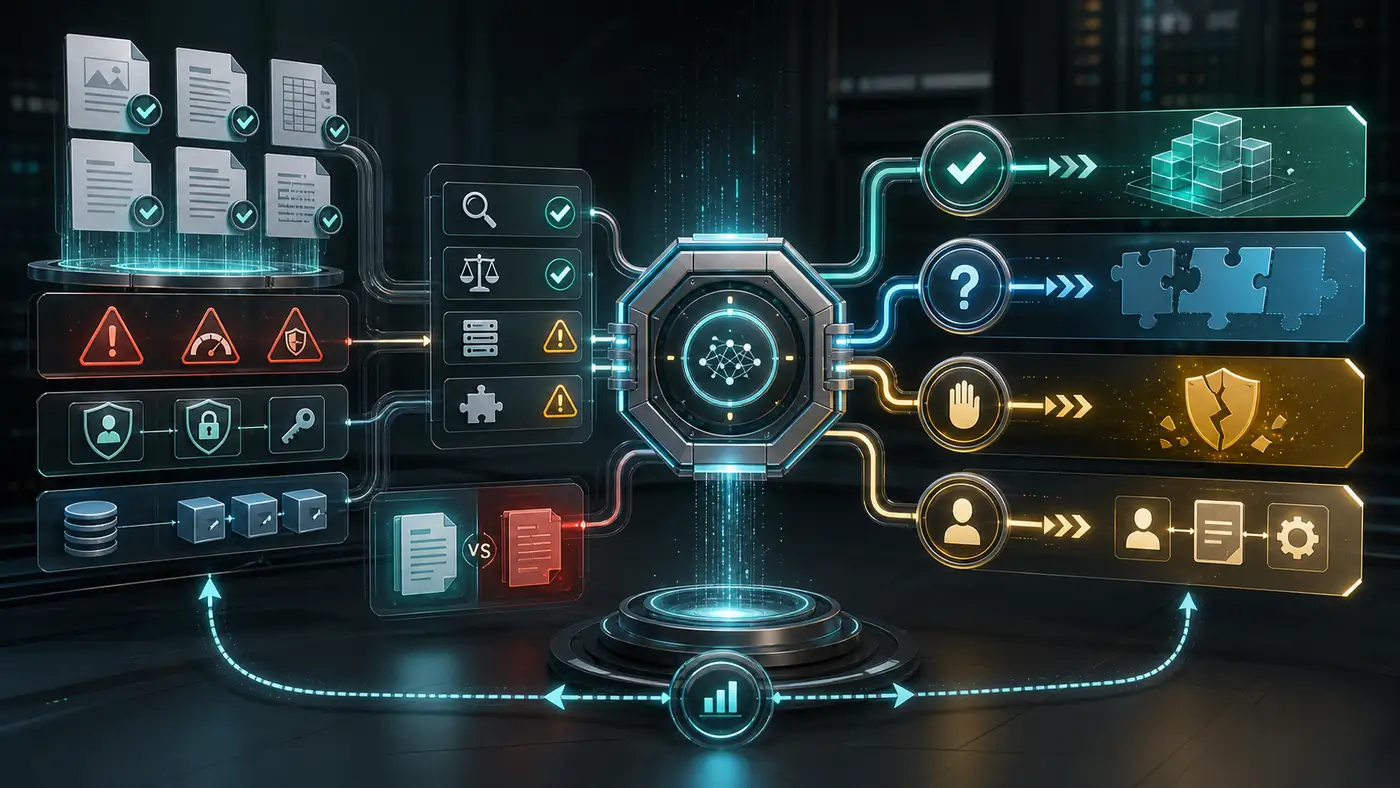
這句話有用,但遠遠不夠。生產系統真正需要的是一個低置信度決策層。它要讀取檢索結果、證據支持度、證據衝突、權限、版本、風險等級、用戶意圖完整度和工具狀態,然後在四個動作之間做選擇:
answer      证据足够,直接回答
clarify     信息缺失,先追问
abstain     证据不足或不允许回答,明确拒答
handoff     高风险或需要人工判断,转人工/转流程
這篇文章給出一套可落地的低置信度與拒答策略:置信度信號怎麼定義、證據不足和證據衝突怎麼區分、追問要問什麼、拒答怎麼寫、哪些場景必須轉人工、如何用結構化輸出承載決策、怎樣評測“少錯答”和“不過度拒答”的平衡。
目錄
- 1. 目標不是少拒答,而是少錯答
- 2. 四種動作:回答、追問、拒答、轉人工
- 3. 低置信度不是一個分數,而是一組信號
- 4. Evidence Confidence 與 Answer Confidence
- 5. 決策矩陣:從信號到動作
- 6. 什麼時候應該追問
- 7. 什麼時候應該拒答
- 8. 什麼時候應該轉人工
- 9. 用結構化輸出承載決策
- 10. 一個最小低置信度策略引擎
- 11. 回答、追問、拒答的文案模板
- 12. 如何評測拒答策略是否有效
- 13. 線上觀測與事故復盤
- 14. 生產架構建議
- 15. 常見誤區
- 16. 落地路線圖
- 17. 發佈前自檢清單
- 18. 總結
- 參考資料
1. 目標不是少拒答,而是少錯答
很多團隊上線 RAG 後,會把“拒答率”當成負指標:拒答越少越好。
這很危險。
如果系統在證據不足時仍然回答,用戶看到的是一個流暢但不可靠的答案。短期看拒答率下降,長期看信任會被消耗。客服系統會帶來錯誤承諾,合規系統會給出錯誤解釋,研究助理會把不存在的結論寫進報告,內部 Agent 可能觸發錯誤操作。
生產 RAG 的目標不是“永遠給出答案”,而是:
在证据足够时回答;
在信息缺失时追问;
在证据不足或不允许时拒答;
在高风险或需要判断时转人工。
這四個動作都應該被視為成功路徑。拒答不是失敗,錯誤回答才是失敗。追問不是拖延,它是在補齊必要條件。轉人工不是能力不足,它是風險邊界的一部分。
1.1 一個典型事故
用戶問:
企业客户提前取消年付套餐,是否可以退还剩余月份费用?
知識庫裡有三條證據:
证据 A:个人用户可以在取消后按剩余自然月退还未使用费用。
证据 B:企业客户合同以主协议为准,退款条款可能在补充协议中单独约定。
证据 C:2025 版企业客户政策已废止,2026 版政策未明确说明提前取消退款规则。
如果系統回答:
可以,企业客户提前取消后可按剩余月份退款。
這就是把個人用戶規則誤用到企業客戶。看似有證據,實則證據不支持結論。
更合適的動作是:
我不能仅凭当前知识库确认企业客户提前取消年付套餐是否可退款。现有资料显示企业客户退款以主协议或补充协议为准,而当前检索结果没有找到该客户协议中的退款条款。请提供合同编号或协议条款;如果这是正式客户承诺,建议转财务/法务确认。
這個回答沒有炫技,但它可信。
2. 四種動作:回答、追問、拒答、轉人工
RAG 的低置信度層可以先把輸出動作限定為四類。
| 動作 | 適用情況 | 用戶體驗目標 |
|---|---|---|
answer |
證據充分、無關鍵衝突、風險可控 | 給出簡潔回答,並引用證據 |
clarify |
缺少必要條件,補一個信息就能判斷 | 問一個最小必要問題 |
abstain |
知識庫沒有足夠證據,或系統不允許回答 | 明確邊界,不編造 |
handoff |
高風險、需人工審批、需訪問外部系統或判斷責任 | 把問題交給正確流程 |
這四類動作應該是系統契約,而不是自然語言風格。
推薦在生成最終用戶回覆之前,先生成一個內部決策對象:
{
  "action": "clarify",
  "confidence": 0.58,
  "risk_level": "medium",
  "evidence_status": "partial",
  "missing_information": ["customer_type", "contract_version"],
  "reason": "The retrieved policy distinguishes personal and enterprise customers, but the user did not specify the contract type.",
  "allowed_to_answer": true
}
只有當 action=answer 時,系統才進入正常答案生成。其他動作進入不同的回覆模板或工作流。
3. 低置信度不是一個分數,而是一組信號
很多系統只用一個檢索分數作為置信度。例如 reranker score 大於 0.8 就回答,小於 0.5 就拒答。
這個做法太粗。
低置信度至少來自六類信號。
3.1 檢索信號
| 信號 | 含義 |
|---|---|
top_score |
最高候選分數 |
score_margin |
第一名和第二名差距 |
recall_count |
過閾值候選數量 |
direct_support_count |
被 reranker 判為直接支持的證據數 |
query_rewrite_drift |
改寫 query 是否偏離原問題 |
source_diversity |
是否多個來源都支持同一結論 |
OpenAI Retrieval 文檔中提到,score_threshold 可以限制返回更相關的 chunk,但閾值提高也可能排除有用內容。這個提醒很重要:閾值不是越高越好,必須結合召回率、錯答率和拒答率一起調。
3.2 證據信號
| 信號 | 含義 |
|---|---|
support_type |
direct、partial、background、conflicting、irrelevant |
citation_coverage |
答案關鍵結論是否都有引用 |
missing_conditions |
是否缺少適用條件 |
version_status |
active、deprecated、draft、unknown |
freshness |
是否超過有效期 |
locator_quality |
引用是否能定位到頁碼、章節、span |
證據不是“相關文本”。證據必須能支持一個具體結論。
3.3 用戶意圖信號
| 信號 | 含義 |
|---|---|
intent_type |
事實、規則、流程、建議、操作、創作 |
required_slots |
判斷所需條件是否齊全 |
ambiguity |
用戶問題是否有多種解釋 |
user_role |
用戶身份是否影響答案 |
time_scope |
是否需要明確時間範圍 |
例如“能不能退款?”這個問題必須知道訂單類型、用戶類型、支付渠道、政策版本、是否超過期限。缺一個關鍵條件,就應該追問或給條件化答案。
3.4 風險信號
| 風險 | 示例 |
|---|---|
| 法務風險 | 合同義務、賠償、合規解釋 |
| 財務風險 | 退款金額、稅務處理、發票衝紅 |
| 醫療風險 | 診斷、用藥、檢驗解釋 |
| 安全風險 | 危險操作、權限繞過 |
| 隱私風險 | 個人數據、客戶信息、內部資料 |
| 操作風險 | 會觸發真實系統狀態變化 |
同樣的證據質量,在不同風險等級下應該有不同動作。低風險 FAQ 可以給保守答案;高風險合規問題即使有部分證據,也可能需要轉人工。
3.5 工具狀態信號
| 信號 | 含義 |
|---|---|
retrieval_status |
檢索是否成功 |
index_freshness |
索引是否剛同步 |
tool_timeout |
工具是否超時 |
permission_check |
權限檢查是否成功 |
source_availability |
原文是否可打開 |
工具失敗不能偽裝成知識不存在。檢索超時、索引未同步、權限服務失敗,應當明確降級,而不是讓模型自由發揮。
3.6 答案一致性信號
| 信號 | 含義 |
|---|---|
self_check_passed |
答案是否能逐句映射到證據 |
claim_count |
答案裡有多少獨立聲明 |
unsupported_claim_count |
多少聲明沒有證據 |
conflict_count |
多少證據互相沖突 |
policy_violation |
是否觸發內部規則 |
最終答案生成後,還要做一次證據對齊檢查。很多錯答不是檢索失敗,而是模型在生成階段多說了一句沒有證據的話。
4. Evidence Confidence 與 Answer Confidence
建議把置信度拆成兩層:
Evidence Confidence:检索到的证据是否足够支持问题?
Answer Confidence:生成出来的答案是否忠实于证据?
這兩個分數不能混在一起。
4.1 Evidence Confidence
Evidence confidence 關注檢索和證據本身。
可以考慮:
- 是否有直接支持證據;
- 直接證據數量;
- 證據是否來自 active 版本;
- 是否存在衝突證據;
- 是否缺少關鍵條件;
- 引用定位是否可核查;
- 證據是否覆蓋所有子問題;
- 檢索工具是否成功。
4.2 Answer Confidence
Answer confidence 關注生成結果。
可以考慮:
- 答案每個關鍵聲明是否有證據;
- 是否把 partial 證據寫成確定結論;
- 是否忽略了適用條件;
- 是否把舊版本寫成當前規則;
- 是否在引用之外補充了事實;
- 是否遵守拒答/轉人工策略;
- 是否把不確定性表達清楚。
很多團隊只做第一層,導致檢索證據明明是 partial,答案卻寫成 direct。真正上線時,兩層都要做。
5. 決策矩陣:從信號到動作
下面是一張實用的動作矩陣。
| 條件 | 推薦動作 | 示例 |
|---|---|---|
| 有 direct evidence,無衝突,風險低/中 | answer | 政策 FAQ、流程說明 |
| 有 direct evidence,但風險高 | answer with caveat 或 handoff | 合同、財務、醫療 |
| 只有 partial evidence,缺少關鍵 slot | clarify | 缺訂單類型、時間、版本 |
| 只有 background evidence | abstain 或 clarify | 找到背景材料但沒有規則 |
| evidence conflicting | abstain 或 handoff | 兩個 active 文檔衝突 |
| evidence deprecated | abstain,提示版本問題 | 只命中過期政策 |
| retrieval failed | abstain with system limitation | 檢索服務超時 |
| permission unknown | abstain | 權限服務失敗 |
| user asks for action requiring approval | handoff | 退款、刪除數據、改合同 |
| safety/compliance policy triggered | abstain 或 handoff | 不允許生成的請求 |
可以把矩陣變成顯式 policy,而不是藏在 prompt 裡。
5.1 一個簡化決策樹
1. 请求是否允许处理?
   no  -> abstain
2. 权限和工具状态是否正常?
   no  -> abstain or retry
3. 是否缺少必要条件?
   yes -> clarify
4. 是否有直接证据支持?
   no  -> abstain
5. 是否存在关键冲突?
   yes -> handoff or abstain
6. 风险是否高到需要人工判断?
   yes -> handoff
7. 否则 answer
注意順序。不要先問模型“你有多確定”,再去查權限。權限、政策、安全邊界應該先判斷。
6. 什麼時候應該追問
追問適用於“補一個或少數信息就能回答”的情況。
6.1 追問的好場景
| 場景 | 為什麼追問 |
|---|---|
| 缺少用戶類型 | 個人和企業規則不同 |
| 缺少產品線 | 不同產品政策不同 |
| 缺少時間範圍 | 政策版本按日期變化 |
| 缺少地區 | 法規或運營規則不同 |
| 缺少訂單狀態 | 待支付、已發貨、已完成不同 |
| 缺少目標 | 用戶問“怎麼處理”,但沒有說目標 |
例如:
用户:这个订单可以退款吗?
系统:我需要确认两个信息才能判断:这是个人订单还是企业合同订单?订单当前是未发货、已发货还是已完成?
6.2 追問要少而準
追問最常見的問題是一次問太多。
壞例子:
请提供订单号、用户类型、支付方式、订单状态、购买时间、所在地区、合同版本、产品线和退款原因。
好例子:
请先确认订单类型:这是个人订单还是企业合同订单?这会决定适用哪套退款规则。
追問的目標不是收集所有信息,而是獲取當前決策最關鍵的缺口。
6.3 可以給條件化回答,但要標清邊界
有些時候,追問之前可以先給條件化框架:
如果这是个人订单,当前政策通常按剩余未使用月份计算退款;如果这是企业合同订单,需要以主协议或补充协议为准。请确认订单类型,我再给你对应规则。
這種回答比直接拒答更有幫助,也比無條件回答更安全。
7. 什麼時候應該拒答
拒答適用於“當前系統不應回答或無法可靠回答”的情況。
7.1 證據不足
如果檢索結果沒有直接證據,系統應該明確說:
我没有在当前知识库中找到能支持这个结论的资料。
不要寫:
根据常识,可能是……
RAG 系統的價值在於基於證據回答。沒有證據時,常識猜測應該被明確降級。
7.2 證據衝突
如果兩個 active 來源衝突,不要擅自選擇一個。
我找到了两条互相冲突的现行资料:A 文档说企业客户需按主协议处理,B 文档说可按剩余月份退款。当前无法判断哪条优先级更高,建议由财务或法务确认。
這裡的關鍵是暴露衝突,而不是把衝突藏起來。
7.3 版本不確定
只命中過期文檔時,不能把它當成當前規則。
我只找到了 2025 版已废止政策,没有找到当前有效版本。不能据此确认现在的处理规则。
7.4 權限不足或隱私風險
用戶無權訪問材料時,拒答不應洩漏材料存在與內容。
我无法访问或确认你有权限查看相关资料,因此不能回答这个问题。
不要說:
有一份内部法务备忘录提到了这个条款,但你无权查看。
7.5 安全或合規不允許
這類拒答不是低置信度,而是明確不允許。語氣要簡潔,不要提供繞過路徑。
8. 什麼時候應該轉人工
轉人工適用於“系統可以發現問題,但不應該獨自完成判斷或承諾”的情況。
8.1 高風險業務承諾
例如:
- 是否承諾客戶退款;
- 是否解除合同責任;
- 是否給出法律解釋;
- 是否對醫療檢查作診斷;
- 是否批准高額補償;
- 是否修改用戶權限;
- 是否刪除或導出敏感數據。
這些場景即使有證據,也可能需要人工審批。
8.2 證據衝突但業務必須繼續
有些問題不能只拒答,因為用戶需要流程推進。系統應該轉人工,並攜帶證據包。
{
  "handoff_to": "finance_ops",
  "reason": "conflicting_active_policy",
  "evidence": [
    {"source_id": "enterprise_refund_policy_2026", "claim": "enterprise refunds follow master agreement"},
    {"source_id": "billing_faq_2026", "claim": "annual plans may refund remaining months"}
  ],
  "user_question": "企业客户提前取消年付套餐是否可退费?"
}
人工接手時最討厭從頭看對話。系統應該把問題、候選證據、衝突點、用戶缺失信息和已做判斷打包過去。
8.3 HITL 不是兜底,而是產品流程
OpenAI 的應用開發資料也強調,guardrails 和 evals 是生產級可信系統的基礎,高風險或低置信度輸出應當引入 Human-in-the-Loop。這裡的重點不是“讓人工修模型”,而是讓產品有明確責任邊界。
9. 用結構化輸出承載決策
低置信度策略不應該只靠模型生成一段自然語言。推薦先生成結構化決策,再由模板或受控生成器轉成用戶回覆。
OpenAI Structured Outputs 文檔強調,結構化輸出可以幫助應用拿到符合 JSON Schema 的結果,並且安全拒答可以被程序化檢測。這個能力很適合承載 RAG 的內部決策。
9.1 決策 schema
{
  "type": "object",
  "additionalProperties": false,
  "required": [
    "action",
    "confidence",
    "risk_level",
    "evidence_status",
    "missing_information",
    "conflicts",
    "answer_policy",
    "user_message"
  ],
  "properties": {
    "action": {
      "type": "string",
      "enum": ["answer", "clarify", "abstain", "handoff"]
    },
    "confidence": {
      "type": "number",
      "minimum": 0,
      "maximum": 1
    },
    "risk_level": {
      "type": "string",
      "enum": ["low", "medium", "high", "critical"]
    },
    "evidence_status": {
      "type": "string",
      "enum": ["direct", "partial", "background", "conflicting", "missing"]
    },
    "missing_information": {
      "type": "array",
      "items": {"type": "string"}
    },
    "conflicts": {
      "type": "array",
      "items": {
        "type": "object",
        "required": ["source_a", "source_b", "issue"],
        "properties": {
          "source_a": {"type": "string"},
          "source_b": {"type": "string"},
          "issue": {"type": "string"}
        }
      }
    },
    "answer_policy": {
      "type": "object",
      "required": ["can_answer", "must_cite", "must_handoff"],
      "properties": {
        "can_answer": {"type": "boolean"},
        "must_cite": {"type": "boolean"},
        "must_handoff": {"type": "boolean"}
      }
    },
    "user_message": {
      "type": "string"
    }
  }
}
9.2 為什麼要結構化
結構化決策有幾個好處:
- 產品可以統計 action 分佈;
- 工程可以按 action 走不同流程;
- 評測可以直接判斷動作是否正確;
- 高風險場景可以強制 handoff;
- UI 可以展示追問或轉人工狀態;
- 日誌可以復盤每次拒答原因;
- 不同模型版本可以做 A/B 對比。
自然語言答案是給用戶看的,結構化決策是給系統看的。兩者不要混在一起。
10. 一個最小低置信度策略引擎
下面是一個簡化版策略引擎。真實系統裡,分數來自檢索器、reranker、證據校驗器、風險分類器和權限服務。
from dataclasses import dataclass
from typing import List, Literal


Action = Literal["answer", "clarify", "abstain", "handoff"]
EvidenceStatus = Literal["direct", "partial", "background", "conflicting", "missing"]
RiskLevel = Literal["low", "medium", "high", "critical"]


@dataclass
class RagSignals:
    evidence_status: EvidenceStatus
    top_score: float
    direct_support_count: int
    conflict_count: int
    missing_slots: List[str]
    risk_level: RiskLevel
    retrieval_ok: bool
    permission_ok: bool
    active_version_only: bool
    unsupported_claim_count: int


@dataclass
class Decision:
    action: Action
    confidence: float
    reason: str
    missing_information: List[str]


def decide(signals: RagSignals) -> Decision:
    if not signals.permission_ok:
        return Decision(
            action="abstain",
            confidence=0.0,
            reason="Permission check failed or user lacks access.",
            missing_information=[],
        )

    if not signals.retrieval_ok:
        return Decision(
            action="abstain",
            confidence=0.1,
            reason="Retrieval failed, so absence of evidence cannot be trusted.",
            missing_information=[],
        )

    if signals.risk_level == "critical":
        return Decision(
            action="handoff",
            confidence=0.4,
            reason="Critical-risk request requires human review.",
            missing_information=signals.missing_slots,
        )

    if signals.missing_slots:
        return Decision(
            action="clarify",
            confidence=0.5,
            reason="Required information is missing.",
            missing_information=signals.missing_slots[:2],
        )

    if signals.conflict_count > 0 or signals.evidence_status == "conflicting":
        action: Action = "handoff" if signals.risk_level in ["high", "critical"] else "abstain"
        return Decision(
            action=action,
            confidence=0.35,
            reason="Retrieved evidence contains unresolved conflicts.",
            missing_information=[],
        )

    if not signals.active_version_only:
        return Decision(
            action="abstain",
            confidence=0.3,
            reason="Only deprecated or uncertain-version evidence was found.",
            missing_information=[],
        )

    if signals.evidence_status != "direct" or signals.direct_support_count == 0:
        return Decision(
            action="abstain",
            confidence=min(signals.top_score, 0.45),
            reason="No direct evidence supports the requested conclusion.",
            missing_information=[],
        )

    if signals.unsupported_claim_count > 0:
        return Decision(
            action="abstain",
            confidence=0.55,
            reason="Draft answer contains claims not supported by retrieved evidence.",
            missing_information=[],
        )

    if signals.risk_level == "high" and signals.direct_support_count < 2:
        return Decision(
            action="handoff",
            confidence=0.65,
            reason="High-risk answer needs stronger support or human approval.",
            missing_information=[],
        )

    return Decision(
        action="answer",
        confidence=max(signals.top_score, 0.75),
        reason="Direct active evidence supports the answer and no blocking risk was detected.",
        missing_information=[],
    )
這個策略引擎有幾個特點:
- 權限和工具狀態先於模型置信度;
- 缺 slot 時優先追問;
- 證據衝突不強行選擇;
- 舊版本證據不會被當作現行規則;
- 高風險問題需要更強證據或人工;
- 生成後的 unsupported claims 會阻止答案輸出。
真正上線時,可以把這些規則配置化,並按業務線設置不同閾值。
11. 回答、追問、拒答的文案模板
策略層決定動作,文案層決定用戶體驗。
11.1 answer 模板
適合證據充分時:
可以。根据《退款政策 2026-03》第 4.2 节,命中 E7782 的订单必须进入人工审核,不得自动退款。审核完成后,退款通常在 1-5 个工作日内退回原支付渠道。
要點:
- 先回答結論;
- 明確條件;
- 引用來源;
- 不擴展證據外內容。
11.2 clarify 模板
適合缺少必要條件時:
我需要先确认一个条件:这是个人订单还是企业合同订单?当前资料显示两类订单适用的退款规则不同。
要點:
- 只問最關鍵缺口;
- 說明為什麼需要這個信息;
- 不把用戶推回複雜表單。
11.3 abstain 模板
適合證據不足時:
我不能根据当前知识库确认这个结论。检索结果只包含个人订单退款规则,没有找到企业合同订单提前取消时的退款条款。
要點:
- 明確不能回答什麼;
- 說明原因;
- 不編造替代答案;
- 如可能,給出下一步。
11.4 handoff 模板
適合高風險或人工審批時:
这个问题涉及企业合同退款承诺,需要财务或法务确认。我已整理出相关资料:当前政策说明企业客户以主协议为准,但知识库没有找到该客户合同的具体退款条款。建议转财务运营处理。
要點:
- 說明為什麼轉人工;
- 帶上已經找到的證據;
- 不讓用戶重複提供信息;
- 給出明確流轉對象。
12. 如何評測拒答策略是否有效
低置信度策略必須評測,否則很容易走向兩個極端:
- 過度自信:錯答少量但嚴重;
- 過度保守:大量可答問題被拒答。
12.1 樣本集設計
評測集至少包含這些桶:
| 樣本桶 | 期望動作 |
|---|---|
| 證據充分的普通問題 | answer |
| 缺少關鍵條件的問題 | clarify |
| 知識庫沒有答案的問題 | abstain |
| 只有背景證據的問題 | abstain |
| 證據互相沖突的問題 | abstain 或 handoff |
| 只有舊版本證據的問題 | abstain |
| 高風險但有部分證據的問題 | handoff |
| 權限不足的問題 | abstain |
| 檢索工具失敗模擬 | abstain with system limitation |
| 用戶惡意或不允許請求 | abstain |
12.2 指標
| 指標 | 含義 |
|---|---|
| Action Accuracy | 動作是否選對 |
| Unsafe Answer Rate | 應拒答/轉人工卻回答的比例 |
| Over-Abstain Rate | 應回答卻拒答的比例 |
| Clarification Precision | 追問是否問到關鍵缺口 |
| Handoff Precision | 轉人工是否真的必要 |
| Evidence Support Rate | answer 中關鍵聲明是否有證據 |
| Conflict Detection Rate | 衝突證據是否被識別 |
| Version Safety Rate | 舊版本是否被正確攔截 |
| User Resolution Rate | 用戶最終是否解決問題 |
12.3 成本函數
不同錯誤的成本不同。
| 錯誤 | 成本 |
|---|---|
| 應拒答卻回答 | 最高 |
| 應轉人工卻回答 | 最高 |
| 應追問卻回答 | 高 |
| 應回答卻拒答 | 中 |
| 應回答卻追問 | 低中 |
| 應拒答卻轉人工 | 中 |
評測時不要只算平均準確率。一個醫療、法務或財務系統裡,少量錯誤回答的成本可能遠高於大量保守拒答。
13. 線上觀測與事故復盤
每次 RAG 請求都應該記錄低置信度決策信號。
推薦日誌字段:
{
  "request_id": "req_20260622_001",
  "query": "企业客户提前取消年付套餐可以退款吗?",
  "action": "handoff",
  "confidence": 0.62,
  "risk_level": "high",
  "evidence_status": "partial",
  "top_score": 0.81,
  "direct_support_count": 0,
  "conflict_count": 0,
  "missing_slots": ["contract_id"],
  "retrieval_strategy": "hybrid_rrf_rerank_v3",
  "answer_policy_version": "confidence_policy_v2",
  "handoff_team": "finance_ops",
  "created_at": "2026-06-22T12:40:32+08:00"
}
線上復盤時要回答五個問題:
- 正確證據是否進入候選池?
- reranker 是否把正確證據排到前面?
- 決策層是否正確識別證據狀態?
- 生成答案是否忠實於證據?
- 用戶反饋是否說明動作選擇不合適?
沒有這些日誌,團隊只能靠猜。
14. 生產架構建議
低置信度層可以放在檢索和生成之間,也可以在生成後再做一次校驗。
User Query
  -> Input Guardrails
  -> Query Analyzer
  -> Retrieval and Reranking
  -> Evidence Classifier
  -> Risk Classifier
  -> Confidence Policy Engine
      -> answer  -> Grounded Generation -> Claim Check -> User
      -> clarify -> Clarification Template -> User
      -> abstain -> Refusal Template -> User
      -> handoff -> Handoff Package -> Human Workflow
  -> Logging and Evals
14.1 Evidence Classifier
把候選證據分成:
directpartialbackgroundconflictingirrelevant
這一步可以用 reranker、規則、LLM judge 或組合方式實現。
14.2 Risk Classifier
把請求按業務風險分級:
low:普通知識問答;medium:影響用戶操作但不產生承諾;high:財務、法務、醫療、安全、隱私;critical:可能產生不可逆操作或重大責任。
風險分類器不需要完美,但必須偏保守。
14.3 Confidence Policy Engine
這裡不建議完全交給生成模型。策略引擎應該由規則、閾值和可審計配置組成。模型可以提供證據理解和分類,但最終動作最好由產品策略控制。
14.4 Claim Check
即使 action 是 answer,生成後也要檢查答案中的關鍵聲明是否被證據支持。可以把答案拆成 claims,再逐條驗證:
[
  {
    "claim": "命中 E7782 后不得自动退款",
    "support": "supported",
    "citation": "refund_policy_2026_03#sec_4.2"
  },
  {
    "claim": "审核通常需要 1-5 个工作日",
    "support": "supported",
    "citation": "refund_policy_2026_03#sec_4.2"
  }
]
如果出現 unsupported claim,就重寫答案或改為 abstain。
15. 常見誤區
15.1 誤區一:只靠一句 prompt 處理拒答
“不知道就說不知道”是必要但不充分。系統需要結構化信號、動作矩陣、閾值、日誌和評測。
15.2 誤區二:把低分等同於不能回答
低分可能是檢索策略問題,也可能是 query 需要追問。不能簡單用低分拒答。
15.3 誤區三:把高分等同於可以回答
高分候選可能只是語義相似,不一定支持結論。還要看 direct support、衝突、版本、權限和風險。
15.4 誤區四:拒答文案太含糊
壞拒答:
抱歉,我无法回答。
好拒答:
我不能根据当前知识库确认这个结论,因为检索结果没有找到企业合同提前取消的退款条款。
15.5 誤區五:追問變成表單
追問應該問最小必要信息,不是把所有字段都扔給用戶。
15.6 誤區六:轉人工不帶上下文
沒有證據包的轉人工會增加人工成本。handoff 必須攜帶用戶問題、系統判斷、候選證據、缺失信息和衝突點。
15.7 誤區七:只看拒答率
拒答率低可能是好事,也可能是系統在胡答。要同時看 unsafe answer rate、over-abstain rate、clarification precision 和 user resolution rate。
16. 落地路線圖
第 1 周:定義動作和日誌
- 把輸出動作固定為 answer、clarify、abstain、handoff;
- 給每次請求記錄 action、confidence、risk、evidence status;
- 梳理高風險業務場景;
- 定義第一版拒答和追問模板。
第 2 周:建立證據分類
- 把檢索候選分成 direct、partial、background、conflicting、irrelevant;
- 接入版本和權限狀態;
- 記錄 direct support count 和 conflict count;
- 讓最終答案必須引用 direct evidence。
第 3 周:實現策略引擎
- 把決策矩陣寫成可配置規則;
- 缺 slot 時走 clarify;
- 衝突、高風險、critical 請求走 handoff;
- 檢索失敗、權限失敗、舊版本證據走 abstain;
- 給策略配置加版本號。
第 4 周:建立評測集
- 人工構造每類動作樣本;
- 加入線上失敗樣本;
- 評測 action accuracy、unsafe answer rate、over-abstain rate;
- 按風險等級和 query 類型分桶。
第 5 周:接入人工流程
- 設計 handoff package;
- 對接工單、客服、法務或財務流程;
- 記錄人工最終處理結果;
- 把人工改判樣本回流評測集。
17. 發佈前自檢清單
動作契約
- 系統明確支持 answer、clarify、abstain、handoff;
- 每個動作都有觸發條件;
- 每個動作都有用戶可理解的文案;
- 動作選擇寫入結構化日誌;
- 策略版本可追蹤和回滾。
證據
- 候選證據有 direct/partial/background/conflicting/irrelevant 分類;
- 答案關鍵聲明必須有引用;
- 舊版本證據不會被當成現行規則;
- 證據衝突會阻止直接回答;
- 檢索失敗不會被當成知識不存在。
追問
- 缺少關鍵 slot 時優先追問;
- 每次追問不超過 1-2 個關鍵問題;
- 追問說明為什麼需要該信息;
- 能給條件化框架時不空泛拒答;
- 追問後的上下文能繼續使用。
拒答
- 拒答說明具體邊界;
- 不洩漏用戶無權知道的資料;
- 不在拒答後提供未經證據支持的猜測;
- 不把安全拒答和低置信度拒答混淆;
- 拒答樣本進入評測集。
轉人工
- 高風險和 critical 場景有 handoff 規則;
- handoff package 包含證據、缺口和衝突點;
- 用戶不需要重複提供已知信息;
- 人工處理結果能回寫;
- 人工改判會進入後續評測。
評測
- 有 answer/clarify/abstain/handoff 四類 gold set;
- 統計 unsafe answer rate;
- 統計 over-abstain rate;
- 按風險等級分桶;
- 按 query 類型分桶;
- 策略上線前有 A/B 或回放評測。
18. 總結
RAG 的可信度不只取決於檢索和生成,還取決於系統是否知道自己的邊界。
低置信度策略的核心不是讓模型“謙虛一點”,而是建立一套可執行的決策層:把證據質量、缺失條件、衝突、權限、版本、工具狀態和風險等級轉成明確動作。能回答就回答,缺條件就追問,證據不足就拒答,高風險就轉人工。
一個實用原則是:
不要让生成模型独自决定是否该回答。
让证据、风险和产品策略共同决定。
做到這一點,RAG 系統才不會只是在正確時顯得聰明,而是在不確定時依然可靠。
下一篇可以繼續寫:RAG 的答案生成與上下文打包怎麼做:如何把證據轉成可靠回答。
參考資料
- OpenAI Developers, Retrieval guide: Ranking, checked on 2026-06-22.
- OpenAI Developers, File search guide, checked on 2026-06-22.
- OpenAI Developers, Structured model outputs, checked on 2026-06-22.
- OpenAI Developers, AI app development: Building guardrails, checked on 2026-06-22.
- OpenAI Cookbook, Practical Guide for Model Selection for Real-World Use Cases, checked on 2026-06-22.