日期:2026-06-21
適合讀者:正在建設企業知識庫問答、客服助手、內部搜索、研究助理或 Agent 檢索層的工程師、產品負責人和技術負責人。
摘要
前文講了知識庫攝取與 chunking:把原始文檔處理成可檢索、可引用、可過濾、可審計的證據單元。
這一篇解決下一個問題:證據單元已經入庫了,怎樣把正確證據穩定排到模型面前?
很多 RAG 系統的第一個版本都是“向量檢索 top-k + prompt”。這個方案適合 demo,但很快會在真實場景裡暴露問題:用戶問錯誤碼、合同條款、產品型號、表格字段、專有名詞時,向量相似度未必可靠;用戶問概念性問題、同義改寫、跨文檔總結時,純關鍵詞又太僵硬;候選召回到了以後,如果沒有重排,前 5 條經常被相似但不支持答案的 chunk 佔掉。
生產級 RAG 的檢索層不應該被理解成一個向量庫調用,而應該被理解成一條排序流水線:
Query Understanding
  -> Metadata Filter
  -> Sparse Retrieval + Dense Retrieval
  -> Hybrid Fusion
  -> Candidate Pool
  -> Reranker
  -> Diversity and Policy Filters
  -> Context Packing
  -> Eval and Fix Loop
本文給出一套可落地的混合檢索與重排方法,包含 sparse 與 dense 各自負責什麼、如何做 RRF 融合、候選池取多大、reranker 放在哪裡、怎樣處理低置信度、如何按查詢類型評測,以及一個最小 Python 排序管線示例。
目錄
- 1. 不要把 RAG 檢索理解成向量 top-k
- 2. 一條生產檢索鏈路長什麼樣
- 3. Sparse Retrieval:關鍵詞不是落後方案
- 4. Dense Retrieval:語義召回解決改寫和概念匹配
- 5. Hybrid Fusion:把不同檢索器變成一個候選池
- 6. Candidate Pool:重排前要先給足候選
- 7. Reranker:把“像”變成“能支持答案”
- 8. Query Rewrite 與 Query Decomposition
- 9. 多樣性、權限、版本和新鮮度
- 10. 分數閾值與低置信度策略
- 11. 一個最小混合檢索示例
- 12. 如何評測混合檢索是否真的更好
- 13. 生產架構建議
- 14. 常見誤區
- 15. 落地路線圖
- 16. 發佈前自檢清單
- 17. 總結
- 參考資料
1. 不要把 RAG 檢索理解成向量 top-k
向量檢索很有用,但它不是完整的檢索系統。
假設用戶問:
订单命中 E7782 时是否还能自动退款?
這個問題裡有一個很強的關鍵詞信號:E7782。如果知識庫裡有一段:
错误码 E7782 表示支付渠道返回风险拦截。命中该错误码后,退款申请必须进入人工审核,不得自动退款。
純語義向量檢索不一定把它排第一。因為向量模型可能更重視“自動退款”“人工審核”這些語義相近的段落,而不是錯誤碼本身。這個時候 BM25、字段匹配、短語匹配和精確匹配非常重要。
再看另一個問題:
客户说到账时间太久,客服应该怎么解释跨境退款?
這裡用戶沒有直接說“跨境支付訂單需人工審核”“1-5 個工作日”“原支付渠道”,但語義上明顯在問這些政策。純關鍵詞檢索可能錯過,向量檢索更適合。
生產 RAG 的關鍵不是在關鍵詞和向量之間二選一,而是承認它們解決的問題不同。
| 檢索方式 | 擅長 | 不擅長 |
|---|---|---|
| 關鍵詞 / BM25 / sparse | 錯誤碼、產品型號、合同編號、專有名詞、原文短語、字段名 | 同義改寫、概念性問題、跨句語義 |
| 向量 / dense | 同義表達、意圖匹配、概念相關、自然語言問題 | 精確符號、短字符串、罕見名詞、最新術語 |
| 元數據過濾 | 權限、租戶、版本、語言、時間、文檔類型 | 判斷內容是否真正回答問題 |
| reranker | 細粒度相關性、證據是否支持答案、排序糾偏 | 處理全庫召回,成本和延遲較高 |
所以檢索層的目標不是“取 top-k”,而是:從全量知識庫中構造一個足夠全、足夠準、可解釋、可審計的證據候選集合,再把最能支持答案的證據放進上下文。
2. 一條生產檢索鏈路長什麼樣
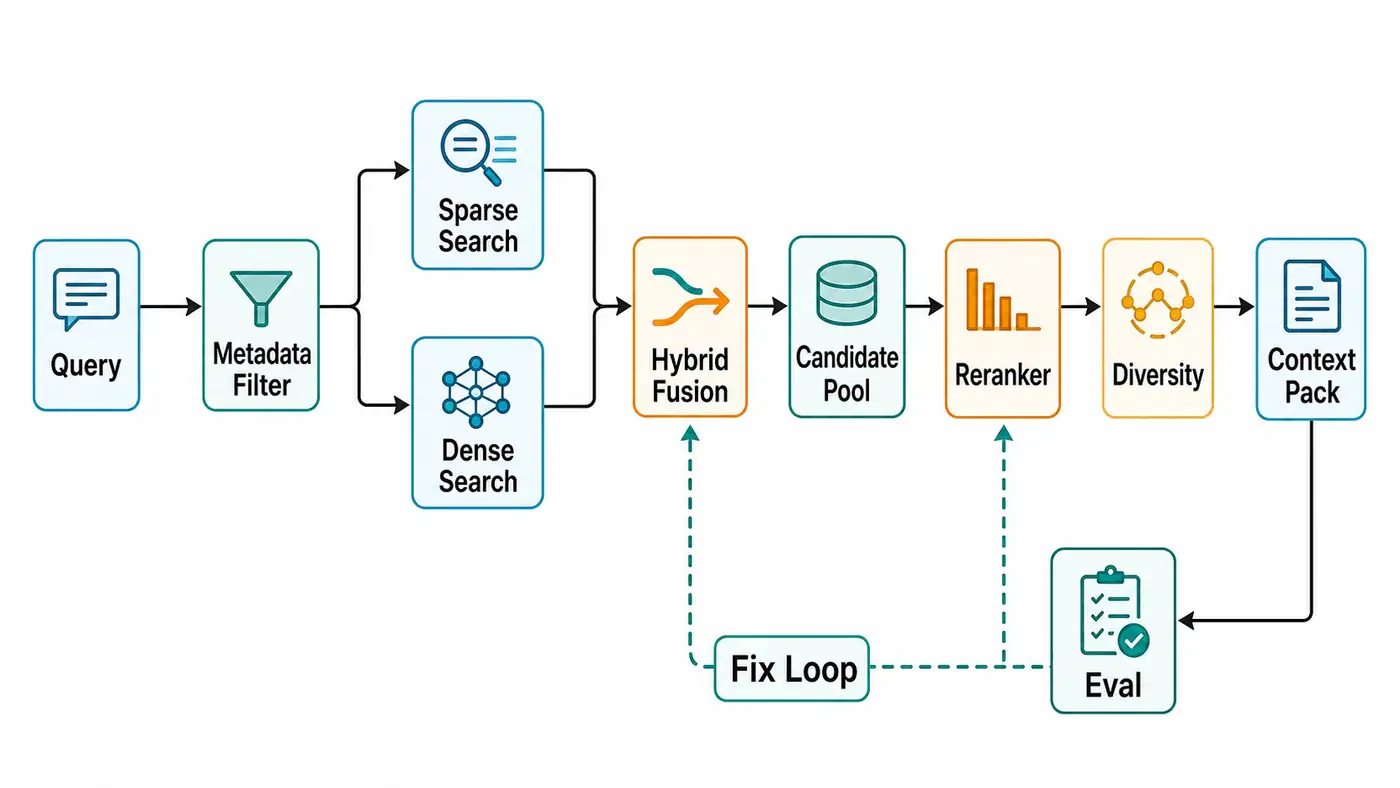
一條更可靠的 RAG 檢索鏈路通常包含這些階段。
| 階段 | 目標 | 關鍵問題 |
|---|---|---|
| Query Understanding | 理解用戶意圖、實體、時間、約束 | 用戶在問規則、事實、流程、對比還是總結? |
| Metadata Filter | 先收緊可訪問範圍 | 租戶、權限、語言、版本、狀態是否正確? |
| Sparse Retrieval | 召回精確詞面匹配 | 錯誤碼、術語、標題、字段名能否命中? |
| Dense Retrieval | 召回語義相似內容 | 同義表達和概念相關內容能否命中? |
| Hybrid Fusion | 合併不同檢索器結果 | 不同分數尺度如何融合?重複 chunk 如何處理? |
| Candidate Pool | 給 reranker 足夠候選 | 召回池是否足夠大但不失控? |
| Reranker | 重新判斷候選是否真正回答問題 | 證據和問題之間是否有直接支持關係? |
| Diversity Filter | 避免同源重複擠佔上下文 | 是否需要來源上限、MMR、相鄰 chunk 補全? |
| Context Packing | 把證據組織給生成模型 | 順序、引用、預算、衝突證據怎麼處理? |
| Eval Loop | 發現失敗模式並修復 | 哪類問題掉召回、掉排序、掉引用? |
這裡最容易被忽略的是兩個事實。
第一,metadata filter 不是可選項。企業 RAG 裡,權限和版本應該在檢索前參與過濾,而不是把不該看的證據召回後交給模型“自覺不要用”。
第二,reranker 不是召回器。reranker 更擅長在幾十條候選裡做精排,不適合直接面對百萬級語料。召回階段如果沒有把正確證據放進候選池,reranker 再強也救不了。
3. Sparse Retrieval:關鍵詞不是落後方案
Sparse retrieval 通常指 BM25、倒排索引、短語匹配、字段加權、詞項擴展等關鍵詞檢索方法。它看起來不如向量檢索“智能”,但在很多生產問題裡反而是最可靠的底座。
3.1 什麼時候必須保留關鍵詞檢索
這些查詢強烈依賴詞面匹配:
- 錯誤碼:
E7782、HTTP 429、ORA-00001 - 產品型號:
XG-2400、Pro Max、SKU-9812 - 字段名:
refund_status、effective_date - 合同條款:
第 6.2 条、force majeure - 法規編號:
GDPR Article 15、SOX 404 - 內部項目代號:
Aurora、Bridge-v2 - 人名、地名、機構名、報告標題
這些詞的語義空間未必穩定。一個錯誤碼可能沒有自然語言含義,一個 SKU 可能只是一串字符。向量檢索如果沒有足夠訓練語境,很難保證精確召回。
3.2 關鍵詞檢索不要只用正文
上一篇文章強調 chunk metadata。這裡它會直接影響關鍵詞召回質量。
推薦把這些字段納入 sparse index,並設置不同權重:
| 字段 | 作用 | 建議 |
|---|---|---|
source_title |
文檔級主題 | 高權重 |
hierarchy_path |
章節路徑 | 高權重 |
text |
證據正文 | 標準權重 |
keywords |
人工或自動抽取術語 | 中高權重 |
product_line |
產品線 | 用於過濾或加權 |
version |
版本 | 用於過濾,不建議只靠排序 |
status |
active/deprecated | 用於過濾 |
如果只把 chunk 正文放進索引,很多短 chunk 會失去上下文。例如正文只有:
不得自动退款。
但它的標題路徑是:
退款政策 > 风险拦截 > E7782 处理
檢索時標題路徑比正文更關鍵。
3.3 Sparse 檢索的工程細節
生產裡建議至少支持:
- 精確短語匹配:適合錯誤碼、條款號、標題;
- 字段加權:標題和章節路徑權重大於正文;
- analyzer 策略:中文分詞、英文大小寫歸一、符號保留;
- 同義詞表:業務別名、舊稱、新稱;
- 停用詞控制:不要把“退款”“訂單”這類領域高頻詞全部丟掉;
- query boost:當識別出錯誤碼、SKU、字段名時,提高 sparse 權重。
關鍵詞檢索不是“傳統方案”,它是 RAG 對現實世界符號系統的尊重。
4. Dense Retrieval:語義召回解決改寫和概念匹配
Dense retrieval 使用 embedding 把 query 和 chunk 映射到向量空間,再按相似度召回。它的價值在於處理用戶不會逐字複述文檔的情況。
例如知識庫裡寫的是:
跨境支付订单需进入人工审核。审核完成后,退款通常在 1-5 个工作日内退回原支付渠道。
用戶可能會問:
海外订单退款为什么不能马上到账?
這時沒有明顯的錯誤碼或條款號,dense retrieval 更容易召回正確證據。
4.1 Dense 檢索依賴 chunk 質量
如果 chunk 太長,embedding 會把多個主題混在一起;如果 chunk 太短,語義不完整。向量召回的質量不是隻由 embedding model 決定,還由這些因素共同決定:
- chunk 是否語義完整;
- 標題路徑是否進入索引文本;
- 表格是否被轉成可理解的文本;
- 舊版本是否被過濾;
- 同一文檔是否重複入庫;
- 用戶 query 是否需要改寫或拆解。
這也是為什麼前文先講攝取和 chunking。沒有好的證據單元,檢索算法只能在噪聲裡排序。
4.2 Dense 檢索的參數起點
可以從下面的配置起步,再用評測集調整。
| 場景 | dense top-n | 說明 |
|---|---|---|
| 小型 FAQ / 文檔少 | 20-40 | 候選充足即可 |
| 中型企業知識庫 | 50-100 | 給融合和重排留空間 |
| 多租戶 / 多產品線 | 每個過濾範圍 30-80 | 先過濾再召回 |
| 長文檔研究助理 | 80-150 | 需要更強去重和多樣性控制 |
不要一開始就把 top_k=5 作為檢索結果直接餵給模型。top-k 是最終上下文數量,不應該等於召回數量。召回階段要更寬,精排和上下文階段再收緊。
5. Hybrid Fusion:把不同檢索器變成一個候選池
Hybrid search 的基本思路是:同一個 query 同時跑 sparse 和 dense,再把兩個結果列表融合成一個候選池。
困難點在於,BM25 分數和向量相似度不是同一個尺度。BM25 可能是 12.7,cosine similarity 可能是 0.83。直接相加通常沒有意義。
5.1 推薦從 RRF 開始
一個實用起點是 Reciprocal Rank Fusion,簡稱 RRF。它不直接比較原始分數,而是比較排名位置。
直覺很簡單:
- 同時在 sparse 和 dense 裡排名靠前的 chunk,應該更靠前;
- 只在一個通道里排名很靠前的 chunk,也應該保留;
- 排名越靠後,貢獻越小。
常見形式:
score(doc) = sum( weight_i / (k + rank_i(doc)) )
其中 rank_i 是某個檢索器裡的排名,k 是平滑常數,常用 60 左右。權重可以按 query 類型調整。
5.2 權重不應該固定不變
同一個系統裡,不同 query 應該有不同策略。
| Query 類型 | sparse 權重 | dense 權重 | 原因 |
|---|---|---|---|
| 錯誤碼 / SKU / 條款號 | 高 | 中 | 精確符號優先 |
| FAQ 自然語言問題 | 中 | 高 | 用戶表達經常改寫 |
| 標題或文檔名搜索 | 高 | 低中 | 標題詞面很強 |
| 概念解釋 / 原理總結 | 中 | 高 | 語義相關更重要 |
| 多條件政策問題 | 中高 | 中高 | 兩者都需要 |
OpenAI Retrieval 文檔中也提供了混合檢索相關的 ranking 配置:可以通過 ranking_options.hybrid_search 調整 embedding 語義匹配和 sparse 文本匹配的權重,並通過 score_threshold 控制返回結果的最低分數。具體產品參數會變化,設計上要把這些當成可評測、可回滾的檢索策略,而不是一次性寫死。
5.3 融合前後都要去重
同一個證據可能以多個形式出現:
- 同一 source 的相鄰 chunk;
- 同一文檔不同版本;
- FAQ 和政策正文重複;
- 多語言翻譯內容重複;
- 摘要頁和原文頁重複。
融合後必須按 chunk_id、content_hash、source_id + locator 等字段去重。否則前 10 條看似很多,實際上全是同一段話的重複版本。
6. Candidate Pool:重排前要先給足候選
reranker 的前提是正確證據已經在候選池裡。候選池太小,是很多 RAG 排序失敗的根因。
一個穩妥的起點:
sparse top 80
dense top 80
metadata filter before retrieval
RRF fusion to top 80
dedupe and source cap to top 60
rerank top 60
context pack top 6-12 chunks
數字不是標準答案,但體現了一個原則:召回寬,重排窄,上下文更窄。
6.1 為什麼不能只 rerank top 10
如果 sparse 和 dense 初排都不完美,正確證據可能排在第 18、33 或 47。只 rerank top 10,會讓 reranker 看不到正確答案。
在延遲允許的情況下,建議至少 rerank 30-80 條。對於高價值、低頻、長答案問題,可以 rerank 100 條以上;對於客服實時場景,可以用緩存、輕量 reranker 或分層 rerank 控制延遲。
6.2 候選池要保留解釋字段
每個候選不僅要有文本,還要保留排序證據:
{
  "chunk_id": "refund_policy#sec_4#chunk_02",
  "source_id": "refund_policy_2026_03",
  "sparse_rank": 3,
  "dense_rank": 18,
  "fusion_score": 0.0271,
  "rerank_score": 0.84,
  "matched_terms": ["E7782", "自动退款"],
  "metadata": {
    "version": "2026-03",
    "status": "active",
    "access_scope": ["customer_service"]
  }
}
這些字段是調試和評測的生命線。線上出現錯答時,如果日誌裡只有最終 prompt,很難知道是沒召回、排錯了,還是生成模型沒用證據。
7. Reranker:把“像”變成“能支持答案”
初始召回判斷的是“這個 chunk 和 query 是否相似”。reranker 應該更進一步:判斷“這個 chunk 是否能直接支持回答這個 query”。
例如用戶問:
命中 E7782 后能否自动退款?
候選 A:
自动退款适用于低风险订单,系统会在审核通过后按原支付渠道退款。
候選 B:
错误码 E7782 表示支付渠道返回风险拦截。命中该错误码后,退款申请必须进入人工审核,不得自动退款。
A 和 query 都包含“自動退款”,相似度可能很高。但 B 才是真正支持答案的證據。reranker 的價值就在這裡。
7.1 常見 reranker 類型
| 類型 | 思路 | 優點 | 代價 |
|---|---|---|---|
| Cross-encoder reranker | 同時輸入 query 和 chunk,輸出相關性分數 | 精度強,適合精排 | 每個候選都要跑模型 |
| LLM reranker | 讓 LLM 判斷候選是否支持答案 | 可解釋,能處理複雜條件 | 成本和延遲高,要防格式漂移 |
| Late interaction | 例如 ColBERT 風格的 token-level 交互 | 兼顧召回和細粒度匹配 | 系統實現更復雜 |
| 規則 reranker | 用實體、時間、版本、標題等規則加權 | 便宜、穩定、可控 | 覆蓋不了複雜語義 |
工程上常見組合是:
RRF fusion -> rule boosts -> neural reranker -> final policy filters
規則不是為了替代模型,而是把確定性約束先處理掉。例如:
- active 版本優先;
- 用戶所在產品線優先;
- 標題精確命中加權;
- 舊版本降權或過濾;
- 同一來源最多保留 2-3 條;
- 表格證據必須帶行列標題。
7.2 reranker 的輸出不要只存一個分數
如果使用 LLM 或可解釋 reranker,建議輸出結構化字段:
{
  "chunk_id": "refund_policy#sec_4#chunk_02",
  "relevance": 0.92,
  "support": "direct",
  "reason": "The chunk explicitly states that E7782 requires manual review and automatic refund is not allowed.",
  "missing": []
}
其中 support 可以分成:
direct:直接回答;partial:回答一部分;background:只是背景;conflicting:與其他證據衝突;irrelevant:無關。
最終進上下文的應該優先是 direct 和高質量 partial,而不是所有“看起來相關”的材料。
8. Query Rewrite 與 Query Decomposition
用戶 query 往往不是最適合檢索的形式。檢索前可以做 query rewrite,但要控制邊界。
8.1 Query Rewrite 適合什麼
適合:
- 口語化問題改寫成標準術語;
- 省略上下文補全;
- 中英文術語映射;
- 拼寫糾錯;
- 把長問題壓成檢索關鍵詞;
- 生成同義 query 做多路召回。
例如:
用户问题:海外订单退款为什么慢?
检索 query 1:跨境支付订单 退款 人工审核 到账时间
检索 query 2:海外订单 退款 1-5 个工作日 原支付渠道
检索 query 3:跨境退款 审核完成后多久到账
OpenAI Retrieval 文檔中提供了 rewrite_query 一類能力,用於在檢索前改寫 query。無論使用託管能力還是自建能力,都要把 rewrite 結果記錄到日誌裡,否則很難解釋為什麼召回了某些證據。
8.2 Query Decomposition 適合複雜問題
複雜問題經常包含多個子問題:
企业客户取消年付套餐时,退款金额怎么计算,是否会影响已开票金额?
這可能拆成:
- 年付套餐取消規則;
- 退款金額計算;
- 發票和財務處理;
- 企業客戶是否有特殊條款。
每個子 query 單獨召回,再融合和重排,通常比把原問題直接檢索更穩定。
但 decomposition 有一個風險:它會引入模型臆測的子問題。建議把拆解結果和原始 query 一起記錄,並在 reranker 階段要求證據仍然支持原始問題,而不是隻支持某個被改寫後的問題。
9. 多樣性、權限、版本和新鮮度
排序不是隻看相關性。RAG 的證據上下文還要滿足工程約束。
9.1 權限必須在檢索前過濾
如果用戶無權訪問某個文檔,最好在檢索層就過濾掉,而不是召回後再讓模型忽略。
必備字段:
tenant_idaccess_scopeowner_teamclassificationstatuseffective_atexpires_at
託管檢索能力通常也會支持 metadata filtering。比如 OpenAI File Search 和 Retrieval 文檔都強調可以基於文件或屬性 metadata 做過濾。自建系統也應該把 metadata filter 設計成檢索 API 的一等參數。
9.2 版本和狀態要硬過濾
如果文檔有 active / deprecated / draft 狀態,默認只檢索 active。不要把“新版本更高分”交給排序模型自然學會。
常見策略:
| 狀態 | 默認處理 |
|---|---|
| active | 可召回 |
| deprecated | 默認過濾;用戶明確問歷史版本時才召回 |
| draft | 只對內部授權用戶召回 |
| archived | 默認過濾 |
9.3 多樣性控制避免上下文被同一來源佔滿
如果 top 10 全來自同一個長文檔的相鄰 chunk,模型可能看不到另一個關鍵來源。可以設置:
- 每個
source_id最多保留 2-3 個 chunk; - 同一章節相鄰 chunk 合併或補全;
- 使用 MMR 類策略兼顧相關性和差異;
- 對沖突證據保留至少一條反例;
- 對錶格證據保留完整行列上下文。
多樣性不是為了“平均分配”,而是為了讓上下文覆蓋回答所需的不同證據角色。
10. 分數閾值與低置信度策略
很多團隊只關心“召回了什麼”,不關心“什麼時候不該回答”。
實際產品裡,低置信度問題必須有策略:
- 沒有任何候選超過閾值:拒答或追問;
- 候選分數接近但互相沖突:說明衝突並請求確認;
- 只有背景證據,沒有直接證據:給出保守回答;
- 需要用戶身份、時間或產品線才能判斷:追問;
- 命中舊版本而新版本缺失:提示無法確認最新規則。
閾值不要只用一個全局數字。不同 query 類型可以有不同閾值。
| Query 類型 | 閾值策略 |
|---|---|
| 錯誤碼 / 條款號 | 要求精確命中或強支持 |
| 概念解釋 | 可以接受多個 partial 證據 |
| 合規 / 法務 | 閾值更高,衝突時不強答 |
| 客服話術 | 允許引用政策後生成表達 |
| 數據事實 | 必須命中明確來源和時間 |
一個成熟的 RAG 系統,不是永遠回答,而是知道什麼時候回答、什麼時候追問、什麼時候拒答。
11. 一個最小混合檢索示例
下面是一個不依賴具體數據庫的最小排序框架。真實系統裡,sparse_search 可以來自 Elasticsearch / OpenSearch / Vespa / PostgreSQL FTS,dense_search 可以來自向量庫或託管檢索,rerank 可以來自 cross-encoder、LLM 或自建模型。
from dataclasses import dataclass, field
from typing import Dict, Iterable, List, Optional


@dataclass
class Candidate:
    chunk_id: str
    source_id: str
    text: str
    metadata: Dict[str, str]
    sparse_rank: Optional[int] = None
    dense_rank: Optional[int] = None
    fusion_score: float = 0.0
    rerank_score: float = 0.0
    reasons: List[str] = field(default_factory=list)


def rrf_fuse(
    result_lists: Dict[str, List[Candidate]],
    weights: Dict[str, float],
    k: int = 60,
) -> List[Candidate]:
    merged: Dict[str, Candidate] = {}

    for channel, results in result_lists.items():
        weight = weights.get(channel, 1.0)
        for rank, item in enumerate(results, start=1):
            if item.chunk_id not in merged:
                merged[item.chunk_id] = item

            candidate = merged[item.chunk_id]
            candidate.fusion_score += weight / (k + rank)

            if channel == "sparse":
                candidate.sparse_rank = rank
            elif channel == "dense":
                candidate.dense_rank = rank

            candidate.reasons.append(f"{channel}:rank={rank}")

    return sorted(merged.values(), key=lambda x: x.fusion_score, reverse=True)


def apply_policy_filters(
    candidates: Iterable[Candidate],
    user_scope: str,
    max_per_source: int = 3,
) -> List[Candidate]:
    kept: List[Candidate] = []
    source_counts: Dict[str, int] = {}

    for item in candidates:
        if item.metadata.get("status") != "active":
            continue
        if user_scope not in item.metadata.get("access_scope", "").split(","):
            continue
        if source_counts.get(item.source_id, 0) >= max_per_source:
            continue

        source_counts[item.source_id] = source_counts.get(item.source_id, 0) + 1
        kept.append(item)

    return kept


def rerank(query: str, candidates: List[Candidate]) -> List[Candidate]:
    # Replace this stub with a cross-encoder, LLM reranker, or managed reranking API.
    # Keep the interface stable so retrieval experiments are easy to compare.
    query_terms = set(query.lower().split())
    for item in candidates:
        text_terms = set(item.text.lower().split())
        overlap = len(query_terms & text_terms)
        item.rerank_score = 0.7 * item.fusion_score + 0.3 * overlap
    return sorted(candidates, key=lambda x: x.rerank_score, reverse=True)


def retrieve_for_rag(query: str, user_scope: str) -> List[Candidate]:
    sparse = sparse_search(query, top_n=80)
    dense = dense_search(query, top_n=80)

    weights = choose_weights(query)
    fused = rrf_fuse(
        {"sparse": sparse, "dense": dense},
        weights=weights,
        k=60,
    )

    filtered = apply_policy_filters(fused[:100], user_scope=user_scope)
    ranked = rerank(query, filtered[:60])

    return ranked[:10]
這個例子刻意保留了幾個接口:
choose_weights(query):按 query 類型調整 sparse / dense 權重;apply_policy_filters(...):把權限、版本、來源上限放在排序鏈路中;rerank(...):把精排能力和召回能力解耦;reasons:記錄候選為什麼被召回,便於調試。
真實系統上線前,還應該把每次請求的 query、rewrite query、filter、sparse rank、dense rank、fusion score、rerank score、最終引用都寫入可檢索日誌。
12. 如何評測混合檢索是否真的更好
前文講過 RAG 評測,這裡聚焦檢索排序本身。
不要只看“感覺答案更好”。要把檢索鏈路拆開比較:
| 實驗組 | 目的 |
|---|---|
| sparse only | 關鍵詞基線 |
| dense only | 向量基線 |
| sparse + dense fusion | 驗證混合召回是否提升 recall |
| fusion + reranker | 驗證精排是否提升 top-k |
| fusion + reranker + diversity | 驗證上下文質量是否提升 |
| rewrite + fusion + reranker | 驗證 query rewrite 是否有收益 |
12.1 指標分層
| 指標 | 看什麼 | 典型用途 |
|---|---|---|
| Recall@50 | 正確證據是否進入候選池 | 診斷召回問題 |
| Recall@10 | 正確證據是否靠前 | 診斷初排和融合 |
| MRR | 第一個正確證據排第幾 | 問答首證據質量 |
| nDCG@k | 多條證據排序質量 | 多證據答案 |
| Citation Support Rate | 最終引用是否支持答案 | 連接檢索和生成 |
| Empty / Abstain Rate | 系統拒答頻率 | 低置信度策略 |
| Latency p95 | 用戶體驗 | 線上 SLA |
| Cost per Query | 推理和檢索成本 | 規模化成本 |
12.2 必須按 query 類型切分
總平均值會掩蓋問題。至少按這些類型切:
- 精確實體類:錯誤碼、SKU、條款號;
- 政策規則類:能不能、是否允許、怎麼計算;
- 流程類:先做什麼、後做什麼;
- 對比類:A 和 B 有什麼區別;
- 摘要類:總結某文檔或某主題;
- 多跳類:需要多個來源組合;
- 低置信度類:知識庫沒有答案或權限不足。
一個系統可能總體 Recall@10 提升 3%,但錯誤碼類下降 20%。如果不分桶,你會誤以為優化成功。
12.3 評測樣本從線上失敗裡來
初始 gold set 可以人工構造,但真正有價值的樣本來自線上失敗:
- 用戶追問“不是這個意思”;
- 人工客服改寫了答案;
- 用戶點擊了“沒有幫助”;
- 引用被用戶打開後沒有支持答案;
- reranker 高分候選被人工判為無關;
- 模型回答“無法確認”但知識庫其實有答案。
每週把失敗樣本加入評測集,再比較檢索策略,就能形成真正的排序閉環。
13. 生產架構建議
一個可維護的 RAG 檢索層可以拆成這些模塊。
Client / Agent
  -> Retrieval API
      -> Query Analyzer
      -> Metadata Policy Service
      -> Sparse Index
      -> Vector Index
      -> Fusion Service
      -> Reranker Service
      -> Context Packer
      -> Retrieval Logger
  -> Generation API
  -> Evaluation Pipeline
13.1 Retrieval API 要穩定
不要讓業務代碼直接拼多個數據庫調用。建議提供一個穩定接口:
{
  "query": "命中 E7782 后能否自动退款?",
  "user": {
    "tenant_id": "global",
    "access_scope": ["customer_service"]
  },
  "filters": {
    "status": "active",
    "language": "zh-CN"
  },
  "strategy": "hybrid_rerank_v3",
  "max_context_chunks": 8
}
返回:
{
  "strategy": "hybrid_rerank_v3",
  "rewritten_queries": [
    "E7782 自动退款 人工审核",
    "错误码 E7782 退款处理规则"
  ],
  "contexts": [
    {
      "chunk_id": "refund_policy#sec_4#chunk_02",
      "source_id": "refund_policy_2026_03",
      "text": "错误码 E7782 表示支付渠道返回风险拦截。命中该错误码后,退款申请必须进入人工审核,不得自动退款。",
      "score": 0.92,
      "support": "direct",
      "citation": {
        "title": "退款政策 2026-03 版",
        "section": "4.2",
        "page": 4
      }
    }
  ]
}
這樣生成層不需要知道底層是 Elasticsearch、向量庫還是託管 file search。檢索策略可以迭代,調用契約保持穩定。
13.2 策略要可版本化
每次檢索策略調整都應該有版本號:
dense_only_v1hybrid_rrf_v1hybrid_rrf_rerank_v2hybrid_rrf_rerank_rewrite_v3
日誌和評測都記錄策略版本。否則線上表現變好或變壞時,你無法定位是哪次權重、過濾、reranker 或 chunk 變更造成的。
13.3 上下文打包是排序的一部分
最後放進 prompt 的不只是 top-k 文本。Context packing 要處理:
- 證據順序:先直接證據,再背景證據;
- 引用格式:每條證據有 source、page、section;
- 相鄰補全:必要時帶前後 chunk;
- 衝突證據:明確標註不同版本或不同條件;
- token 預算:長表格、長段落要壓縮但不能丟關鍵字段;
- 去重:重複證據不要浪費上下文窗口。
檢索排序的終點不是列表,而是一個可被生成模型可靠使用的證據包。
14. 常見誤區
14.1 誤區一:只要 embedding 模型更強,就不需要關鍵詞
embedding 再強,也不應該承擔所有精確匹配任務。錯誤碼、合同編號、字段名和條款號天然適合 sparse 檢索。
14.2 誤區二:把 raw BM25 分數和 cosine 分數直接相加
不同檢索器分數尺度不同,直接相加會讓某一側支配排序。先用 RRF 這類基於排名的融合,或者做經過驗證的分數歸一化。
14.3 誤區三:召回 top 5 直接給模型
top 5 適合最終上下文,不適合召回。召回要寬,重排要準,上下文要精。
14.4 誤區四:reranker 輸入太少
reranker 只看 top 10,很容易錯過排在 20-50 的正確證據。先把候選池做寬,再讓 reranker 工作。
14.5 誤區五:權限和版本放到 prompt 裡提醒
這會製造安全和一致性風險。權限、租戶、版本、狀態應該在檢索層過濾。
14.6 誤區六:只評測最終答案,不評測檢索過程
最終答案錯了,原因可能是沒召回、排錯、證據衝突、上下文打包錯誤,也可能是生成模型沒遵守證據。只看答案會讓修復方向變得模糊。
14.7 誤區七:所有 query 用同一套權重
錯誤碼查詢和概念解釋查詢不應該使用同一套 sparse / dense 權重。至少要按 query 類型做簡單路由。
15. 落地路線圖
第 1 周:建立可觀測基線
- 接入 sparse 和 dense 兩條召回;
- 每條候選記錄 sparse rank、dense rank、source、version、access scope;
- 建立 100-300 條人工 gold query;
- 跑 sparse only、dense only、hybrid 三組評測。
第 2 周:加入融合和過濾
- 實現 RRF 或託管 hybrid ranking;
- 加入 metadata filter;
- 加入 source cap 和去重;
- 按 query 類型調整 sparse / dense 權重;
- 輸出 Recall@50、Recall@10、MRR、nDCG。
第 3 周:加入 reranker
- 選擇 cross-encoder、LLM reranker 或託管 rerank 能力;
- rerank 30-80 條候選;
- 記錄 rerank score 和 support 類型;
- 比較 hybrid 與 hybrid + rerank。
第 4 周:打通上下文和引用
- 把 rerank 後證據打包成結構化上下文;
- 接入引用與歸因校驗;
- 對低置信度問題設計拒答和追問;
- 建立線上失敗樣本回流流程。
第 5 周:優化延遲和成本
- 緩存熱門 query 和 query rewrite;
- 對簡單 query 跳過重 reranker;
- 使用分層 rerank;
- 控制每個來源和每個答案的 token 預算;
- 按業務價值設置不同 SLA。
16. 發佈前自檢清單
上線前至少檢查這些問題。
召回
- sparse 和 dense 都可以單獨運行;
- 錯誤碼、SKU、條款號能被關鍵詞穩定召回;
- 自然語言改寫能被向量召回;
- 正確證據在 Recall@50 中表現穩定;
- chunk 標題路徑進入索引文本。
融合
- 沒有直接相加不同檢索器 raw score;
- 使用 RRF 或經過驗證的歸一化;
- query 類型會影響 sparse / dense 權重;
- 融合後按 chunk_id、source、hash 去重;
- 記錄每個候選來自哪些通道。
重排
- reranker 至少看到 30-80 條候選;
- rerank score 和支持類型寫入日誌;
- 評測 hybrid 與 hybrid + rerank 的差異;
- 低分候選不會進入最終上下文;
- 高風險場景有更嚴格閾值。
權限和版本
- tenant、access scope、status、version 在檢索層過濾;
- deprecated 文檔默認不召回;
- 用戶明確問歷史版本時才放開版本過濾;
- 文檔權限變化後索引能及時更新;
- 日誌不會洩漏無權訪問內容。
上下文
- 每條上下文都有 citation;
- 相鄰 chunk 補全不會引入無關內容;
- 同一來源不會擠佔全部上下文;
- 衝突證據能被標記;
- 生成模型能看到足夠直接證據。
評測
- 按 query 類型分桶;
- 同時看 Recall@k、MRR、nDCG、引用支持率;
- 記錄 latency p50/p95 和成本;
- 線上失敗樣本能迴流到評測集;
- 檢索策略有版本號並可回滾。
17. 總結
RAG 的檢索層不是一個向量庫 top-k 參數,而是一條排序閉環。
Sparse retrieval 負責精確符號和詞面證據,dense retrieval 負責語義改寫和概念匹配,hybrid fusion 把多個通道變成候選池,reranker 再判斷哪些證據真正支持用戶問題。metadata filter、版本控制、權限、新鮮度、多樣性和上下文打包,同樣是排序質量的一部分。
一個實用原則是:
召回要宽,重排要准,上下文要精,评测要分桶。
如果系統只在“向量 top-k”上調參,問題會反覆出現:召回不到、排錯、引用不支持、舊版本混入、低置信度強答。把檢索層工程化以後,RAG 才能從 demo 走向可維護的生產系統。
下一篇可以繼續寫:RAG 的低置信度與拒答策略怎麼做:什麼時候回答、追問和轉人工。
參考資料
- OpenAI Developers, Retrieval guide, checked on 2026-06-21.
- OpenAI Developers, File search guide, checked on 2026-06-21.
- Nandan Thakur et al., BEIR: A Heterogeneous Benchmark for Zero-shot Evaluation of Information Retrieval Models, 2021.
- Omar Khattab and Matei Zaharia, ColBERT: Efficient and Effective Passage Search via Contextualized Late Interaction over BERT, 2020.
- Thibault Formal et al., SPLADE: Sparse Lexical and Expansion Model for First Stage Ranking, 2021.
- Rodrigo Nogueira, Zhiying Jiang, Ronak Pradeep, and Jimmy Lin, Document Ranking with a Pretrained Sequence-to-Sequence Model, 2020.
- Gordon V. Cormack, Charles L. A. Clarke, and Stefan Buettcher, Reciprocal Rank Fusion Outperforms Condorcet and Individual Rank Learning Methods, 2009.