日期:2026-06-20
適合讀者:正在建設企業知識庫、文檔問答、客服助手、合規問答、研究助理或內部 Agent 的工程師、產品負責人和技術負責人。
摘要
前文講了 RAG 的引用與歸因:答案裡的關鍵結論必須能追溯到證據。
這一篇回到更底層的問題:這些證據單元從哪裡來?
很多 RAG 項目失敗,不是因為模型不夠強,也不是因為向量數據庫不好,而是知識庫攝取階段已經把材料切壞了。PDF 頁眉頁腳混進正文,表格行列關係丟失,舊版本文檔沒有廢止,權限信息沒有進入 metadata,chunk 太長導致召回不準,chunk 太短導致上下文斷裂。後面再怎麼調 prompt、reranker 和引用格式,都只能在壞證據上修補。
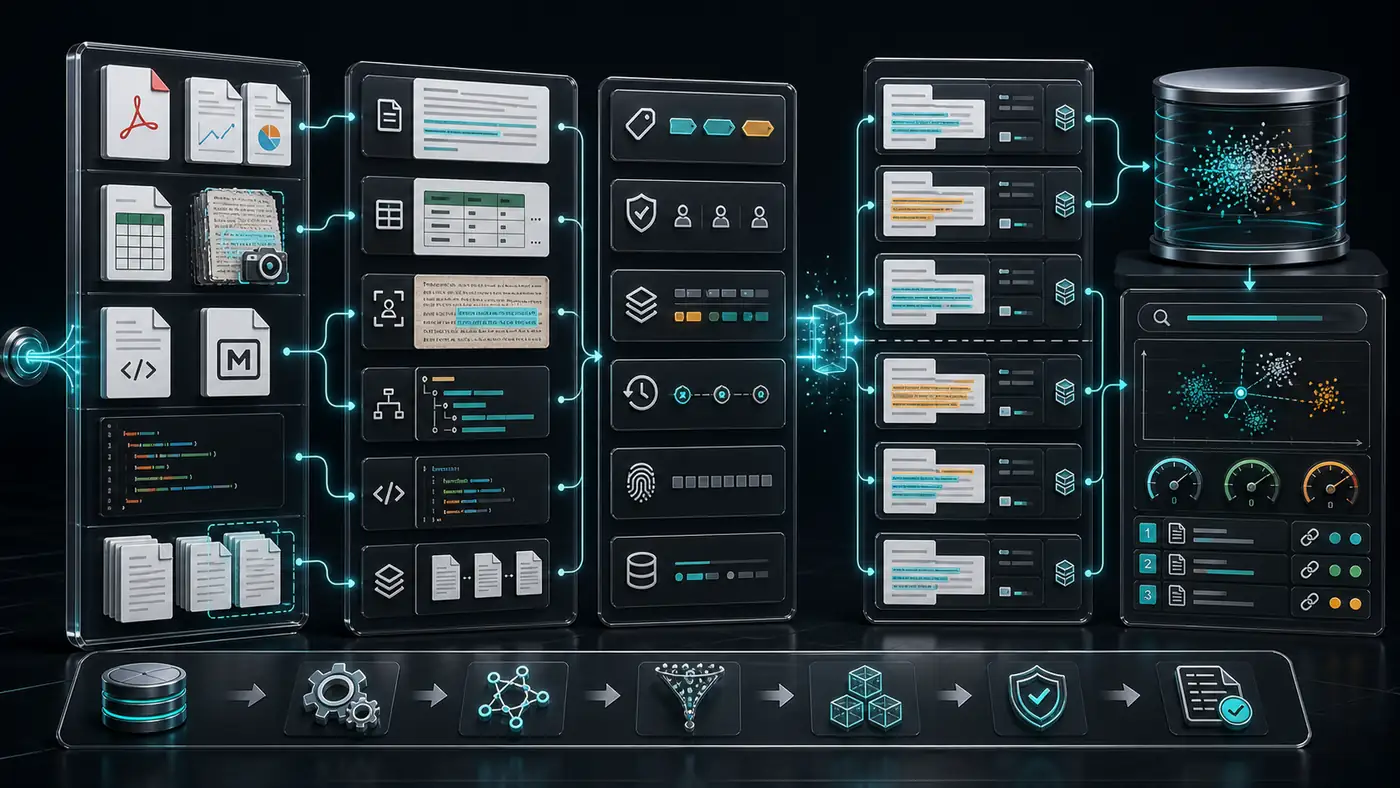
所以知識庫攝取不是“把文件上傳到向量庫”。它是一條生產流水線:盤點來源、解析文檔、規範化文本、保留結構、切分證據、補元數據、去重和版本管理、寫入索引、跑檢索評測、持續迴流失敗樣本。
本文給出一套可落地的攝取與 chunking 方法,包含證據單元 JSONL 契約、chunk 策略選擇、參數建議、表格和代碼處理、權限和版本字段、最小結構化 chunker 示例,以及上線前自檢清單。
目錄
- 1. 為什麼攝取質量決定 RAG 上限
- 2. 攝取流水線的 9 個階段
- 3. 證據單元應該長什麼樣
- 4. Chunking 不是固定長度切文本
- 5. 常見 chunk 策略怎麼選
- 6. Chunk 大小和 overlap 怎麼定
- 7. 不同文檔類型怎麼處理
- 8. Metadata 是檢索質量的一半
- 9. 去重、版本和增量更新
- 10. 一個最小結構化 chunker 示例
- 11. 如何評測 chunking 是否有效
- 12. 生產落地架構
- 13. 常見誤區
- 14. 落地路線圖
- 15. 發佈前自檢清單
- 16. 總結
- 參考資料
1. 為什麼攝取質量決定 RAG 上限
RAG 的後半段看起來更“智能”:檢索、重排、生成、引用校驗。但真正決定系統上限的,經常是最前面的攝取。
如果攝取階段把文檔處理成這樣:
退款政策
页脚:内部资料,仅供参考
表 2
人工审核 跨境支付 大额退款
1-5 个工作日
页眉:退款政策
模型後面很難穩定回答:
跨境订单是否需要人工审核?退款多久到账?
因為原始關係已經丟了。表格的行列、標題層級、版本、頁碼、權限、更新時間都沒有進入證據單元。
RAG 攝取質量差,會帶來六類問題。
| 問題 | 表現 | 根因 |
|---|---|---|
| 召回不到 | 用戶問對了,但正確內容不在 top-k | 文檔沒入庫、切分斷裂、標題丟失 |
| 召回太泛 | top-k 都相關但不精確 | chunk 太長、噪聲多、metadata 缺失 |
| 答案斷章取義 | 只引用一句話,漏了例外條件 | chunk 太短、上下文斷裂 |
| 舊版本覆蓋新版本 | 回答用過期政策 | 版本字段和廢止狀態缺失 |
| 權限洩漏 | 召回用戶無權訪問內容 | access scope 沒進檢索過濾 |
| 引用無法核查 | 用戶點開來源找不到原文 | locator、page、span、source hash 缺失 |
所以攝取流水線的目標不是“生成 embedding”,而是生成可檢索、可引用、可過濾、可審計的證據單元。
2. 攝取流水線的 9 個階段
一條可靠的知識庫攝取流水線可以拆成 9 個階段。
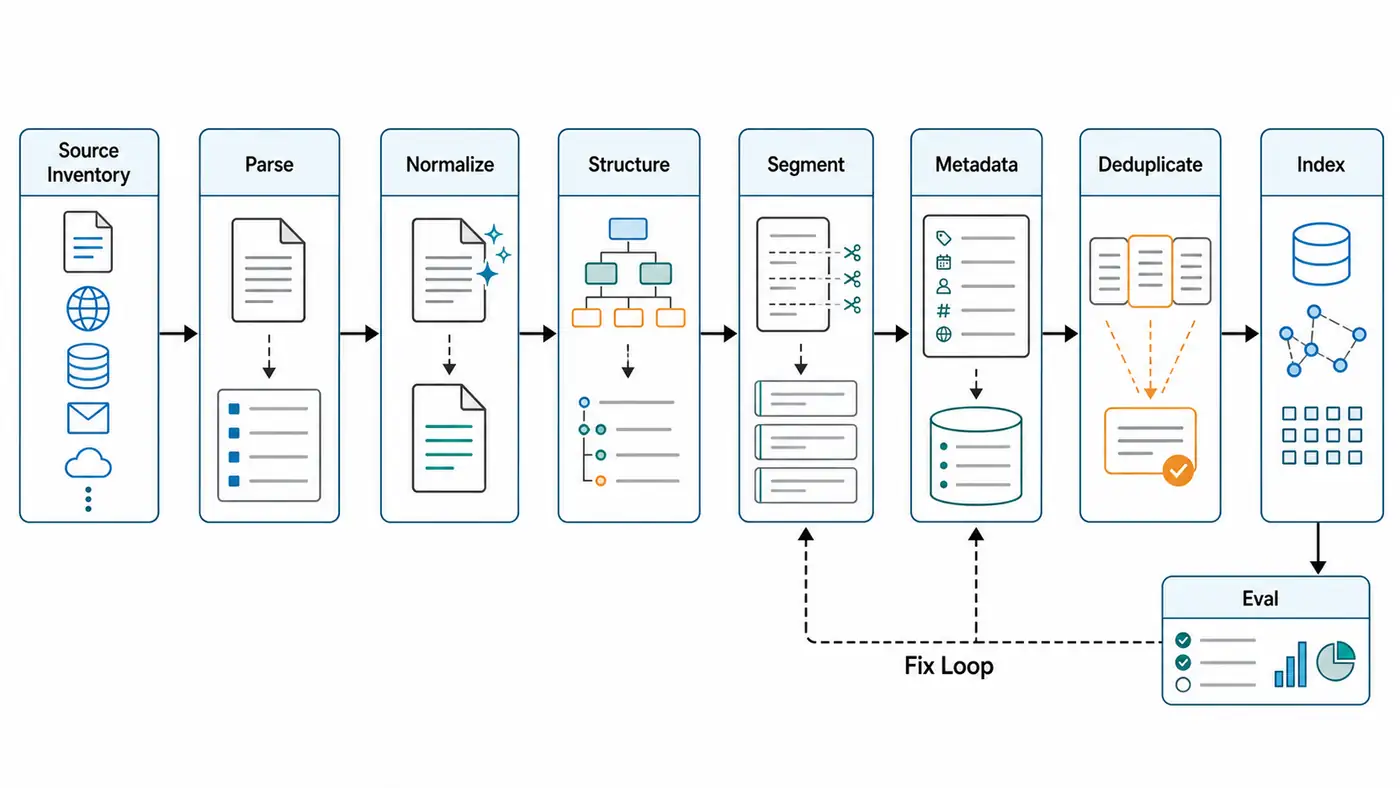
| 階段 | 目標 | 產物 |
|---|---|---|
| 1. Source Inventory | 盤點知識來源 | source registry |
| 2. Permission Mapping | 建立權限和租戶邊界 | access policy |
| 3. Parsing | 從 PDF/HTML/Docx/表格中抽取內容 | parsed blocks |
| 4. Normalization | 清洗頁眉頁腳、亂碼、重複空白 | normalized text |
| 5. Structure Recovery | 保留標題、頁碼、表格、列表、代碼塊 | structured document |
| 6. Segmentation | 切成可檢索證據單元 | evidence chunks |
| 7. Metadata Enrichment | 添加版本、權限、來源、hash、locator | chunk metadata |
| 8. Indexing | embedding、稀疏索引、向量庫寫入 | vector/search index |
| 9. Evaluation Loop | 用 gold set 檢查召回和引用質量 | eval report |
很多團隊跳過前 5 步,直接把文檔丟進默認 chunker。這在 demo 裡可以工作,但在企業知識庫裡會很快遇到邊界:
- PDF 的兩欄排版被讀錯;
- 表格被拉平成無意義文本;
- 頁眉頁腳重複汙染 embedding;
- 同一政策多個版本同時命中;
- 文檔標題和段落內容分離;
- 權限只能在回答後提醒模型,而不能在檢索前過濾。
攝取階段越認真,後面的檢索和歸因越簡單。
3. 證據單元應該長什麼樣
上一篇講引用與歸因時提到 Evidence Span。這一篇把它展開成一個可寫入索引的 evidence_chunk。
推薦每個 chunk 至少包含這些字段:
{
  "chunk_id": "refund_policy_2026_03#sec_4#chunk_02",
  "source_id": "refund_policy_2026_03",
  "source_title": "退款政策 2026-03 版",
  "source_type": "policy_doc",
  "version": "2026-03",
  "status": "active",
  "updated_at": "2026-03-18",
  "owner": "finance_ops",
  "tenant_id": "global",
  "access_scope": ["customer_service", "finance"],
  "language": "zh-CN",
  "hierarchy_path": ["退款政策", "4. 跨境退款", "4.2 人工审核"],
  "locator": {
    "page": 4,
    "section": "4.2",
    "start_char": 1832,
    "end_char": 2150
  },
  "text": "跨境支付订单需进入人工审核。审核完成后,退款通常在 1-5 个工作日内退回原支付渠道。",
  "context_prefix": "退款政策 > 跨境退款 > 人工审核",
  "content_hash": "sha256:...",
  "source_hash": "sha256:...",
  "ingested_at": "2026-06-20T22:18:24+08:00"
}
這裡有幾個關鍵點。
3.1 text 不是全部
向量索引可能主要使用 text,但系統不能只保存 text。沒有 source_id、version、access_scope、locator,後續就做不了權限過濾、版本控制和引用高亮。
3.2 context_prefix 很重要
很多 chunk 本身只有一句話:
需进入人工审核。
如果不帶標題路徑,它的語義很弱。可以在索引文本里加入輕量上下文:
退款政策 > 跨境退款 > 人工审核
需进入人工审核。
這不是給用戶看的原文,而是幫助檢索理解上下文。展示時仍然應該回到原文 span。
3.3 content_hash 和 source_hash 用來做增量更新
知識庫會變。沒有 hash,你很難判斷:
- 文檔是否真的變了;
- 哪些 chunk 需要重算 embedding;
- 舊 chunk 是否應廢止;
- 線上事故發生時用的是哪個版本。
4. Chunking 不是固定長度切文本
最常見的錯誤是把 chunking 理解成:
每 800 tokens 切一段,重叠 200 tokens。
固定長度切分有價值,尤其適合純文本和快速基線。但它不是生產 RAG 的全部。
好的 chunk 應該滿足五個條件:
| 條件 | 說明 |
|---|---|
| 語義完整 | 一個 chunk 能表達一個相對完整的事實或步驟 |
| 可召回 | 用戶問題裡的詞或語義能命中它 |
| 可引用 | 用戶點開後能理解它支持什麼 |
| 可過濾 | 帶權限、版本、來源和時間 metadata |
| 可組合 | 多個 chunk 能組成完整答案,不互相沖突 |
如果 chunk 太大,檢索會泛:
整章退款政策都被召回,但答案只需要跨境退款一条规则。
如果 chunk 太小,證據會斷:
chunk A: 跨境支付订单需进入人工审核。
chunk B: 审核完成后按原支付渠道退款。
chunk C: 退款通常在 1-5 个工作日内完成。
模型可能只看到 A,漏掉 B 和 C。
所以 chunking 的本質是證據建模,而不是字符串切片。
5. 常見 chunk 策略怎麼選
5.1 固定 token chunk
按 token 數切分,並設置 overlap。
適合:
- 快速基線;
- 結構簡單的純文本;
- 大量 FAQ;
- 對引用粒度要求不高的內部搜索。
優點是簡單穩定。缺點是容易切斷標題、表格、步驟和例外條件。
5.2 結構化 chunk
按標題、段落、列表、表格、代碼塊切分。
適合:
- 政策文檔;
- 產品手冊;
- 合同;
- API 文檔;
- 研究報告;
- 標準操作流程。
這是企業 RAG 最常用的生產策略。它會保留文檔結構:
H1: 退款政策
H2: 跨境退款
H3: 人工审核
Paragraph: 跨境支付订单需进入人工审核...
5.3 語義 chunk
按語義邊界切分,例如話題變化、段落相似度、句群聚類。
適合:
- 長報告;
- 訪談記錄;
- 會議紀要;
- 沒有清晰標題的文本。
風險是實現更復雜,而且邊界不一定穩定。生產系統裡最好保留原始 locator,避免語義切分後無法回到原文。
5.4 Parent-child chunk
索引小 chunk,展示或生成時帶 parent context。
例子:
- child chunk: 一個條款;
- parent chunk: 所在 section;
- source: 整份合同。
適合需要精確召回但又怕上下文斷裂的場景。檢索時用 child 命中,生成時把 parent 或相鄰 chunk 一起帶入。
5.5 Hierarchical chunk
把文檔構造成多層:
文档摘要
章节摘要
段落 chunk
原文 span
RAPTOR 這類方法把文本組織成樹狀摘要和檢索結構,適合長文檔、多跳問題和總結型問題。工程上可以先做簡化版:文檔級摘要、section 摘要、原文 chunk 三層。
5.6 Late chunking
常規做法是先切 chunk,再分別 embedding。Late chunking 的思路是先利用更長上下文生成 token 表徵,再對 chunk 聚合,從而讓每個 chunk embedding 保留更多上下文信息。
它適合長上下文 embedding 能力較強、文檔內部指代關係多的場景。落地時要注意成本、模型支持和可復現性,不要在沒有 eval 的情況下直接替換基線。
5.7 Graph-aware chunk
如果文檔之間存在實體、關係和社區結構,可以在 chunk 外再建圖。GraphRAG 這類方法適合跨文檔綜合、組織知識圖譜和 query-focused summarization。
但它不替代普通 chunking。圖結構依賴底層證據單元,如果 chunk 本身質量差,圖上只是組織了壞證據。
6. Chunk 大小和 overlap 怎麼定
OpenAI Retrieval 文檔給出一個實用基線:默認 max_chunk_size_tokens 是 800,chunk_overlap_tokens 是 400;可以通過 chunking_strategy 調整。當前限制是 max_chunk_size_tokens 需要在 100 到 4096 之間,overlap 不能超過 chunk size 的一半。
這個默認值適合做第一版,但不要把它當成永遠正確。
6.1 先按任務類型定範圍
| 場景 | 建議 chunk 範圍 | overlap | 說明 |
|---|---|---|---|
| FAQ / 短問答 | 100-300 tokens | 0-50 | 一個問答就是一個證據單元 |
| 政策條款 | 300-800 tokens | 50-200 | 保留條件、例外和步驟 |
| 合同條款 | 400-1000 tokens | 100-250 | 條款和定義可能互相引用 |
| 技術文檔 | 300-900 tokens | 50-200 | 保留標題路徑和代碼塊 |
| 長報告 | 600-1500 tokens | 150-400 | 結合 section 摘要 |
| 表格 | 按行/區域/語義塊 | 少用 token overlap | 保留行列關係比 token 數更重要 |
| 代碼 | 按函數/類/文件結構 | 少量上下文 | 不要切斷函數簽名和實現 |
6.2 overlap 不是越大越好
overlap 的作用是防止邊界切斷語義。但 overlap 太大,會造成:
- 重複 chunk 過多;
- top-k 被同一段內容佔滿;
- embedding 存儲成本增加;
- 引用結果冗餘;
- MRR 和 Recall 看起來提升,但答案覆蓋沒有真正提升。
一個實用做法是限制同一 source 在 top-k 中的數量,或者對相鄰 chunk 做去重。
6.3 用 eval 選參數
不要憑感覺選 chunk size。至少比較這些組合:
300 / 50
600 / 100
800 / 200
800 / 400
1200 / 300
對每組跑前文說過的檢索 eval:
- Hit Rate@k;
- Recall@k;
- MRR;
- nDCG;
- Duplicate Rate;
- Citation Support;
- token 成本;
- p95 延遲。
最終選擇通常不是最高 Recall 的配置,而是召回、精度、成本和引用可讀性的折中。
7. 不同文檔類型怎麼處理
7.1 PDF
PDF 是企業 RAG 的重災區。常見問題包括:
- 兩欄排版順序錯;
- 頁眉頁腳重複;
- 腳註混入正文;
- 表格丟行列;
- 掃描件 OCR 錯;
- 頁碼和原文 locator 丟失。
建議:
- 保存頁碼和字符/座標位置;
- 去掉重複頁眉頁腳;
- 對錶格單獨抽取;
- OCR 結果要標記置信度;
- 掃描件低質量頁面進入人工修復隊列。
7.2 Word / Markdown / HTML
這些格式結構較好,優先按標題樹切分。
保留:
- H1/H2/H3;
- 列表層級;
- 表格;
- 代碼塊;
- 鏈接;
- 更新時間;
- 文檔路徑。
不要把 HTML 導航、頁腳、側邊欄一起入庫。
7.3 表格和電子表格
表格不要簡單轉成連續文本。
錯誤做法:
企业版 10% 专业版 5% 免费版 0%
更好的證據單元:
{
  "chunk_id": "pricing_2026_q2#table_sla#row_enterprise",
  "source_id": "pricing_2026_q2",
  "table": "SLA Credit",
  "row_key": "enterprise",
  "columns": {
    "plan": "企业版",
    "sla_credit": "10%",
    "notice_window": "30 天"
  },
  "text": "SLA Credit 表中,企业版的 SLA credit 为 10%,通知窗口为 30 天。"
}
檢索文本可以是自然語言化後的行,審計時仍然回到行列座標。
7.4 代碼文檔和源碼
代碼不要按固定 token 粗暴切。
適合的邊界:
- 文件;
- class;
- function;
- method;
- docstring;
- 註釋塊;
- 測試用例。
保存:
- repo;
- branch/commit;
- file path;
- symbol name;
- start line/end line;
- language;
- imports;
- dependency relation。
代碼問答的引用最好能跳到具體行號。
7.5 FAQ 和客服知識
FAQ 最適合一問一答作為 chunk。
但要注意同義問題:
{
  "canonical_question": "退款多久到账?",
  "aliases": ["钱什么时候退回来?", "退款几天到?"],
  "answer": "退款通常在 1-5 个工作日内退回原支付渠道。",
  "tags": ["refund", "payment"]
}
aliases 可以進入檢索文本,但展示時不要混淆成原文。
8. Metadata 是檢索質量的一半
前文已經講過,權限和時效性必須在檢索層處理。metadata 是實現這個目標的基礎。
OpenAI Retrieval 文檔裡提到,vector store file 可以帶 attributes,用於 attribute filtering。文檔也說明 attributes 字典有鍵數和長度限制。這提醒我們:metadata 不能隨便堆,要設計成少而關鍵的字段。
推薦最小字段:
| 字段 | 用途 |
|---|---|
source_id |
關聯原始文檔 |
chunk_id |
穩定證據單元 |
tenant_id |
租戶隔離 |
access_scope |
權限過濾 |
updated_at |
時效性 |
version |
多版本策略 |
status |
active/deprecated/draft |
source_type |
policy/contract/faq/code/table |
language |
多語言檢索 |
owner |
責任人和審核 |
content_hash |
增量更新 |
hierarchy_path |
結構上下文 |
如果平臺的 metadata key 數有限,可以把過濾必需字段放到 attributes,把展示和審計字段放到自有數據庫。
一個常見架構是:
Vector Store:
- chunk_id
- searchable text
- embedding
- minimal filter attributes

Metadata DB:
- source registry
- locator
- permissions
- version history
- source hash
- full quote
- audit info
不要把所有治理信息塞進向量庫,也不要讓向量庫成為唯一真相源。
9. 去重、版本和增量更新
9.1 去重
知識庫裡經常有重複內容:
- 同一 PDF 被上傳多次;
- Word 和 PDF 是同一文檔不同格式;
- FAQ 複製了政策條款;
- 新舊版本高度相似;
- chunk overlap 造成大量重複片段。
去重可以分三層:
| 層級 | 方法 |
|---|---|
| 文件級 | source hash |
| 段落級 | normalized text hash |
| 語義級 | embedding 相似度或 MinHash |
但不要把所有重複都刪掉。新舊版本相似但都需要保留時,應該保留版本關係,而不是去掉舊版。
9.2 版本
版本字段要回答:
- 這是 draft、active 還是 deprecated?
- 哪個版本當前生效?
- 生效日期是什麼?
- 被哪個版本替代?
- 查詢
as_of某個日期時應該命中哪個版本?
示例:
{
  "source_id": "refund_policy_2026_03",
  "version": "2026-03",
  "status": "active",
  "valid_from": "2026-03-18",
  "valid_to": null,
  "supersedes": "refund_policy_2025_10"
}
9.3 增量更新
每次知識庫更新,不應該全量重建,除非規模很小。
更好的流程:
- 計算 source hash;
- 未變化文檔跳過;
- 變化文檔重新解析;
- 對比 chunk hash;
- 新增 chunk 寫入索引;
- 刪除或廢止舊 chunk;
- 記錄變更日誌;
- 對受影響主題跑回歸 eval。
OpenAI Retrieval 文檔提到,移除 vector store 文件後,搜索結果在短時間內仍可能出現已移除內容。這類最終一致性細節在生產裡要考慮:如果是高風險知識庫,刪除或廢止後要有短暫保護策略,例如過濾 status=active,而不只依賴物理刪除。
10. 一個最小結構化 chunker 示例
下面示例演示如何把 Markdown 文檔按標題結構切成 evidence chunks。它不是完整生產實現,但展示了關鍵思路:
- 保留標題路徑;
- 給每個 chunk 生成穩定 id;
- 限制最大長度;
- 添加 metadata;
- 輸出 JSONL。
import hashlib
import json
import re
from datetime import datetime, timezone
from pathlib import Path


def sha256(text):
    return hashlib.sha256(text.encode("utf-8")).hexdigest()


def approx_tokens(text):
    # 粗略估算,生产环境应使用目标模型 tokenizer。
    chinese_chars = len(re.findall(r"[\u4e00-\u9fff]", text))
    ascii_words = len(re.findall(r"[A-Za-z0-9_]+", text))
    return chinese_chars + ascii_words


def split_markdown_blocks(markdown):
    blocks = []
    hierarchy = []
    buffer = []

    def flush():
        if buffer:
            blocks.append({
                "hierarchy_path": hierarchy[:],
                "text": "\n".join(buffer).strip()
            })
            buffer.clear()

    for line in markdown.splitlines():
        heading = re.match(r"^(#{1,6})\s+(.+)$", line)
        if heading:
            flush()
            level = len(heading.group(1))
            title = heading.group(2).strip()
            hierarchy[:] = hierarchy[: level - 1] + [title]
            continue

        if line.strip():
            buffer.append(line)
        else:
            flush()

    flush()
    return [b for b in blocks if b["text"]]


def pack_blocks(blocks, max_tokens=700):
    chunks = []
    current = []
    current_path = []
    current_tokens = 0

    for block in blocks:
        block_text = block["text"]
        block_tokens = approx_tokens(block_text)

        if current and current_tokens + block_tokens > max_tokens:
            chunks.append({
                "hierarchy_path": current_path,
                "text": "\n\n".join(current)
            })
            current = []
            current_tokens = 0

        current_path = block["hierarchy_path"]
        current.append(block_text)
        current_tokens += block_tokens

    if current:
        chunks.append({
            "hierarchy_path": current_path,
            "text": "\n\n".join(current)
        })

    return chunks


def build_chunks(path, source_meta):
    raw = Path(path).read_text(encoding="utf-8")
    source_hash = sha256(raw)
    blocks = split_markdown_blocks(raw)
    packed = pack_blocks(blocks)
    ingested_at = datetime.now(timezone.utc).isoformat()

    for index, chunk in enumerate(packed, start=1):
        context_prefix = " > ".join(chunk["hierarchy_path"])
        text = chunk["text"].strip()
        chunk_id = f"{source_meta['source_id']}#chunk_{index:04d}"

        yield {
            "chunk_id": chunk_id,
            "source_id": source_meta["source_id"],
            "source_title": source_meta["source_title"],
            "source_type": source_meta["source_type"],
            "version": source_meta["version"],
            "status": source_meta["status"],
            "updated_at": source_meta["updated_at"],
            "owner": source_meta["owner"],
            "tenant_id": source_meta["tenant_id"],
            "access_scope": source_meta["access_scope"],
            "language": source_meta.get("language", "zh-CN"),
            "hierarchy_path": chunk["hierarchy_path"],
            "context_prefix": context_prefix,
            "text": text,
            "index_text": f"{context_prefix}\n{text}" if context_prefix else text,
            "content_hash": "sha256:" + sha256(context_prefix + "\n" + text),
            "source_hash": "sha256:" + source_hash,
            "ingested_at": ingested_at
        }


if __name__ == "__main__":
    meta = {
        "source_id": "refund_policy_2026_03",
        "source_title": "退款政策 2026-03 版",
        "source_type": "policy_doc",
        "version": "2026-03",
        "status": "active",
        "updated_at": "2026-03-18",
        "owner": "finance_ops",
        "tenant_id": "global",
        "access_scope": ["customer_service", "finance"],
        "language": "zh-CN"
    }

    with Path("evidence_chunks.jsonl").open("w", encoding="utf-8") as f:
        for row in build_chunks("refund_policy.md", meta):
            f.write(json.dumps(row, ensure_ascii=False) + "\n")
生產版本還需要:
- 真正 tokenizer;
- PDF/HTML/Docx parser;
- 表格結構處理;
- locator;
- ACL 映射;
- source registry;
- embedding 寫入;
- 刪除和廢止策略;
- eval 自動化。
但這個例子已經體現核心原則:chunk 是帶上下文和治理信息的證據對象,不是純文本片段。
11. 如何評測 chunking 是否有效
評測 chunking 不能只看“切出來多少塊”。要回到業務問題。
11.1 離線檢索評測
用前文的 gold set:
{
  "query_id": "refund_001",
  "query": "跨境订单退款多久到账?什么情况需要人工审核?",
  "gold_chunk_ids": [
    "refund_policy_2026_03#sec_4#chunk_02"
  ],
  "required_facts": ["到账时间", "跨境支付需人工审核"]
}
對不同 chunk 策略跑相同查詢,比較:
- Hit Rate@k;
- Recall@k;
- MRR;
- nDCG;
- Duplicate Rate;
- Citation Support;
- token 成本;
- 檢索延遲。
11.2 引用可讀性評測
chunk 命中不等於適合引用。還要問:
- 用戶點開 citation 後,是否能直接看懂?
- quote 是否過長?
- 是否包含無關段落?
- 是否缺少必要上下文?
- 是否能高亮到原文位置?
11.3 失敗樣本歸因
把錯誤分成幾類:
| 失敗類型 | 說明 | 可能修復 |
|---|---|---|
| Missing source | 文檔沒入庫 | source inventory |
| Parse failure | 解析錯或 OCR 錯 | parser/OCR 修復 |
| Bad boundary | chunk 切斷語義 | 結構化切分 |
| Too broad | chunk 太大 | 縮小 chunk 或按 section 切 |
| Too narrow | chunk 太小 | parent-child 或 overlap |
| Lost table relation | 表格行列丟失 | 表格結構化 |
| Stale version | 舊文檔命中 | version filter |
| Permission leak | 越權召回 | metadata filter |
沒有失敗歸因,chunking 實驗會變成調參玄學。
12. 生產落地架構
推薦把攝取系統拆成幾個模塊。
Source Connectors
  -> Parser Workers
  -> Normalizer
  -> Structure Extractor
  -> Chunk Builder
  -> Metadata Enricher
  -> Quality Gate
  -> Vector Index + Keyword Index
  -> Metadata Store
  -> Retrieval Eval
12.1 Source Connectors
負責拉取:
- 文件夾;
- CMS;
- Notion/Confluence;
- Google Drive/SharePoint;
- 數據庫;
- Git repo;
- 工單系統;
- 網頁。
Connector 要記錄 source id、路徑、更新時間、owner 和權限。
12.2 Parser Workers
不同格式用不同 parser。不要用一個通用 read_text 解決所有問題。
Parser 輸出 blocks:
{
  "block_id": "b_0012",
  "type": "paragraph",
  "text": "...",
  "page": 4,
  "section": "4.2",
  "bbox": [72, 120, 520, 188]
}
12.3 Quality Gate
入庫前做質量檢查:
- 空文本比例;
- OCR 置信度;
- 重複頁眉頁腳;
- 表格解析失敗;
- chunk 太短/太長;
- 缺少權限字段;
- 缺少版本字段;
- source hash 異常;
- 非 UTF-8 文本。
質量失敗的文檔不要靜默入庫。標記為 ingestion_failed,進入修復隊列。
12.4 雙索引
不要只依賴向量索引。很多企業問題包含精確術語、編號、合同條款、錯誤碼、API 名稱。hybrid search 通常更穩。
OpenAI Retrieval 文檔也提到 ranking options 裡可以調 hybrid search 中 embedding 和 text 的權重。工程上應該把 semantic 和 keyword 的表現分開觀察。
12.5 Metadata Store
向量庫負責找相似文本,metadata store 負責治理和審計。兩者通過 chunk_id 和 source_id 關聯。
13. 常見誤區
13.1 上傳文件等於建知識庫
上傳只是開始。生產知識庫需要解析質量、權限、版本、引用定位和評測閉環。
13.2 默認 chunk 參數永遠夠用
默認參數適合起步,不適合所有文檔。FAQ、合同、表格、代碼、長報告的切分策略不同。
13.3 只保存 chunk 文本
沒有 metadata 的 chunk 不能過濾、不能審計、不能可靠引用。
13.4 表格轉文本後就完事
表格最重要的是行列關係。轉成散文後,模型可能把專業版和企業版的字段混在一起。
13.5 overlap 越大越好
overlap 會增加冗餘。它解決邊界問題,也製造重複問題。必須結合 Duplicate Rate 和 Citation Support 看。
13.6 不做版本廢止
刪除舊文檔不等於生產安全。要有 active/deprecated 狀態、valid_from/valid_to 和查詢時過濾。
13.7 不保留 locator
沒有頁碼、section、行號或 span,引用 UI 就只能跳到整篇文檔,用戶很難核查。
14. 落地路線圖
第 1 周:建立 source registry
- 盤點知識來源;
- 定義 source id;
- 保存 owner、權限、版本、更新時間;
- 標記哪些來源可以入庫。
第 2 周:做結構化解析
- 對 PDF/Docx/HTML/Markdown/表格分別解析;
- 去掉頁眉頁腳和導航噪聲;
- 保留標題樹、頁碼、表格、代碼塊。
第 3 周:生成 evidence chunks
- 定義
evidence_chunks.jsonlschema; - 按文檔類型選擇 chunk 策略;
- 添加 context_prefix;
- 生成 chunk hash 和 source hash。
第 4 周:寫入索引和 metadata store
- embedding 寫入向量索引;
- 精確字段寫入 keyword index;
- 權限、版本、locator 寫入 metadata store;
- 建立刪除和廢止流程。
第 5 周:跑 chunking eval
- 用 50-100 條業務問題標註 gold chunk;
- 比較不同 chunk size、overlap 和策略;
- 輸出失敗歸因;
- 固化一版上線閾值。
15. 發佈前自檢清單
上線前至少問完這些問題:
- 是否有 source registry,而不是散落的文件路徑?
- 每個 source 是否有 owner、更新時間、版本和權限?
- PDF 是否處理頁眉頁腳、頁碼、兩欄、OCR 和表格?
- 表格是否保留行列關係和單元格 locator?
- 每個 chunk 是否有穩定
chunk_id和source_id? - 每個 chunk 是否有
hierarchy_path、context_prefix和原文 locator? - 是否有
status=active/deprecated/draft和版本過濾? - 是否記錄
content_hash和source_hash? - 是否有增量更新和廢止策略?
- 是否針對 chunk 參數跑過 retrieval eval?
- 是否看了 Duplicate Rate、Citation Support、token 成本和延遲?
- 是否能從 citation 跳回原文位置?
- 是否有 ingestion failed 隊列,而不是靜默入庫壞文檔?
如果這些問題答不上來,知識庫還只是“文件集合”,不是生產級 RAG 知識庫。
16. 總結
RAG 的攝取與 chunking,核心不是把文本切成多段,而是把原始材料變成可檢索、可引用、可過濾、可審計的證據單元。
最小可用鏈路是:
Source Registry -> Parser -> Normalizer -> Structure Recovery -> Evidence Chunk -> Metadata -> Index -> Eval -> Fix Loop
做得好的攝取系統,會讓後面的檢索、引用和評測都變簡單。做得差的攝取系統,會把所有問題推給 prompt 和模型。
下一篇建議繼續寫:RAG 的混合檢索與重排怎麼做:從關鍵詞、向量到 reranker 的排序閉環。
參考資料
- OpenAI Developers: Retrieval
- OpenAI Developers: File search
- OpenAI Developers: Retrieval chunking section
- Sarthi et al., RAPTOR: Recursive Abstractive Processing for Tree-Organized Retrieval
- Edge et al., From Local to Global: A Graph RAG Approach to Query-Focused Summarization
- Jina AI, Late Chunking: Contextual Chunk Embeddings Using Long-Context Embedding Models