日期:2026-06-19
適合讀者:正在做企業知識庫、文檔問答、客服助手、研究助理、合規問答或內部 Agent 的工程師、產品負責人和技術負責人。
摘要
上一篇講 RAG 的檢索質量怎麼評測,核心觀點是:不要只看最終答案,要把召回、排序、上下文質量和答案歸因分開評測。
這一篇繼續往下走:RAG 的引用與歸因到底應該怎麼做?
很多系統會在答案末尾放幾個“來源鏈接”,但這不等於歸因可靠。真正有用的引用要回答三個問題:
- 這句話是誰說的?
- 它依據的是哪一段證據?
- 這段證據是否真的支持這個結論?
如果只顯示一個文檔名,用戶無法知道答案裡的哪一句來自哪裡;如果只顯示一個 chunk id,用戶無法判斷來源是否可信、過期或越權;如果只讓模型自己寫引用編號,卻不做後驗校驗,引用很容易變成裝飾。
本文給出一套工程化設計:把 RAG 輸出拆成 claim、citation、evidence span、source metadata 和 audit record;用結構化輸出約束模型;用 claim-to-citation checker 做後驗校驗;在 UI 裡把來源做成可點擊、可高亮、可審計的證據鏈。
目錄
- 1. 引用不是裝飾,而是產品契約
- 2. 三個概念:來源、證據、斷言
- 3. 引用粒度怎麼選
- 4. 一套推薦的數據結構
- 5. 讓模型輸出可校驗的答案
- 6. Claim-to-Citation 校驗怎麼做
- 7. 複雜場景:多來源、衝突、表格、摘要和權限
- 8. UI 怎麼展示引用
- 9. 線上日誌和審計記錄
- 10. 如何評測引用質量
- 11. 一個最小校驗器示例
- 12. 常見誤區
- 13. 落地路線圖
- 14. 發佈前自檢清單
- 15. 總結
- 參考資料
1. 引用不是裝飾,而是產品契約
在生產系統裡,引用至少承擔四個責任。
| 責任 | 問題 | 失敗後果 |
|---|---|---|
| 可驗證 | 用戶能不能點開證據,看見原文? | 答案無法核查 |
| 可歸責 | 答案中的結論來自哪個來源? | 出錯後無法復盤 |
| 可審計 | 系統是否記錄了當時檢索到的證據? | 線上事故無法還原 |
| 可治理 | 來源是否過期、越權、低可信? | 合規和安全風險 |
所以引用不是“美化答案”的格式,而是 RAG 系統對用戶的承諾:答案裡的關鍵結論必須能回到證據。
OpenAI File Search 文檔裡可以看到,使用文件搜索時,響應會包含 file_search_call 以及帶有 file_citation annotation 的消息;如果要分析檢索結果,還可以顯式 include file_search_call.results。這說明引用不應該只停留在自然語言層,而應該成為系統輸出的一部分。
Web Search 文檔也強調,面向用戶展示 web 結果或其中信息時,inline citations 應該清晰可見且可點擊。這個原則同樣適用於企業 RAG:引用要能被用戶看到、點開、核查。
2. 三個概念:來源、證據、斷言
引用設計最常見的問題,是把 source、evidence 和 claim 混在一起。
2.1 Source:來源
Source 是原始資料單位,例如:
- PDF 文件;
- Notion 頁面;
- 合同版本;
- 工單記錄;
- 數據庫行;
- 網頁 URL;
- 內部政策文檔。
它回答“這份材料是什麼”。
Source metadata 至少應該包含:
{
  "source_id": "refund_policy_2026_03",
  "title": "退款政策 2026-03 版",
  "source_type": "policy_doc",
  "version": "2026-03",
  "updated_at": "2026-03-18",
  "owner": "finance_ops",
  "access_scope": ["customer_service", "finance"],
  "canonical_url": "kb://policies/refund/2026-03",
  "content_hash": "sha256:..."
}
2.2 Evidence:證據
Evidence 是能支撐某個結論的最小文本或結構化片段。它可以是一個 chunk、一段原文、一個表格單元格、一條數據庫記錄,或一個文檔區域。
它回答“哪一段材料支持這個說法”。
{
  "evidence_id": "refund_policy_2026_03#chunk_09",
  "source_id": "refund_policy_2026_03",
  "page": 4,
  "section": "跨境退款",
  "span": {
    "start_char": 1832,
    "end_char": 1938
  },
  "quote": "跨境支付订单需进入人工审核,审核完成后按原支付渠道退款。",
  "retrieval_score": 0.82
}
2.3 Claim:斷言
Claim 是答案裡的一個可判斷真假的關鍵結論。
例如:
跨境支付订单需要进入人工审核。
它不是整段答案,也不是一個主題。它應該足夠小,小到可以問:“這句話能不能被某一段證據支持?”
FActScore 這類工作把長文本拆成 atomic facts,再判斷每個事實是否被可靠知識源支持。這個思路對 RAG 很有啟發:引用校驗也應該儘量做到斷言級,而不是段落級。
3. 引用粒度怎麼選
不同風險場景需要不同引用粒度。
| 粒度 | 例子 | 適合場景 | 風險 |
|---|---|---|---|
| 文檔級 | “來源:退款政策 2026-03 版” | 低風險摘要、內部知識瀏覽 | 用戶要自己翻文檔 |
| 段落級 | 引到某個 section 或 chunk | 普通知識問答、客服助手 | chunk 太長時仍難核查 |
| 句子/片段級 | 高亮原文中的一句話 | 政策、合同、醫療、財務 | 實現成本更高 |
| 字段級 | 引到表格單元格或數據庫字段 | 報表、合同字段、訂單狀態 | 需要結構化攝取 |
| 斷言級 | 每個 claim 綁定 citations | 高風險問答、審計場景 | 需要後驗校驗 |
我的建議是:
- 對低風險內部知識庫,至少做到段落級引用。
- 對政策、合同、客服流程,做到關鍵結論的片段級引用。
- 對法務、醫療、財務、合規、對外承諾,做到斷言級引用,並保留審計記錄。
不要一開始就追求所有句子都帶引用。更好的方式是標出“關鍵斷言”:
- 數字;
- 日期;
- 條件;
- 例外;
- 權利義務;
- 操作步驟;
- 對用戶產生影響的結論。
這些地方必須有可核查證據。
4. 一套推薦的數據結構
RAG 的引用系統可以用四類對象組織。
4.1 Evidence Pack
進入模型前,把檢索結果整理成 evidence pack。注意,給模型看的 evidence id 必須穩定、短、可引用。
{
  "query_id": "refund_001",
  "evidence_pack": [
    {
      "evidence_id": "E1",
      "source_id": "refund_policy_2026_03",
      "title": "退款政策 2026-03 版",
      "version": "2026-03",
      "updated_at": "2026-03-18",
      "section": "跨境退款",
      "quote": "跨境支付订单需进入人工审核,审核完成后按原支付渠道退款。",
      "access_scope": ["customer_service", "finance"],
      "source_hash": "sha256:abc..."
    },
    {
      "evidence_id": "E2",
      "source_id": "refund_policy_2026_03",
      "title": "退款政策 2026-03 版",
      "version": "2026-03",
      "updated_at": "2026-03-18",
      "section": "到账时间",
      "quote": "退款通常在 1-5 个工作日内退回原支付渠道。",
      "access_scope": ["customer_service", "finance"],
      "source_hash": "sha256:abc..."
    }
  ]
}
這裡不要只給模型一大段文本。短 id、標題、版本、quote 和來源元數據都很重要。
4.2 Answer Contract
讓模型輸出結構化答案,而不是隻輸出 Markdown。
{
  "answer": "跨境支付订单需要进入人工审核。审核完成后,退款通常会在 1-5 个工作日内退回原支付渠道。",
  "claims": [
    {
      "claim_id": "C1",
      "text": "跨境支付订单需要进入人工审核。",
      "citations": ["E1"]
    },
    {
      "claim_id": "C2",
      "text": "审核完成后,退款通常会在 1-5 个工作日内退回原支付渠道。",
      "citations": ["E1", "E2"]
    }
  ],
  "insufficient_evidence": false
}
這種結構帶來三個好處:
- 可以逐條校驗 claim;
- 可以把引用渲染成用戶可點擊 UI;
- 可以記錄審計日誌。
4.3 Citation Object
最終展示給用戶時,citation 不應該只是 E1。它應該解析成可讀來源。
{
  "citation_id": "E1",
  "label": "退款政策 2026-03 版,跨境退款",
  "source_id": "refund_policy_2026_03",
  "quote": "跨境支付订单需进入人工审核,审核完成后按原支付渠道退款。",
  "locator": {
    "page": 4,
    "section": "跨境退款",
    "start_char": 1832,
    "end_char": 1938
  },
  "url": "kb://policies/refund/2026-03#page=4",
  "updated_at": "2026-03-18"
}
4.4 Audit Record
線上出問題時,不能只看用戶看到的答案。要能還原當時系統看到了什麼。
{
  "trace_id": "rag_20260619_000431",
  "user_id_hash": "u_...",
  "query": "跨境订单退款多久到账?",
  "retrieval": {
    "queries": ["跨境订单退款多久到账", "跨境支付退款人工审核"],
    "filters": {"department": "customer_service"},
    "top_k": 8,
    "result_ids": ["E1", "E2", "E3"]
  },
  "answer_contract": "...",
  "citation_check": {
    "unsupported_claims": [],
    "missing_citations": [],
    "stale_sources": []
  },
  "model": "production-answer-model",
  "generated_at": "2026-06-19T17:57:23+08:00"
}
注意隱私和合規:日誌裡不一定保存完整用戶身份或敏感正文,但必須保存足夠的 hash、source id、版本、引用和校驗結果,方便復盤。
5. 讓模型輸出可校驗的答案
模型很擅長寫自然語言,但自然語言不適合直接做審計。一個可用的生成指令應該明確三件事。
5.1 只允許引用 evidence pack 裡的 id
你只能引用 evidence_pack 中出现的 evidence_id。
不要编造 citation id。
如果没有足够证据,设置 insufficient_evidence=true,并说明缺什么证据。
這能減少模型憑空造來源。
5.2 每個關鍵斷言必須有 citations
关键断言包括数字、日期、条件、例外、步骤、限制、权限、法律/财务/医疗影响。
每个关键断言必须放入 claims 数组,并绑定一个或多个 citations。
不要把多个无关事实塞进同一个 claim。
這能減少“整段答案只有一個引用”的問題。
5.3 不確定時降級
如果证据之间冲突,必须指出冲突来源,不要自行选择一个结论。
如果证据不足,必须输出 insufficient_evidence=true。
如果答案需要外部最新信息,而 evidence_pack 没有,必须说明无法基于当前资料回答。
這能減少“引用包裝過的幻覺”。
6. Claim-to-Citation 校驗怎麼做
模型輸出引用之後,還需要後驗校驗。一個基礎 checker 可以分四步。
6.1 解析 claims
先把答案拆成 claim。最穩的是讓模型直接輸出 claims 數組;如果歷史系統只能輸出 Markdown,可以後處理抽取關鍵斷言。
6.2 校驗 citation id 是否存在
檢查每個 citation 是否來自 evidence pack。任何不存在的 id 都是硬錯誤。
6.3 檢查 quote 是否支持 claim
支持關係可以分三層:
| 方法 | 適合場景 | 侷限 |
|---|---|---|
| 字符串/字段規則 | 精確數字、日期、訂單狀態 | 對改寫不友好 |
| 結構化比對 | 表格、數據庫、合同字段 | 需要攝取時結構化 |
| LLM judge / NLI | 開放文本、複雜歸納 | 需要校準和抽樣人工複核 |
OpenAI Graders 文檔雖然處在平臺遷移期,但其中的思想仍然有價值:評測可以用 string check、text similarity、score model、Python grader 等方式組合。對 RAG 引用來說,也可以把規則校驗和模型校驗組合起來。
6.4 對失敗 claim 做策略處理
不要只把 checker 當日志。它應該影響產品行為:
| 校驗結果 | 推薦處理 |
|---|---|
| citation id 不存在 | 拒絕展示該答案,重試或降級 |
| claim 無 citation | 刪除該 claim 或要求模型重寫 |
| citation 不支持 claim | 刪除、重寫或標記為證據不足 |
| source 過期 | 使用新版本重檢索,或提示版本衝突 |
| source 越權 | 立即阻斷,並記錄安全事件 |
在高風險場景裡,citation check 失敗不應該“帶病上線”。
7. 複雜場景:多來源、衝突、表格、摘要和權限
7.1 多來源支撐
有些結論需要多個證據共同支撐。
{
  "claim_id": "C3",
  "text": "跨境退款需要人工审核,审核后仍按原支付渠道退回。",
  "citations": ["E1", "E2"],
  "support_type": "joint"
}
這種 claim 不能只檢查單個 citation。要允許 joint support:E1 支持“人工審核”,E2 支持“原支付渠道退回”。
7.2 衝突證據
如果兩個來源衝突,不要讓模型沉默處理。
{
  "claim_id": "C4",
  "text": "关于跨境退款到账时间,当前资料存在版本冲突。",
  "citations": ["E2", "E7"],
  "conflict": true,
  "resolution": "E2 是 2026-03 版,E7 是 2025-10 版;应优先使用 E2。"
}
衝突不是壞事。壞的是系統假裝沒有衝突。
7.3 表格和數據庫字段
表格引用不要只引用整張表。最好保存單元格、行列名和篩選條件。
{
  "evidence_id": "E12",
  "source_id": "pricing_table_2026_q2",
  "locator": {
    "row_key": "enterprise",
    "column": "sla_credit",
    "sheet": "SLA"
  },
  "value": "10%",
  "quote": "enterprise / sla_credit = 10%"
}
否則用戶點開一個大表,仍然不知道答案依據哪裡。
7.4 摘要引用
摘要最容易出現“每句話都像有根據,但具體找不到原文”的問題。
推薦做法是:
- 先為原文證據建立 citation;
- 摘要句引用原文證據,而不是引用摘要中間產物;
- 如果必須引用中間摘要,也要保留摘要生成時使用的 source ids。
7.5 權限和租戶隔離
引用系統不能洩露用戶無權看到的 source title、文件名或 quote。
錯誤例子:
根据 VIP 客户折扣表,ACME 的折扣为 27%。
即使答案沒有展開文檔內容,文件名本身也可能洩露敏感信息。
正確做法是檢索前強制權限過濾,展示前再次檢查 citation 的 access_scope。權限失敗時,不應該把 citation label 發給前端。
8. UI 怎麼展示引用
好的引用 UI 不是把腳註堆在答案末尾,而是讓用戶能快速核查。
8.1 Inline citation
關鍵句旁邊顯示引用標記:
跨境支付订单需要进入人工审核 [1]。审核完成后,退款通常会在 1-5 个工作日内退回原支付渠道 [1][2]。
標記要能點擊。點擊後展示來源卡片。
8.2 Source drawer
來源卡片至少展示:
- 文檔標題;
- 版本;
- 更新時間;
- section/page;
- 原文 quote;
- 權限範圍或可見性說明;
- “打開原文”鏈接;
- “該引用支持哪一句話”。
8.3 原文高亮
如果來源是 PDF、網頁、知識庫頁面,點擊 citation 應該跳到原文位置並高亮引用片段。用戶不應該在 80 頁 PDF 裡手動找答案。
8.4 不確定性展示
如果證據不足或衝突,不要用綠色勾號假裝確定。
可以用三種狀態:
| 狀態 | 說明 |
|---|---|
| 已支持 | 引用片段直接支持 claim |
| 部分支持 | 引用支持部分事實,仍缺少另一部分 |
| 證據不足 | 沒有足夠來源支撐 |
8.5 引用不要遮擋閱讀
引用 UI 的目的不是炫技。正文要順暢,證據要能展開。對移動端尤其要避免大段腳註打斷閱讀。
9. 線上日誌和審計記錄
RAG 出錯後,最怕只剩一句用戶投訴:
它引用了错误政策。
但你不知道當時:
- 用戶問題是什麼;
- 檢索 query 被改寫成什麼;
- top-k 結果是什麼;
- 哪些證據進了上下文;
- 模型輸出了哪些 claim;
- citation checker 是否通過;
- 知識庫當時是什麼版本;
- 前端最終展示了哪些來源。
所以線上 trace 至少記錄:
| 字段 | 用途 |
|---|---|
trace_id |
關聯用戶反饋、日誌和評測 |
query |
原始問題 |
rewritten_queries |
復盤檢索 |
filters |
復盤權限和版本 |
retrieved_evidence_ids |
看召回和排序 |
context_evidence_ids |
看最終進模型的證據 |
answer_claims |
看斷言拆分 |
citations |
看引用關係 |
citation_check_result |
看是否帶病展示 |
source_hashes |
復盤知識庫版本 |
model_and_prompt_version |
迴歸測試 |
如果數據敏感,保存 hash 和 locator,必要時通過受控後臺重新取證據。不要為了省日誌,把系統變成不可審計。
10. 如何評測引用質量
ALCE 提出把帶引用的長答案從 fluency、correctness、citation quality 等維度評測;WebGPT 也把收集 references 作為幫助用戶評估事實準確性的設計之一;RARR 則展示了為已有模型輸出補充歸因並修訂不支持內容的思路。這些研究共同提醒我們:引用質量要單獨評測,而不是藏在答案滿意度裡。
一套實用指標可以這樣設計:
| 指標 | 含義 |
|---|---|
| Citation Coverage | 關鍵 claim 中有 citation 的比例 |
| Citation Support Rate | citation 實際支持 claim 的比例 |
| Unsupported Claim Rate | 沒有證據支撐卻被輸出的 claim 比例 |
| Missing Citation Rate | 應該引用但沒有引用的 claim 比例 |
| Citation Precision | 被引用證據中真正相關的比例 |
| Citation Recall | gold evidence 中被引用到的比例 |
| Over-citation Rate | 一個簡單 claim 綁定過多弱相關來源的比例 |
| Stale Citation Rate | 引用過期來源的比例 |
| Permission-safe Citation Rate | 引用沒有越權來源的比例 |
評測集要覆蓋這些樣本:
- 單證據直接支持;
- 多證據聯合支持;
- 引用部分支持;
- 引用不支持;
- 答案正確但引用錯誤;
- 答案錯誤但引用看似相關;
- 新舊版本衝突;
- 權限不足;
- 無答案問題;
- 表格字段問題;
- 摘要型問題。
如果你的 eval 裡沒有“答案對但引用錯”的樣本,系統很容易學會用相關文檔當裝飾。
11. 一個最小校驗器示例
下面這個例子只做基礎規則校驗:citation id 是否存在、claim 是否有引用、引用 quote 是否覆蓋 claim 中的關鍵短語。真實系統裡還需要語義 entailment、字段比對、LLM judge 和人工抽檢。
import json
import re
from pathlib import Path


def normalize(text):
    return re.sub(r"\s+", "", text.lower())


def keyword_overlap(claim, quote):
    claim_norm = normalize(claim)
    quote_norm = normalize(quote)

    # 真实项目应使用领域词表或实体抽取,这里只保留一个最小示例。
    tokens = re.findall(r"[\u4e00-\u9fff]{2,}|[a-zA-Z0-9%.-]+", claim)
    important = [t for t in tokens if len(t) >= 2]
    if not important:
        return 0.0

    hits = sum(1 for token in important if normalize(token) in quote_norm)
    return hits / len(important)


def check_answer(answer_contract, evidence_pack, threshold=0.5):
    evidence_by_id = {item["evidence_id"]: item for item in evidence_pack}
    errors = []
    warnings = []

    for claim in answer_contract.get("claims", []):
        claim_id = claim.get("claim_id", "<missing>")
        claim_text = claim.get("text", "")
        citations = claim.get("citations", [])

        if not citations:
            errors.append({
                "claim_id": claim_id,
                "type": "missing_citation",
                "message": "关键断言没有引用"
            })
            continue

        support_scores = []
        for citation_id in citations:
            evidence = evidence_by_id.get(citation_id)
            if evidence is None:
                errors.append({
                    "claim_id": claim_id,
                    "type": "unknown_citation",
                    "citation_id": citation_id
                })
                continue

            score = keyword_overlap(claim_text, evidence.get("quote", ""))
            support_scores.append(score)

        if support_scores and max(support_scores) < threshold:
            warnings.append({
                "claim_id": claim_id,
                "type": "weak_support",
                "best_score": round(max(support_scores), 3),
                "message": "引用可能不足以支持该断言,需要语义校验或重写"
            })

    return {
        "passed": not errors,
        "errors": errors,
        "warnings": warnings
    }


if __name__ == "__main__":
    answer_contract = json.loads(Path("answer_contract.json").read_text(encoding="utf-8"))
    evidence_pack = json.loads(Path("evidence_pack.json").read_text(encoding="utf-8"))
    print(json.dumps(check_answer(answer_contract, evidence_pack), ensure_ascii=False, indent=2))
這個 checker 很粗糙,但它說明了一個重要原則:引用必須經過程序檢查,而不能完全相信模型自己說“我引用了”。
對於高風險場景,可以再加一個 LLM judge:
你是引用校验器。判断 Claim 是否被 Evidence 直接支持。

Claim:
{{claim_text}}

Evidence:
{{quote}}

只输出 JSON:
{
  "supported": true | false | "partial",
  "reason": "一句话说明",
  "missing_fact": "如果 partial 或 false,说明缺什么"
}
LLM judge 也要評測。不要讓 judge 變成新的不可控黑盒。
12. 常見誤區
12.1 有引用就等於可信
引用可能不相關、過期、越權、斷章取義。真正要檢查的是 support relation。
12.2 只在答案末尾列來源
末尾來源列表適合進一步閱讀,不適合證明每個關鍵結論。關鍵斷言需要 inline citation。
12.3 讓模型自己編 citation id
citation id 必須來自系統提供的 evidence pack。模型不能發明來源。
12.4 引用整個 PDF
引用到 80 頁 PDF 不能算合格歸因。至少要到 section、page 或 chunk;高風險場景要到 quote/span。
12.5 忽略表格和結構化數據
很多業務答案來自表格、數據庫字段或配置項。不要把它們轉成一大段文本後丟掉行列信息。
12.6 引用 UI 不可點擊
不可點擊的引用無法核查。用戶最終只能選擇相信或不相信模型。
12.7 不保存當時的 source 版本
知識庫會更新。今天點開的來源,不一定是模型昨天回答時看到的來源。審計日誌必須記錄版本或 hash。
13. 落地路線圖
第 1 周:把 evidence id 標準化
- 為進入上下文的每個 chunk 分配短 id;
- 保留 source id、title、version、quote、locator;
- 在 prompt 中只允許引用這些 id。
第 2 周:改輸出契約
- 讓模型輸出
answer + claims + citations + insufficient_evidence; - 對關鍵斷言做粒度約束;
- 失敗時允許證據不足,而不是強行回答。
第 3 周:加引用 checker
- 檢查 citation id 是否存在;
- 檢查每個關鍵 claim 是否有引用;
- 檢查 source 是否過期或越權;
- 對弱支持 claim 做重寫、刪除或降級。
第 4 周:改 UI 和日誌
- inline citation 可點擊;
- source drawer 展示 quote 和 locator;
- 原文高亮;
- trace 保存 retrieval、context、claims、citations、checker result。
第 5 周:做引用質量 eval
- 標註一批 claim-to-evidence 樣本;
- 評測 Citation Coverage、Support Rate、Unsupported Claim Rate;
- 把用戶反饋和線上失敗樣本回流。
14. 發佈前自檢清單
上線前至少檢查這些問題:
- 每個進入上下文的證據是否有穩定
evidence_id? - 模型是否只能引用 evidence pack 中的 id?
- 關鍵斷言是否被拆成
claims? - 每個關鍵 claim 是否有 citation?
- citation 是否能解析到 source、quote、locator 和版本?
- 是否有 checker 檢查 citation id、缺失引用、弱支持、過期和越權?
- citation check 失敗時是否會阻斷、重寫或降級,而不是照常展示?
- 前端是否能點擊引用並高亮原文?
- 審計日誌是否保存 source hash、模型版本、prompt 版本和 checker 結果?
- eval set 是否包含“答案對但引用錯”“答案錯但引用看似相關”“多來源聯合支持”“無答案”和“權限不足”樣本?
如果這些問題答不上來,引用就還只是格式,不是工程能力。
15. 總結
RAG 的引用與歸因,不是給答案加幾個腳註。它是一套從數據攝取、檢索、上下文構造、模型輸出、後驗校驗、前端展示到審計日誌的完整鏈路。
最小可用設計可以概括為:
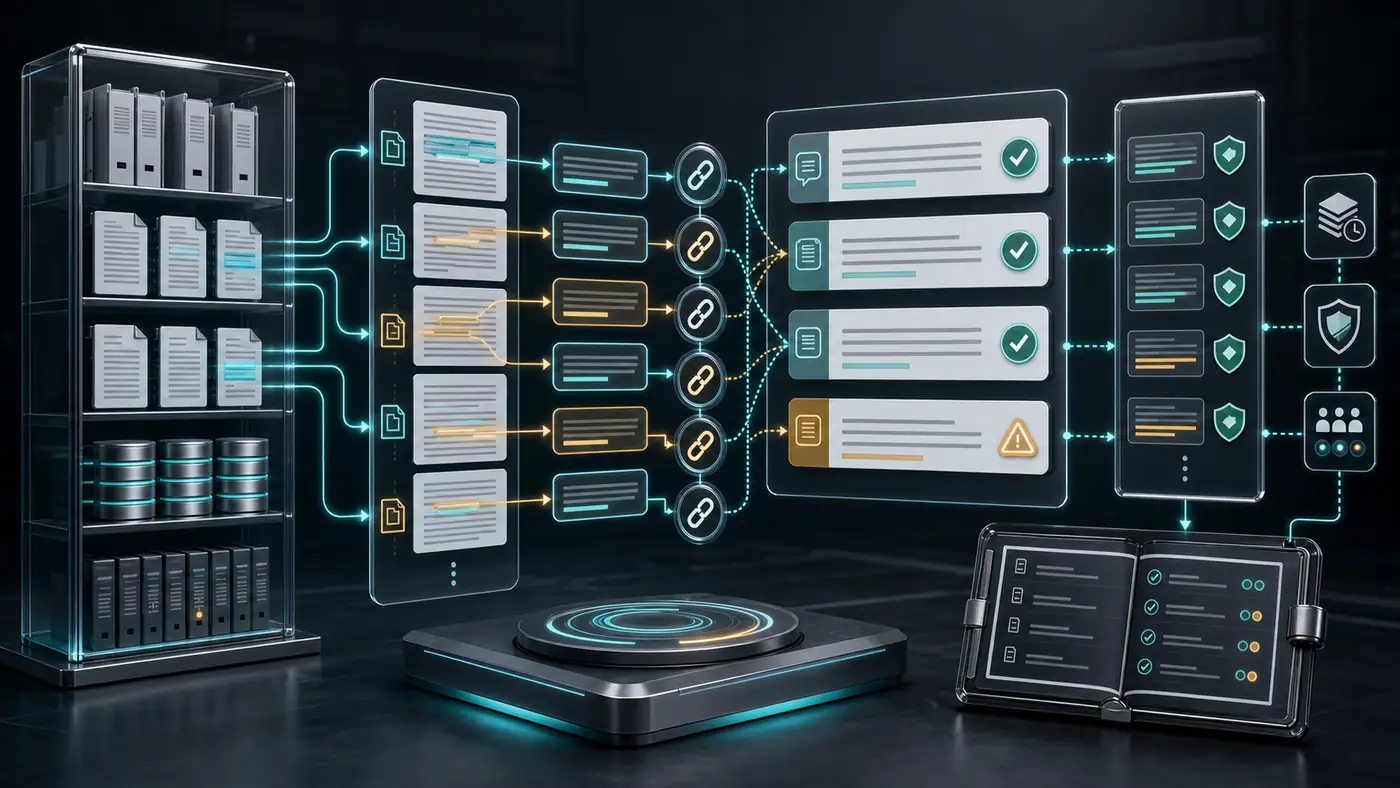
Source -> Evidence Span -> Evidence Pack -> Claim -> Citation -> Support Check -> UI Highlight -> Audit Record
只要這條鏈路斷了,RAG 就會回到“看起來有來源,但無法驗證”的狀態。
下一篇建議繼續寫:RAG 的知識庫攝取與 Chunking 怎麼做:從原始文檔到可檢索證據單元。
參考資料
- OpenAI Developers: File search
- OpenAI Developers: Retrieval
- OpenAI Developers: Web search output and citations
- OpenAI Developers: Message annotations
- OpenAI Developers: Graders
- Gao et al., Enabling Large Language Models to Generate Text with Citations
- Min et al., FActScore: Fine-grained Atomic Evaluation of Factual Precision in Long Form Text Generation
- Nakano et al., WebGPT: Browser-assisted question-answering with human feedback
- Gao et al., RARR: Researching and Revising What Language Models Say, Using Language Models