日期:2026-06-18
適合讀者:正在建設企業知識庫、文檔問答、客服助手、代碼助手、研究助理或內部 Agent 的工程師、產品負責人和技術負責人。
摘要
前三篇分別討論了 Prompt Engineering 為什麼不夠、Context Engineering 是什麼,以及上下文壓縮與排序怎麼做。這一篇進入 RAG 系統裡最容易被低估、但最決定上限的問題:檢索質量到底怎麼評測?
很多團隊上線 RAG 時只看最終答案:“答對了嗎?有沒有幻覺?”這個視角太粗。最終答案錯了,可能是檢索沒有召回正確文檔,也可能是召回了但排在第 12 位進不了上下文,還可能是證據進了上下文但模型沒有用,甚至可能是答案看起來正確卻引用了不支持結論的來源。
所以 RAG 評測要拆成三層:檢索是否找到了正確證據,排序是否把正確證據放到前面,生成是否忠實使用了證據。本文給出一套工程化評測方法:如何設計 gold set、如何算 Recall@k / MRR / nDCG / Citation Support,如何記錄權限和時效性,如何用一段可運行腳本做離線評測,以及線上應該監控哪些信號。
目錄
- 1. 為什麼不能只看最終答案
- 2. 把 RAG 鏈路拆成三層
- 3. 檢索質量的核心指標
- 4. 評測集應該怎麼設計
- 5. 一個最小 retrieval eval 數據格式
- 6. 離線評測腳本:先把問題定位清楚
- 7. 診斷矩陣:指標差時應該改哪裡
- 8. 答案層評測:不要讓模型“帶著錯引用答對”
- 9. 線上監控:離線分數不等於線上可靠
- 10. 常見誤區
- 11. 落地路線圖
- 12. 發佈前自檢清單
- 13. 總結
- 參考資料
1. 為什麼不能只看最終答案
RAG 的目標不是“讓模型看起來引用了資料”,而是讓答案能夠被外部證據支撐。
如果只看最終答案,會把不同錯誤混在一起:
| 現象 | 表面表現 | 真正可能的問題 |
|---|---|---|
| 答案錯誤 | 模型說錯政策、數字或步驟 | 檢索沒召回正確文檔;文檔過期;模型沒用證據 |
| 答案太泛 | 只給常識,沒有業務細節 | 召回結果弱相關;上下文缺少 must-have facts |
| 引用存在但不支持結論 | 看起來有來源,點開不相關 | citation 只是裝飾,沒有做支持性校驗 |
| 同一問題多次回答不穩定 | 有時對,有時錯 | top-k 排序波動;chunk 重疊噪聲大;reranker 不穩定 |
| 用戶越權看到信息 | 答案引用了不該訪問的文檔 | metadata filter 或權限層失效 |
| 舊政策覆蓋新政策 | 答案沿用舊版本 | freshness/filter/version priority 沒做進檢索層 |
這些問題不能靠“再寫一句 prompt”解決。RAG 系統必須把檢索、排序、上下文和生成拆開評測。
一句工程判斷是:
RAG 的第一性評測對象不是答案,而是“證據鏈是否成立”。
如果證據鏈不成立,答案越流暢越危險。
2. 把 RAG 鏈路拆成三層
一個典型 RAG 請求可以拆成三段:
- 檢索層:從知識庫裡找候選文檔或 chunk。
- 上下文層:對候選結果做過濾、去重、重排、壓縮和預算分配。
- 生成層:模型基於上下文回答,並給出引用或證據說明。
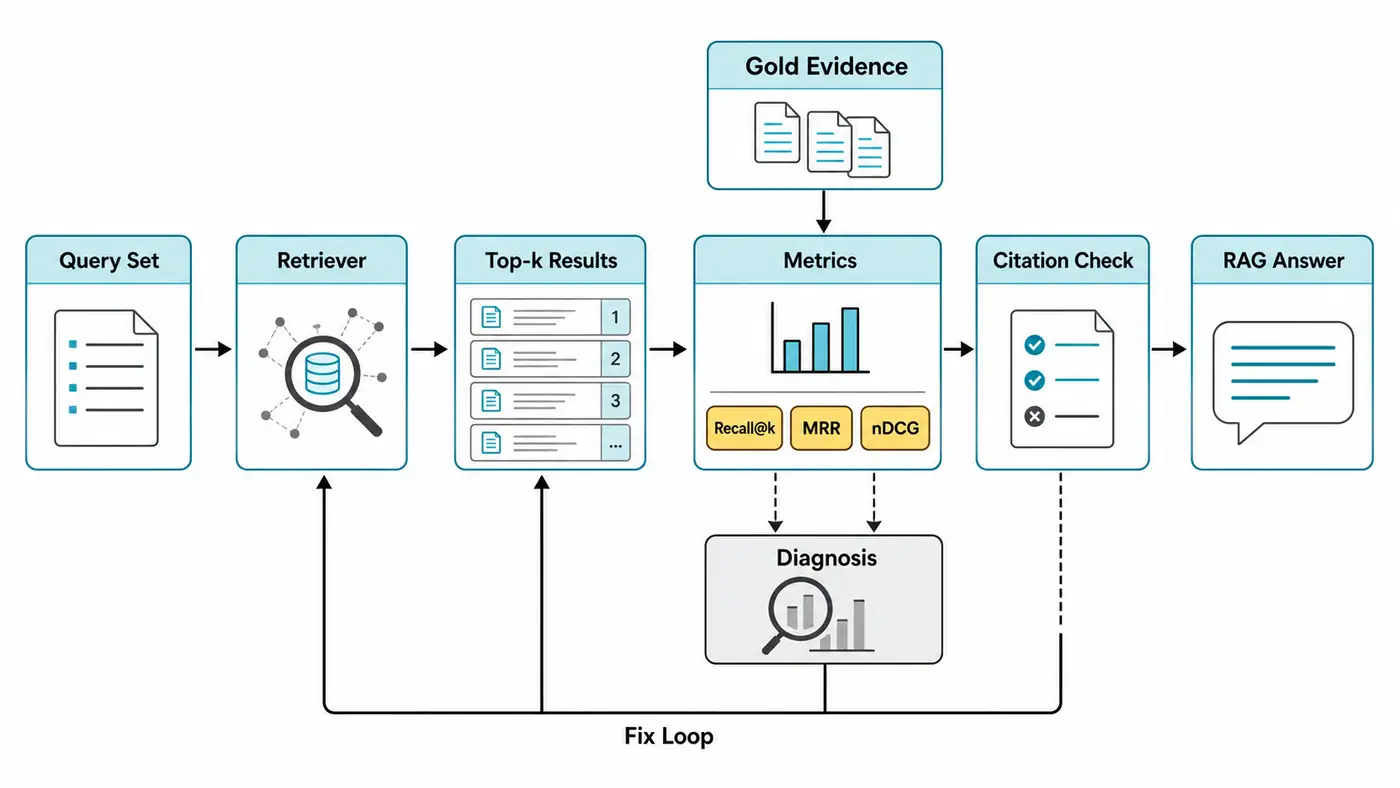
對應的評測問題也不同:
| 層級 | 應該問的問題 | 典型指標 |
|---|---|---|
| 檢索層 | 正確證據有沒有被找出來? | Recall@k、Hit Rate@k、Coverage |
| 排序層 | 正確證據是否排在足夠靠前的位置? | MRR、nDCG@k、Context Precision |
| 上下文層 | 進模型窗口的證據是否乾淨、不過期、不越權? | Duplicate Rate、Freshness、Permission Violation |
| 生成層 | 答案是否忠實、完整、可追溯? | Faithfulness、Answer Correctness、Citation Support |
OpenAI Retrieval 文檔裡提到,檢索可以做 semantic search、query rewriting、attribute filtering、ranking options,也可以限制 max_num_results。這些不是“調參小項”,而是評測實驗的變量。你應該能回答:打開 query rewrite 後 Recall@10 是否提升?把 score_threshold 提高後 Precision 是否提升但 Recall 是否下降?按部門和日期過濾後是否減少越權和過期證據?
3. 檢索質量的核心指標
先定義一條樣本:
{
  "query_id": "refund_001",
  "query": "跨境订单退款多久到账?什么情况需要人工审核?",
  "gold_doc_ids": ["refund_policy_2026_03"],
  "gold_chunk_ids": ["refund_policy_2026_03#chunk_07", "refund_policy_2026_03#chunk_09"],
  "required_facts": ["到账时间", "跨境支付需人工审核"],
  "user_scope": ["customer_service"],
  "as_of": "2026-06-18"
}
檢索系統返回:
[
  {"chunk_id": "refund_faq_2025_10#chunk_03", "doc_id": "refund_faq_2025_10", "score": 0.83},
  {"chunk_id": "refund_policy_2026_03#chunk_07", "doc_id": "refund_policy_2026_03", "score": 0.79},
  {"chunk_id": "payment_policy_2026_01#chunk_12", "doc_id": "payment_policy_2026_01", "score": 0.74}
]
下面這些指標各自回答不同問題。
3.1 Hit Rate@k
Top-k 裡是否至少出現一個 gold 證據。
適合回答:“這個問題有沒有撈到一點正確材料?”
缺點也明顯:只要命中一個就算成功,不關心是否命中全部關鍵證據,也不關心排第幾。
3.2 Recall@k
Top-k 裡命中的 gold 證據數量,佔 gold 證據總數的比例。
如果一個問題必須同時找到“到賬時間”和“人工審核條件”,Recall@k 比 Hit Rate 更有意義。很多 RAG 系統答不完整,不是模型不會總結,而是檢索只找到了其中一個事實。
3.3 Precision@k
Top-k 裡有多少比例是正確證據。
這個指標在上下文預算緊張時很重要。Recall 高但 Precision 低,意味著你確實把正確證據找到了,但也帶進來大量噪聲。模型在噪聲裡做推理,穩定性會下降。
3.4 MRR
MRR(Mean Reciprocal Rank)關心第一個正確結果排在第幾位。
如果第一個正確 chunk 總是排在第 1 或第 2,MRR 高;如果正確 chunk 經常排在第 8 或第 12,MRR 低。對只取 top-3 或 top-5 進上下文的系統,MRR 非常關鍵。
3.5 nDCG@k
nDCG 適合 gold 證據有等級的場景。比如一個 chunk 是“直接回答問題的政策條款”,另一個只是“背景解釋”,它們不應該同權。
如果你有人工標註的 relevance grade,例如:
- 3:直接支撐答案;
- 2:部分支撐;
- 1:背景相關;
- 0:不相關。
那麼 nDCG@k 比簡單 Recall 更能反映排序質量。
3.6 Coverage
Coverage 不是標準 IR 指標,但對業務 RAG 很實用。它回答:
問題需要的關鍵事實類型,是否都被證據覆蓋?
例如退款問題需要:
- 時間;
- 渠道;
- 異常條件;
- 審核條件;
- 政策版本。
只命中“時間”不夠。Coverage 可以按 required_facts 計算。
3.7 Freshness
RAG 的錯誤常常不是“沒找到”,而是“找到了舊版本”。
Freshness 可以按業務規則定義:
- 是否命中最新版本文檔;
- 是否符合
as_of時間; - 是否避開已廢止政策;
- 多版本衝突時是否選擇優先級最高的來源。
3.8 Permission Violation
企業 RAG 必須把權限當作檢索指標,而不是生成層道德提醒。
如果用戶無權訪問某些文檔,檢索結果裡出現這些文檔就已經是系統錯誤,即使模型最終沒有引用。評測集應該包含不同 user_scope、部門、地區、客戶等級和數據隔離場景。
3.9 Duplicate Rate
chunk overlap 會提升召回,但也會帶來重複。重複結果太多,會擠掉其他證據。
Duplicate Rate 可以按 doc_id、相鄰 chunk、文本相似度或 canonical fact 計算。它不一定越低越好,但高到一定程度就說明上下文預算被浪費。
3.10 Citation Support
Citation Support 屬於生成層和證據層之間的指標。它問:
答案裡的每個關鍵斷言,是否能被引用來源直接支持?
這比“有沒有引用”嚴格得多。RAG 系統最危險的狀態是:答案看起來專業、有引用,但引用點開不支持結論。
4. 評測集應該怎麼設計
不要從隨機用戶日誌裡隨便抽 100 條問題就開始算分。那會讓評測集偏向高頻、簡單、表述清楚的問題,掩蓋真正會出事故的邊界。
一個可靠的 RAG eval set 應該覆蓋這些類型:
| 類型 | 例子 | 目的 |
|---|---|---|
| 直接事實 | “企業版支持多少個管理員?” | 測基礎召回 |
| 多條件組合 | “跨境訂單退款多久到賬,哪些情況要人工審核?” | 測多證據覆蓋 |
| 版本敏感 | “2026 年 3 月後的退款政策是什麼?” | 測時效性 |
| 權限敏感 | “某客戶的合同折扣是多少?” | 測 metadata filter |
| 同義表達 | “錢什麼時候退回來?” | 測 query rewrite 和語義召回 |
| 反事實/不存在 | “能否 24 小時內保證退款?” | 測拒答和不確定性 |
| 衝突證據 | “新舊政策同時存在時按哪個算?” | 測版本優先級 |
| 長尾術語 | “SLA credit 怎麼申請?” | 測領域詞表和 hybrid search |
| 引用嚴格 | “請給出處並引用原文依據。” | 測 citation support |
每條樣本至少要有這些字段:
| 字段 | 作用 |
|---|---|
query_id |
穩定追蹤和迴歸測試 |
query |
用戶問題原文 |
intent_type |
事實、流程、比較、總結、排障等 |
gold_doc_ids |
正確來源文檔 |
gold_chunk_ids |
最小正確證據單元 |
required_facts |
答案必須覆蓋的事實 |
negative_doc_ids |
不能被當成依據的相似干擾文檔 |
user_scope |
權限上下文 |
as_of |
時間上下文 |
expected_answer_notes |
生成層評測提示,不要求唯一答案 |
這裡最費力的是 gold_chunk_ids。但如果沒有這個字段,你很難判斷檢索到底對不對。只標答案不標證據,會把問題又推回“最終答案對不對”的粗粒度評測。
5. 一個最小 retrieval eval 數據格式
可以從 JSONL 開始,不要一上來做複雜平臺。
{"query_id":"refund_001","query":"跨境订单退款多久到账?什么情况需要人工审核?","intent_type":"policy_qa","gold_doc_ids":["refund_policy_2026_03"],"gold_chunk_ids":["refund_policy_2026_03#chunk_07","refund_policy_2026_03#chunk_09"],"required_facts":["到账时间","跨境支付需人工审核"],"negative_doc_ids":["refund_faq_2025_10"],"user_scope":["customer_service"],"as_of":"2026-06-18","expected_answer_notes":"必须说明原支付渠道 1-5 个工作日;跨境支付订单进入人工审核;引用 2026-03 版政策。"}
{"query_id":"contract_014","query":"这个客户最新合同里的自动续约条款是什么?","intent_type":"contract_qa","gold_doc_ids":["contract_acme_2026_signed"],"gold_chunk_ids":["contract_acme_2026_signed#chunk_22"],"required_facts":["自动续约期限","提前通知窗口"],"negative_doc_ids":["contract_acme_2025_draft"],"user_scope":["legal","account_acme"],"as_of":"2026-06-18","expected_answer_notes":"只能使用已签署最新版合同,不能引用 2025 草案。"}
{"query_id":"support_033","query":"用户说登录后一直跳回首页,可能是什么原因?","intent_type":"troubleshooting","gold_doc_ids":["sso_runbook_2026_02","cookie_policy_2026_01"],"gold_chunk_ids":["sso_runbook_2026_02#chunk_11","cookie_policy_2026_01#chunk_04"],"required_facts":["SSO callback mismatch","SameSite cookie 配置"],"negative_doc_ids":[],"user_scope":["support_l2"],"as_of":"2026-06-18","expected_answer_notes":"需要给排查顺序,不能只给泛泛登录建议。"}
檢索輸出也建議記錄成 JSONL:
{"query_id":"refund_001","results":[{"rank":1,"doc_id":"refund_faq_2025_10","chunk_id":"refund_faq_2025_10#chunk_03","score":0.83},{"rank":2,"doc_id":"refund_policy_2026_03","chunk_id":"refund_policy_2026_03#chunk_07","score":0.79},{"rank":3,"doc_id":"refund_policy_2026_03","chunk_id":"refund_policy_2026_03#chunk_09","score":0.76}]}
OpenAI File Search 文檔裡有一個實用點:默認情況下模型輸出會帶文件引用 annotation,但如果你要分析檢索結果本身,需要在請求裡顯式 include file_search_call.results。做 eval 時不要只存最終 answer,要把搜索 query、top-k 結果、score、metadata、filters 和模型最終引用都存下來。
6. 離線評測腳本:先把問題定位清楚
下面是一段無第三方依賴的 Python 示例。它不負責調用檢索服務,只負責讀取 gold set 和 retrieval results,然後計算基礎指標。真實項目裡可以把它接到 CI、離線實驗平臺或 nightly job。
import json
import math
from collections import Counter
from pathlib import Path


def read_jsonl(path):
    with Path(path).open("r", encoding="utf-8") as f:
        for line in f:
            line = line.strip()
            if line:
                yield json.loads(line)


def dcg(relevances):
    return sum((2 ** rel - 1) / math.log2(i + 2) for i, rel in enumerate(relevances))


def evaluate(gold_path, result_path, k=5):
    gold = {row["query_id"]: row for row in read_jsonl(gold_path)}
    results = {row["query_id"]: row["results"] for row in read_jsonl(result_path)}

    totals = Counter()
    sums = Counter()
    failures = []

    for query_id, item in gold.items():
        rows = results.get(query_id, [])[:k]
        returned_chunks = [r["chunk_id"] for r in rows]
        returned_docs = [r["doc_id"] for r in rows]
        gold_chunks = set(item.get("gold_chunk_ids", []))
        gold_docs = set(item.get("gold_doc_ids", []))
        negative_docs = set(item.get("negative_doc_ids", []))

        chunk_hits = [chunk for chunk in returned_chunks if chunk in gold_chunks]
        doc_hits = [doc for doc in returned_docs if doc in gold_docs]

        hit_at_k = 1.0 if chunk_hits or doc_hits else 0.0
        recall_at_k = len(set(chunk_hits)) / max(1, len(gold_chunks))
        precision_at_k = len(chunk_hits) / max(1, len(rows))

        reciprocal_rank = 0.0
        for idx, row in enumerate(rows, start=1):
            if row["chunk_id"] in gold_chunks or row["doc_id"] in gold_docs:
                reciprocal_rank = 1.0 / idx
                break

        # 最小版 nDCG:gold chunk 记 3 分,gold doc 记 1 分,其他 0 分。
        rels = []
        for row in rows:
            if row["chunk_id"] in gold_chunks:
                rels.append(3)
            elif row["doc_id"] in gold_docs:
                rels.append(1)
            else:
                rels.append(0)
        ideal = sorted(rels, reverse=True)
        ndcg = dcg(rels) / dcg(ideal) if any(ideal) else 0.0

        permission_violation = any(doc in negative_docs for doc in returned_docs)
        duplicate_rate = 1.0 - (len(set(returned_chunks)) / max(1, len(returned_chunks)))

        totals["queries"] += 1
        sums["hit_at_k"] += hit_at_k
        sums["recall_at_k"] += recall_at_k
        sums["precision_at_k"] += precision_at_k
        sums["mrr"] += reciprocal_rank
        sums["ndcg_at_k"] += ndcg
        sums["permission_violation_rate"] += 1.0 if permission_violation else 0.0
        sums["duplicate_rate"] += duplicate_rate

        if recall_at_k < 1.0 or permission_violation:
            failures.append({
                "query_id": query_id,
                "query": item["query"],
                "recall_at_k": round(recall_at_k, 3),
                "returned_chunks": returned_chunks,
                "gold_chunks": sorted(gold_chunks),
                "permission_violation": permission_violation,
            })

    n = max(1, totals["queries"])
    summary = {name: round(value / n, 4) for name, value in sums.items()}
    return {"k": k, "summary": summary, "failures": failures[:20]}


if __name__ == "__main__":
    report = evaluate("retrieval_eval.jsonl", "retrieval_results.jsonl", k=5)
    print(json.dumps(report, ensure_ascii=False, indent=2))
這段腳本故意簡單,因為第一版 eval 的目標不是“指標優雅”,而是幫助你把錯誤分層:
- Recall 低:檢索層沒找到;
- MRR 低:找到了但排序靠後;
- Precision 低:噪聲太多;
- Duplicate Rate 高:上下文預算被重複 chunk 佔用;
- Permission Violation 高:權限過濾不能上線;
- nDCG 低:排序沒有把強證據放前面。
7. 診斷矩陣:指標差時應該改哪裡
評測不是為了得到一個分數,而是為了決定下一步改哪裡。
| 評測現象 | 常見原因 | 優先排查 |
|---|---|---|
| Hit Rate@10 低 | query 表達和文檔表達差異大;索引缺文檔;embedding 不適合領域 | query rewrite、同義詞詞表、索引覆蓋、hybrid search |
| Recall@10 高但 Recall@3 低 | 正確結果在後面 | reranker、ranking options、domain boost |
| Precision@5 低 | top-k 混入大量弱相關片段 | score threshold、metadata filter、query decomposition |
| MRR 低 | 第一個正確結果太靠後 | 重排模型、標題/層級 metadata、文檔結構化 |
| nDCG 低 | 強證據沒有排在弱證據前 | 人工 relevance grade、業務優先級、source authority |
| Duplicate Rate 高 | chunk overlap 太大;相鄰 chunk 都進上下文 | 結果去重、按 doc 限額、MMR、多樣性約束 |
| Freshness 差 | 舊文檔沒有廢止標記;日期過濾缺失 | as_of 過濾、版本優先級、索引生命週期 |
| Permission Violation > 0 | 檢索前未做權限過濾;只在生成層提醒模型 | 強制 metadata filter、租戶隔離、審計日誌 |
| 答案錯但檢索對 | 模型沒有忠實使用證據;上下文排序差 | 引用約束、證據編號、答案後驗校驗 |
| 答案對但引用錯 | citation 沒校驗;引用只是文本裝飾 | claim-to-citation 檢查、引用片段回放 |
這裡有一個容易忽略的順序:先修權限和時效性,再修召回,再修排序,最後修生成。
原因很簡單:如果檢索結果裡已經有越權或過期內容,生成層越強,越可能把錯誤證據組織成可信答案。
8. 答案層評測:不要讓模型“帶著錯引用答對”
RAGAS 等工作把 RAG 評測拆成了 answer relevancy、faithfulness、context precision、context recall 等維度;ARES 這類框架也強調用自動化方式評測 RAG 的檢索和生成質量。這些方向的共同點是:不要把答案正確性和證據質量混成一個黑盒分數。
工程上可以把答案層評測拆成四個檢查:
8.1 Answer Correctness
答案是否覆蓋 required_facts,有沒有明顯事實錯誤。
這個指標可以由人工、規則、LLM judge 或混合方式完成。高風險任務不要完全依賴單一 LLM judge,至少要抽樣人工複核。
8.2 Faithfulness
答案裡的關鍵斷言是否都來自上下文證據。
例子:
答案断言:跨境订单退款通常需要 1-5 个工作日,并需要人工审核。
证据 A:退款通常在 1-5 个工作日内退回原支付渠道。
证据 B:跨境支付订单需进入人工审核。
這就是可支持的。如果證據只說“部分異常訂單需審核”,答案卻寫“所有跨境訂單都需審核”,就不忠實。
8.3 Citation Support
每個引用是否支撐它旁邊的句子。
不要只檢查“答案末尾有沒有來源列表”。更好的做法是讓答案的每個關鍵句帶 citation id,然後逐條校驗:
{
  "claim": "跨境支付订单需进入人工审核。",
  "citation": "refund_policy_2026_03#chunk_09",
  "supported": true
}
8.4 Refusal / Insufficient Evidence
當檢索不到足夠證據時,系統是否會明確說“不足以回答”,而不是編一個看起來合理的答案。
這類樣本必須進 eval set。否則系統會在有證據問題上得分很好,但在無證據問題上製造幻覺。
9. 線上監控:離線分數不等於線上可靠
離線 eval 是上線門檻,不是上線後的免死金牌。線上至少監控這些信號:
| 信號 | 說明 |
|---|---|
| 檢索空結果率 | 空結果突然上升,可能是索引、權限或查詢改寫異常 |
| 平均 top-1 / top-5 score | 分數分佈漂移,可能說明數據或 query 變了 |
| 低分回答率 | 低檢索置信度時仍生成答案,需要關注 |
| 引用點擊率/反饋 | 用戶是否點擊來源,是否認為來源不相關 |
| 人工轉接率 | 客服、法務、財務場景裡很關鍵 |
| 版本命中率 | 新政策發佈後,舊版本是否仍被命中 |
| 權限拒絕率 | 權限過濾是否異常寬或異常嚴 |
| p95 延遲 | reranker、query decomposition 和 top-k 擴大會影響體驗 |
| 輸入 token 分佈 | 證據過長會提高成本,也可能擠掉規則 |
| 答案後驗校驗失敗率 | citation support 或 faithfulness checker 的失敗趨勢 |
更進一步,可以把線上失敗樣本回流到 eval set:
- 用戶點踩或轉人工;
- 記錄 query、retrieval results、answer、citations、filters;
- 人工標註 gold evidence 和失敗原因;
- 加入 regression eval;
- 下次改檢索、chunking、reranker 或 prompt 時必須跑過。
這才是 RAG 質量持續提升的閉環。
10. 常見誤區
10.1 只用公開 benchmark 判斷業務 RAG
BEIR、KILT 等 benchmark 對理解信息檢索和知識密集型任務很有幫助,但它們不能替代你的業務 eval set。企業知識庫裡最難的問題通常是權限、版本、內部術語、流程例外和文檔質量。
公開 benchmark 可以用來比較底層檢索器,但上線決策必須看業務 gold set。
10.2 把 top-k 調大當成萬能解
top-k 變大通常能提高 Recall,但也會增加噪聲、token、延遲和引用混亂。正確做法是同時觀察 Recall、Precision、MRR、nDCG、答案 faithfulness 和成本。
10.3 只標 gold doc,不標 gold chunk
只標文檔粒度會讓指標虛高。一個 80 頁 PDF 裡有正確答案,不代表檢索到這個 PDF 的任意 chunk 都算成功。
10.4 不測無答案問題
RAG 系統必須會說“不知道”。無答案問題、權限不足問題、證據衝突問題都應該進 eval。
10.5 把 LLM judge 當絕對真值
LLM judge 很適合擴大評測規模,但它本身也需要校準。建議做法是:
- 關鍵指標保留人工標註樣本;
- LLM judge 輸出理由和引用;
- 抽樣複核 judge 誤判;
- 每次改 judge prompt 也跑回歸。
10.6 忽略數據攝取質量
如果 PDF 解析錯、表格丟列、標題層級消失、掃描件 OCR 錯誤,檢索評測會持續低分。不要只調 embedding 和 reranker,也要檢查 ingest pipeline。
11. 落地路線圖
如果從零開始,我建議按四周推進。
第 1 周:建立最小 eval set
- 選 50-100 條真實業務問題;
- 覆蓋高頻、長尾、無答案、權限、版本和衝突場景;
- 標註
gold_doc_ids、gold_chunk_ids、required_facts; - 固定第一版 JSONL 格式。
第 2 周:跑檢索層基線
- 記錄 top-10 檢索結果;
- 計算 Hit Rate@k、Recall@k、MRR、nDCG;
- 輸出失敗樣本列表;
- 對失敗樣本按原因分類:缺文檔、chunk 不佳、query 不佳、排序不佳、權限/版本錯誤。
第 3 周:做排序和上下文實驗
- 比較不同 chunk size 和 overlap;
- 比較 semantic、keyword、hybrid search;
- 比較 query rewrite 開關;
- 加 reranker 或業務 boost;
- 加去重、source cap、metadata filter;
- 每次只改一類變量,避免無法歸因。
第 4 周:接答案層和線上監控
- 加 answer correctness / faithfulness / citation support 檢查;
- 記錄
file_search_call.results或自建 retriever trace; - 把低置信度、用戶差評、人工轉接樣本回流;
- 在發佈流程裡設置迴歸閾值。
第一版閾值可以保守一點,例如:
| 指標 | 上線前建議 |
|---|---|
| Permission Violation | 必須為 0 |
| Hit Rate@10 | >= 0.90 |
| Recall@5 | >= 0.75 |
| MRR | 持續提升,不低於舊版本 |
| Citation Support | >= 0.85,且高風險場景人工抽檢 |
| 無答案拒答準確率 | >= 0.85 |
這些數字不是通用標準,只是幫助團隊開始討論 trade-off。真正的閾值要根據業務風險來定。
12. 發佈前自檢清單
上線前至少問完這些問題:
- 是否有覆蓋真實業務的 eval set,而不只是 demo 問題?
- 是否標註了 gold chunk,而不只是 gold answer?
- 是否包含無答案、權限、過期、衝突和長尾術語樣本?
- 是否能輸出每個 query 的 top-k 結果、score、metadata、filter 和最終引用?
- 是否分別看了 Recall、MRR、nDCG、Permission Violation、Duplicate Rate?
- 是否有答案層的 faithfulness 和 citation support 檢查?
- 是否有失敗樣本回流機制?
- 是否能在模型、embedding、chunking、reranker、prompt 變更後跑回歸?
- 是否明確低置信度時的降級策略:拒答、追問、轉人工或擴大檢索?
- 是否記錄了上線版本的知識庫快照和評測報告?
如果這些問題答不上來,RAG 系統就還停留在“能演示”,沒有進入“可運營”。
13. 總結
RAG 檢索質量評測不是一個單一分數,而是一套定位問題的工具箱。
最重要的不是選擇 Recall@k 還是 nDCG,而是建立這條鏈路:
业务问题 -> gold evidence -> top-k 检索结果 -> 排序指标 -> 上下文质量 -> 答案归因 -> 失败回流
當你能把一次錯誤回答拆成“沒召回、排太后、證據過期、權限失效、引用不支持、模型沒忠實使用證據”中的某一種,RAG 系統才真正可改進。
下一篇建議繼續寫:RAG 的引用與歸因怎麼做:讓答案裡的每一句關鍵結論都有可追溯證據。
參考資料
- OpenAI Developers: Retrieval
- OpenAI Developers: File search
- OpenAI Developers: Working with evals
- Es et al., RAGAS: Automated Evaluation of Retrieval Augmented Generation
- Thakur et al., BEIR: A Heterogeneous Benchmark for Zero-shot Evaluation of Information Retrieval Models
- Petroni et al., KILT: a Benchmark for Knowledge Intensive Language Tasks
- Saad-Falcon et al., ARES: An Automated Evaluation Framework for Retrieval-Augmented Generation Systems