復現目標:讓長度成為唯一干預變量
上一篇把固定的短句分類器遷移到長影評,發現概率質量與準確率需要分別檢查。但那裡還有一個容易被忽略的條件:模型最多讀取五百一十二個詞元。詞元是分詞器產生的輸入單位,不等於一個英文單詞。一篇影評經過分詞後可能遠超模型上限;程序照常返回兩個概率,並不表示它讀過完整影評。
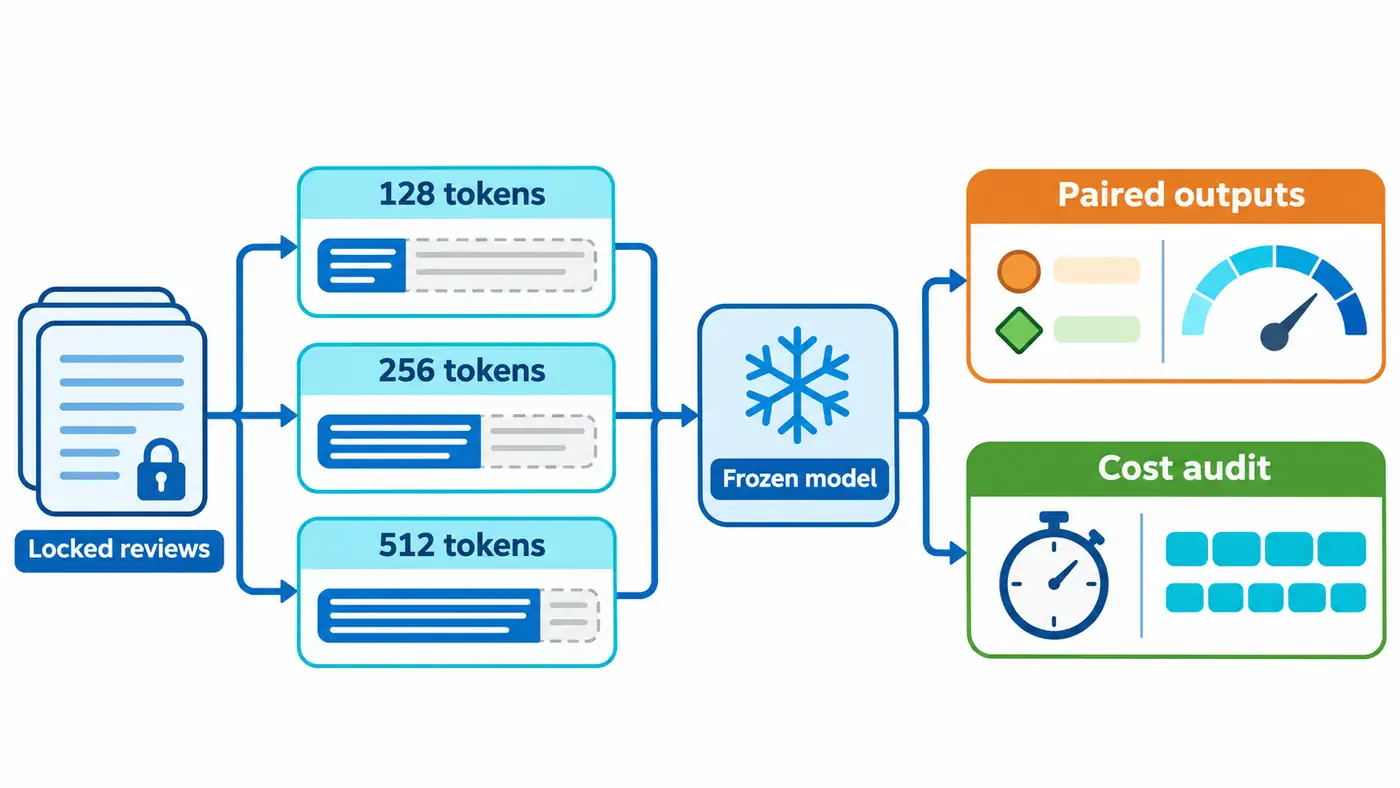
本次只問一個受控問題:對完全相同的影評,減少輸入長度,到底只改變模型的猶豫程度,還是連預測類別也改變?我們凍結模型、分詞器、樣本身份、標籤、批次順序和精度,只把最大長度設為一百二十八、二百五十六和五百一十二。主要產物是三千條配對預測、逐條截斷計數和獨立審計腳本,不是一次新的模型競賽。
結果先說清楚:短預算同時改變答案和置信度。相對最長預算,兩個短預算分別出現一百三十九次和四十七次類別翻轉。這個結果只能描述本次固定模型與探索樣本;我們沒有給截斷後的文本重新標註,也沒有判斷被刪掉的句子是否一定包含轉折或結論。
核心思想:截斷是輸入干預,不是概率後處理
溫度縮放只調整已有分數的尺度,而截斷髮生在模型前向計算之前。少了後面的詞元,注意力可利用的上下文、池化表徵和分類分數都可能變化。即使最終類別相同,概率也未必相同;反過來,兩個條件都很自信,也可能自信地給出相反答案。官方分詞文檔區分填充與截斷:前者為批處理對齊長度,後者限制真實輸入。Transformers 文檔
設原始非特殊詞元序列為 ,總長度為 。本實驗使用右側截斷,併為起止標記預留兩個位置:
其中 表示樣本, 是包括特殊標記的長度上限, 是確實未送入模型的詞元數。該計數衡量輸入刪除量,不能衡量語義信息損失。程序把實際輸入逐項與完整分詞結果的前綴比較,避免只相信配置文件寫了“右截斷”。
模型輸出 ,兩列分別對應負面與正面。我們使用未經溫度調整的概率:
這裡 為類別,置信度定義為兩列概率的最大值。並列時選擇較小的標籤索引。負對數似然使用原始完整影評標籤對應的概率;它衡量在當前可見前綴下預測原任務標籤的損失,並不證明這個前綴本身應當繼承原標籤。
主要配對指標是相對最長預算的翻轉率與置信度絕對變化均值:
為本次一千條探索樣本。絕對值避免一部分置信度升高、一部分降低相互抵消;但這個均值仍可能掩蓋少量劇烈變化,不能解釋為每條樣本都只變化這麼多。
官方代碼閱讀路線
先看固定模型卡,確認這是在英文情感分類數據上微調的 DistilBERT,而不是開放生成模型。隨後進入固定提交的分類前向函數,查看隱藏狀態如何經過分類頭得到兩列分數;最後看快速分詞器中設置截斷和批量編碼的實現。源碼地圖給出實際核驗的提交、文件位置、許可證和本地調用關係。模型卡
本地沒有重新實現 Transformer,而是直接調用官方分類類。獨立教學代碼負責鎖定樣本、循環長度、保存預測和計算指標。這樣閱讀時可以把問題拆開:模型網絡是否一致、輸入是否一致、統計是否一致。框架文件與當前安裝文件逐字節核對;僅知道版本號相同還不足以排除本地修改。
最小實驗與評測協議
IMDb 三個池沿用上一篇在首次預測前凍結的身份文件,各一千條,先按電影分組與規範化文本摘要去重,再按穩定哈希順序分配。本次只讀取探索池的正文與標籤。目標域校準池不擬合,最終確認池仍封存到系列末篇。電影去重改變了抽樣分佈,因此不能把這一千條當成官方完整測試集成績。
源域 SST-2 曾被此前研究使用,這段歷史不會因為重新劃分而消失。當前檢查點及分詞器固定在同一版本,IMDb 使用官方第一版壓縮包的已核驗摘要。公開文本可能進入過模型預訓練,本文沒有零汙染證據。數據包保留在共享緩存,源碼只分發身份摘要和派生預測,不重新分發影評全文。
協議在運行前寫入配置:三個長度全部報告,不按表現挑一個;處理順序固定為短到長;每批十六條,四個處理器線程,單精度、評估模式、確定性算法和普通注意力實現。每個條件先運行八條試跑,估算完整預算後再處理一千條。沒有訓練、目標域校準或提示模板搜索。本次最長條件也重新前向計算,而非拿舊結果拼成對照。
本次實際驗證:答案變化不能被均值掩蓋
| 最大詞元數 | 對原標籤正確數 | 相對512的翻轉數 | 置信度絕對變化均值 | 負對數似然 |
|---|---|---|---|---|
| 128 | 829/1000 | 139 | 0.03141 | 0.74291 |
| 256 | 877/1000 | 47 | 0.01667 | 0.51091 |
| 512 | 890/1000 | 0 | 0 | 0.44102 |
表中都是本次真實運行結果,不是論文報告。置信度平均變化約三個百分點,看起來不大,卻伴隨接近百分之十四的預測翻轉。原因之一是置信度只取最大概率,丟失了“最大概率屬於哪個類別”的信息;兩個方向相反的高置信預測可以具有相近的最大概率。因此監測置信度漂移時,應同時保存完整概率向量與類別身份。
短預算相對最長預算,一百條由對變錯,三十九條由錯變對,淨減少六十一條正確預測。中等預算對應三十條由對變錯、十七條由錯變對。二分類下,標籤固定且預測發生翻轉,恰有一個條件正確;審計腳本用這條關係核對翻轉數。它是一條算術檢查,不是人工語義審核。
即使使用預先固定的原始置信度零點九門檻,三個長度仍分別接受九百三十七、九百三十七、九百四十五條,其中錯誤為一百四十二、九十七、八十九條。接受量近似相同不代表拒答質量相同。這裡沒有重新選擇閾值,也沒有把這個探索性門檻包裝成總體風險保證。
丟棄了什麼,節省了什麼
三個條件分別有八百九十五、四百二十五、一百零九條發生截斷,總丟棄詞元為一六八〇九〇、八四五二六、二五三〇五。最長條件仍未讀完所有影評,所以它只是本次預算基準,不是完整上下文的金標準。不能把短預算與它的差異直接稱為全部截斷損失。
推理循環實測約九點八八、二十二點八九、五十六點一八秒。這一計時包含分批編碼與模型計算,不包含此前的完整文本分詞、模型加載和數據讀取。運行日誌另記總牆鍾時間、進程峰值內存、批次形狀和填充詞元量。峰值內存是同一進程累計值,不能偽裝成每個長度獨立的內存測量。
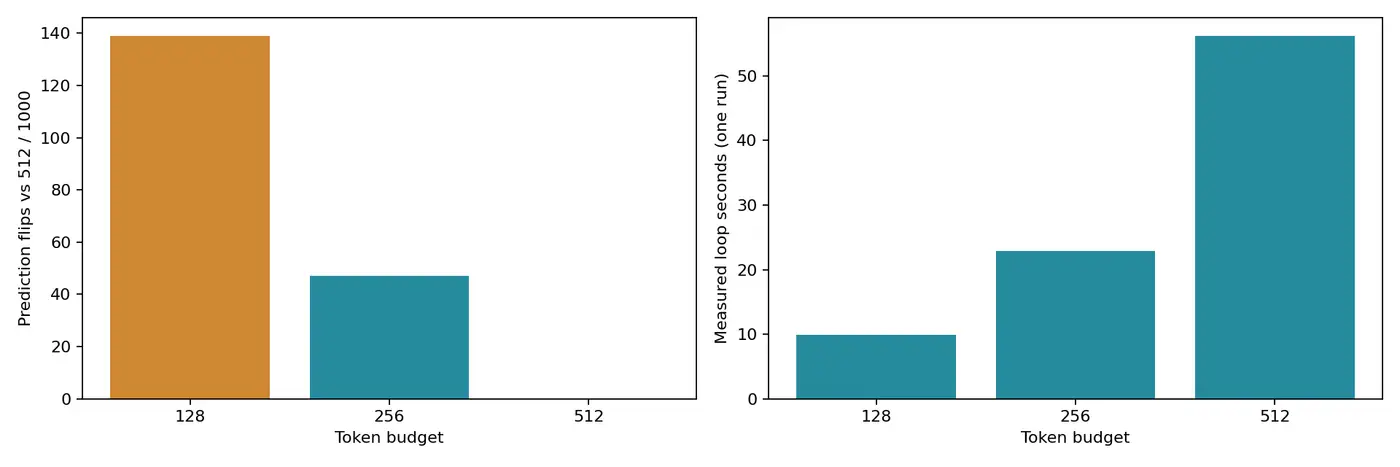
這是一輪固定順序測量,沒有多次重複、順序隨機化或置信區間,因此不能據此宣稱精確的硬件加速比。動態填充還使成本取決於同批最長樣本,保留詞元總數與實際填充後的計算規模並不相等。工程讀者復跑時應先對齊批次和線程,再比較耗時,而不是隻檢查最大長度。
失敗排查與證據邊界
完整分詞計數階段出現超過模型長度上限的警告。這裡沒有把超長序列送入模型:前向輸入重新按每個預算截斷,並記錄張量形狀;逐條斷言驗證特殊標記之外的輸入等於原序列前綴。若警告出現在實際前向階段,應先檢查輸入長度與位置編碼邊界,不能簡單隱藏日誌。
另一個常見誤區是把標籤不變當成語義不變。本實驗保留官方完整影評標籤,只用於評價“讀前綴預測原任務”的表現。它沒有建立前綴的獨立金標,沒有檢查刪掉的部分是否包含否定,也沒有把翻轉歸因於結尾反轉。若後續研究需要這種因果解釋,應先準備人工標註指南和待審樣本,收到真實判斷後再形成結論。
獨立審計不導入主評測函數,而是從兩列分數重建歸一化概率、正確數、損失、翻轉和刪除計數,並核對探索池身份。全部三千條通過。審計支持文件內部一致性,不能替代來源核驗,也不能證明模型理解了文本。耗時與內存屬於測量值,語義機制屬於尚未驗證的解釋,兩者需要分開呈現。
源碼與復現入口
打開本篇固定版本源碼,按README 復現說明運行;SOURCE_MAP 源碼地圖列出官方實現與本地模塊的對應關係。
最小離線命令為 python run.py analyze && python audit.py,重建結果並獨立核對已存的真實分數。新推理先按說明安裝固定依賴,運行下載校驗,再執行三個長度的試跑與正式實驗。預期產物包括逐樣本分數、輸入摘要、分組結果和運行環境記錄。本文實際執行了每個長度八條試跑及每個長度一千條正式推理;沒有把只運行語法檢查稱為模型復現。
可檢驗研究問題與總結
下一步值得檢驗的假設是:預測翻轉是否主要集中在確實發生截斷的樣本,以及相同類別但置信度明顯變化是否會擾動既有拒答規則。應先固定分組、變化閾值和主要統計量,再用允許的開發數據檢查。若要比較頭部與尾部窗口,還必須控制詞元預算和窗口數量,避免把更多計算誤認為更好的選擇策略。
本次留下的可靠結論很具體:在鎖定的一千條探索影評上,縮短輸入同時改變類別與概率,速度收益伴隨原任務正確數下降;少量樣本卻在短輸入下變得正確。較長上下文沒有逐樣本必勝保證,較高置信度也不能證明截斷無害。把輸入身份、長度與預測一起保存,才有機會把這些現象轉化為可複查的小研究問題。
參考資料
檢索日期:2026-11-18。論文報告、官方接口說明與本次實測已在正文區分。
- Andrew L. Maas、Raymond E. Daly、Peter T. Pham、Dan Huang、Andrew Y. Ng、Christopher Potts,2011,Learning Word Vectors for Sentiment Analysis,ACL,IMDb 數據出處。
- Hugging Face,DistilBERT SST-2 模型卡,實際權重版本與文件摘要見源碼鎖定記錄。
- Hugging Face,Transformers 4.49.0,Padding and truncation,輸入控制規則。
- Hugging Face,固定提交的分類器實現,具體調用和許可見源碼地圖。
- Chuan Guo、Geoff Pleiss、Yu Sun、Kilian Q. Weinberger,2017,On Calibration of Modern Neural Networks,ICML,概率校準背景;本文不重新擬合溫度。
作者作品推廣
除了寫技術博客,我也在做一些讓日常更有條理的小工具,歡迎瞭解我獨立開發的兩款 App:
- 日常收支小記:記下收支,也給每一筆錢安排好去處。記錄日常賬目,安排預算與儲蓄目標。在 App Store 瞭解。
- 一事微光:從一件小事開始,讓今天多一點微光。按當下的時間和精力選擇行動,記錄完成後的感受與發現。在 App Store 瞭解。
更多技術文章和個人作品,歡迎來我的網站:zffjzz.top。也歡迎把使用感受告訴我,讓這些小工具慢慢變得更好。