- 日期:2026-10-25
- 讀者:研究生、科研新人和工程型研究者
- 實際範圍:4 條已觀察的 SciFact 開發探針,每條固定 50 個候選;真實 MiniLM 計分 400 對;不使用確認集。
摘要:正交互不等於兩個模塊都有效
假設一套方法包含“讓證據更靠前”和“保留原檢索排名”兩個改動。把二者一起打開,結果比原始模型高,能否認定兩個模塊都有效?不能:其中一個可能有害,另一個只是緩解了它造成的退步。
本次完整運行四種組合,得到一個值得保留的反例:平均交互效應為正,但證據前移在兩種排序背景下都降低平均分;兩個模塊同時使用,也沒有超過只做排名融合。這個結論只描述四條診斷材料,不是總體性能判斷。復現的價值在於把“哪個模塊有用”拆成可核查的條件效應,而不是再畫一張看起來合理的模塊圖。
一、研究目標:接上已有問題,而非另起爐灶
前一篇在一百條開發查詢上比較純交叉編碼器與固定排名融合。本篇沿用同一條檢索研究主線,接回已登記的“上下文保留與排名融合是否互相影響”。新增變量只有是否啟用兩項操作;模型、候選、標籤、長度限制和融合常數保持凍結。
交叉編碼器,簡稱 CE,把查詢和文檔一起輸入模型,為這一個配對輸出相關性分數。倒數排名融合,簡稱 RRF,則把各系統給出的名次變成倒數再相加。RRF 原論文報告了多個檢索系統融合的實驗;它並沒有承諾所有文本改寫都會與融合協同。本篇檢驗的是自己的組合,不能借用論文結論作為結果。
SciFact 原論文同時提供科學斷言、證據文檔和證據句標註。BEIR提供檢索評測框架。我們評估相關文檔的位置,不評估斷言是否成立,也不聲稱復現了完整科學事實核驗系統。
二、核心思想:把一次刪除變成四個格子
消融實驗是移除或關閉某項操作,觀察其餘條件固定時的變化。若只從完整系統刪掉一個模塊,測到的只是“另一個模塊已經開啟時”的貢獻。要知道它會不會依賴另一個模塊,至少需要把四個格子補齊。
令 表示原文, 表示把原數據集標註的證據句移到摘要前部;令 表示按 CE 排序, 表示融合 CE 與原候選排名。這裡的前移保留標題、全部句子及各句內部內容,但改變句間順序。它使用已知答案相關信息,是 oracle 診斷:為理解失效機制借用金標準信息,不能作為真實檢索方案部署。
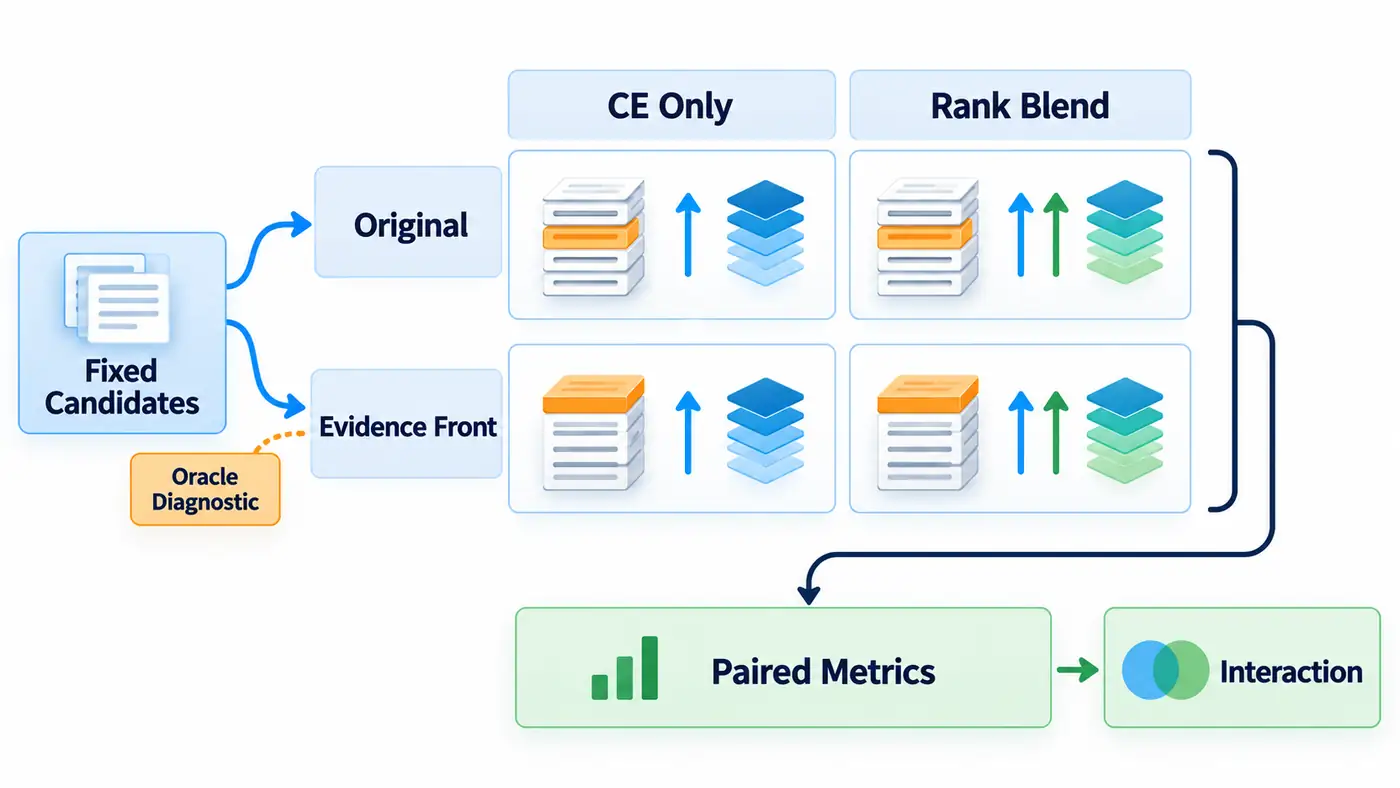
圖中四格共享候選集合,最後按同一查詢配對計算指標。圖內圖標僅說明流程,不表示測量值。材料複用此前兩長兩短四條探針,原文與前移版本及其審核記錄逐字節固定;本次沒有新造改寫或重新挑選“效果明顯”的樣本。此前原文、前移、後移分數已經觀察過,因此這也不是結果盲的首次驗證。長短分組繼承之前的前移/後移可見性規則,不保證原文與前移之間一定新增了可見證據。因此,操作名稱只是輸入處理方式,不能直接當作已經實現的機制。先核對每條材料的可見性記錄,再解釋具體變化,才能避免把預期效果寫進實驗定義。
三、公式:先說明在哪個背景下有效
記 為查詢 在操作組合 下的 nDCG@10。它把前十名相關文檔的折扣收益除以理想排序收益,值越大表示相關文檔越靠前。本組每條查詢恰有一個相關文檔,若其名次 ,則 ,否則為零。
交互量定義為:
方括號分別是前移背景、原文背景下啟用融合的增益;差值為正,只表示融合在前移後帶來更大的增益,不表示前移本身有益。也可以交換兩因素的角色,得到同一個差中之差。
融合採用已經凍結的公式:
是同一候選集中的文檔, 是原 RRF 候選名次, 是當前文本條件下的 CE 名次,均從一開始。常數六十與等權重不調優;同分按文檔標識字符串降序排序。融合的是“原融合排名與重排排名”,不是重新訓練模型,也沒有擴大候選集。
跨另一個因素平均的貢獻同樣可以計算,但不能掩蓋條件:例如 的平均效應是兩種 背景下前移效果的算術平均。本文同時保存條件效應、平均效應和每條交互,不僅報告一個總數。
四、官方代碼閱讀路線與最小實驗
先讀 BEIR 的 Rerank.rerank:它怎樣拼接標題與摘要,怎樣把批量分數放回查詢和文檔標識。再讀 Sentence Transformers 的 smart_batching_collate_text_only 和 predict:聯合輸入採用最長側優先截斷,最大總長為五百一十二個 token;token 是分詞器處理後的輸入單位。最後檢查 BEIR 評測代碼如何調用 pytrec_eval。固定提交、具體行號和本地對應路徑全部列在源碼地圖中。
本次實際使用 ms-marco-MiniLM-L6-v2,凍結模型與分詞器 revision 為 233902d25c440f23af6f7d6e94d2946bac0bee0a。運行環境為 Python 3.12、PyTorch 2.6.0、Sentence Transformers 3.4.1,CPU、單精度、四線程、批量十六。原始 logit 是模型輸出的未歸一化標量,不作為正確概率解釋。模型卡說明訓練任務為 MS MARCO,本文沒有重新訓練,也沒有套用卡片中的硬件速度。
先用四條查詢各自的原前兩名加相關文檔試跑,本次合併去重後是十六對計分;再運行兩種文本條件各二百對。四格只需兩輪真實模型評分,因為每輪分數可以同時用於純 CE 和融合。另有四對形狀核對前向,單獨記賬。抽查輸入形狀為 ,最後隱層為 ,輸出為 :三者分別表示批量與長度、批量與長度與隱藏維、批量與單個相關性分數。
五、評測協議與本次實際結果
四條查詢都來自已觀察開發數據;相關文檔已經在固定五十個候選中,因此所有格子的 Recall@50 都為一。不能據此聲稱召回問題已解決,這只是探針選擇的結果。下面給出全部正式結果,列名中的兩個數字依次對應 與 。
| 查詢/組別 | 原文 CE(00) | 前移 CE(10) | 原文融合(01) | 前移融合(11) | 交互 |
|---|---|---|---|---|---|
| 454/長 | 1.000000 | 1.000000 | 1.000000 | 1.000000 | 0.000000 |
| 30/長 | 1.000000 | 0.630930 | 1.000000 | 1.000000 | 0.369070 |
| 280/短 | 1.000000 | 1.000000 | 1.000000 | 1.000000 | 0.000000 |
| 155/短 | 0.630930 | 0.430677 | 1.000000 | 0.630930 | -0.168817 |
| 四條均值 | 0.907732 | 0.765402 | 1.000000 | 0.907732 | 0.050063 |
本次實際驗證:前移在純 CE 下平均降低 0.142331,在融合下平均降低 0.092268。融合在原文下提高 0.092268,在前移後提高 0.142331;兩者之差就是正交互 0.050063。若只比較“全開”與“全關”,兩者均值相同,會把內部的退步與恢復一起掩蓋。
查詢三十最容易理解:相關文檔在原文 CE 中第一,前移後第二,融合又把它恢復第一。正交互來自對退步的緩解。查詢一百五十五則不同:CE 排名由第二降至第四,融合分別給出第一與第二;原文背景下融合收益更大,故交互為負。兩條不變查詢也必須保留;排名指標有臺階和上限,分數變化可能沒有跨越名次,零交互並不代表內部計算完全沒變。
六、失敗排查:算術正確之外還要核對什麼
首先核對輸入身份。四條材料與既有審核包哈希一致,非目標文檔的 token 序列與分數跨文本條件完全相同。本次四百個分數與此前對應計分逐項相同;這是新推理完成後的對照,不是把緩存重放包裝成新運行。原文重建、句序、候選清單或標識關聯任何一項不符,都應先修復流程,不能先解釋指標。
其次核對資源賬。兩種文本條件各使用 75683 個非填充 token,逐配對長度相等,但可見內容與位置不同;等長不等於等信息。實際推理共 10.56 秒,完整入口約 13.22 秒,進程峰值常駐內存 775897088 字節。初始檢索成本沒有重測;這些是本機一次測量,不是模型性能保證。融合沒有增加模型調用,不能把四格誤記成八百次模型推理。
最後獨立復算。單獨腳本從原始配對分數重建排名,用標準庫計算指標與交互,用有理數核對倒數分數,再與官方評測結果比較;同時檢查七種故意損壞的證據是否被拒絕。命令、退出碼和輸入哈希隨包保存。首次審計命令因工作目錄錯誤未執行,隨後在正確目錄通過;源碼下載的首次網絡失敗也保留記錄。沒有把自動復算稱為人工語義判斷。
七、研究問題:這份消融證據能支持到哪裡
作者推斷:本組結果不支持“證據前移必然改善排序”,也不足以把正交互解釋成一般協同。前移同時改變語篇順序、證據位置和截斷後留下的上下文;即使完整文檔標籤保持,也不能證明模型只響應證據可見性。短材料沒有截斷仍會退步,是需要保留的反例。
後續可檢驗的問題是:融合收益是否主要來自恢復原檢索的高位文檔,而不是“理解了更多證據”?目前只有四條非隨機探針,兩組各兩條,且結果存在天花板。不能用四格當四個獨立樣本計算顯著性,也不把重複同一確定性推理當新增樣本。擴展實驗需要先固定更多材料的選取、變換有效性與分組規則,再觀察結果。
本篇不以診斷結果替換已經登記的確認方案。下一篇彙總這條研究主線的條件與失敗;最終報告仍保留原文 CE、固定融合及原排名對照,屆時才使用尚未評測的三百條確認查詢。金標準輔助的前移操作不進入候選方法,也不在看到確認結果後調常數。
源碼與復現入口
已發佈並匿名核驗的固定版本:完整源碼目錄、README 運行說明、SOURCE_MAP 源碼地圖。其中包含精確依賴、鎖定資源、協議、全部配對分數與獨立審計腳本;遠端與本地歸檔逐文件一致。
按 README 準備環境和經哈希核驗的緩存後,最小真實運行命令為:
python run.py --cache ./cache --out replay-smoke --smoke
預期產物為兩組模型分數、四格排序、逐查詢條件效應、交互、token 與資源賬。去掉最後一個參數才運行本文四百對正式範圍;試跑的小候選集不能用於替代正式指標。僅複核保存結果可執行 python audit.py --out results,不需要重新下載模型。包內已包含所需自寫模塊,完整數據與權重通過固定來源獲取。
總結
一個模塊的貢獻必須說明“在誰已經開啟的條件下”。四格對照的價值,是把下降、恢復與組合效果分開。本次最有用的發現不是一個正號,而是正交互背後兩條方向相反的查詢,以及“全開並不最好”的邊界。
參考資料
檢索與固定源碼核驗日期:2026-10-25。論文結論、模型說明與本次實驗分別使用,不把官方基準數字當作本次結果。
- Wadden、Lin、Lo、Wang、van Zuylen、Cohan、Hajishirzi,2020,Fact or Fiction: Verifying Scientific Claims,EMNLP。
- Thakur、Reimers、Rücklé、Srivastava、Gurevych,2021,BEIR: A Heterogenous Benchmark for Zero-shot Evaluation of Information Retrieval Models,NeurIPS 數據集與基準賽道。
- Cormack、Clarke、Büttcher,2009,Reciprocal Rank Fusion outperforms Condorcet and individual Rank Learning Methods,SIGIR。
- Sentence Transformers,MiniLM 交叉編碼器固定模型卡。鏈接使用已成功讀取並核驗的官方固定版本原文。
- BEIR,固定版本 Rerank 實現;Sentence Transformers,固定版本 CrossEncoder。
作者作品推廣
除了寫技術博客,我也在做一些讓日常更有條理的小工具,歡迎瞭解我獨立開發的兩款 App:
- 日常收支小記:記下收支,也給每一筆錢安排好去處。記錄日常賬目,安排預算與儲蓄目標。在 App Store 瞭解。
- 一事微光:從一件小事開始,讓今天多一點微光。按當下的時間和精力選擇行動,記錄完成後的感受與發現。在 App Store 瞭解。
更多技術文章和個人作品,歡迎來我的網站:zffjzz.top。也歡迎把使用感受告訴我,讓這些小工具慢慢變得更好。