- 日期:2026-10-25
- 读者:研究生、科研新人和工程型研究者
- 实际范围:4 条已观察的 SciFact 开发探针,每条固定 50 个候选;真实 MiniLM 计分 400 对;不使用确认集。
摘要:正交互不等于两个模块都有效
假设一套方法包含“让证据更靠前”和“保留原检索排名”两个改动。把二者一起打开,结果比原始模型高,能否认定两个模块都有效?不能:其中一个可能有害,另一个只是缓解了它造成的退步。
本次完整运行四种组合,得到一个值得保留的反例:平均交互效应为正,但证据前移在两种排序背景下都降低平均分;两个模块同时使用,也没有超过只做排名融合。这个结论只描述四条诊断材料,不是总体性能判断。复现的价值在于把“哪个模块有用”拆成可核查的条件效应,而不是再画一张看起来合理的模块图。
一、研究目标:接上已有问题,而非另起炉灶
前一篇在一百条开发查询上比较纯交叉编码器与固定排名融合。本篇沿用同一条检索研究主线,接回已登记的“上下文保留与排名融合是否互相影响”。新增变量只有是否启用两项操作;模型、候选、标签、长度限制和融合常数保持冻结。
交叉编码器,简称 CE,把查询和文档一起输入模型,为这一个配对输出相关性分数。倒数排名融合,简称 RRF,则把各系统给出的名次变成倒数再相加。RRF 原论文报告了多个检索系统融合的实验;它并没有承诺所有文本改写都会与融合协同。本篇检验的是自己的组合,不能借用论文结论作为结果。
SciFact 原论文同时提供科学断言、证据文档和证据句标注。BEIR提供检索评测框架。我们评估相关文档的位置,不评估断言是否成立,也不声称复现了完整科学事实核验系统。
二、核心思想:把一次删除变成四个格子
消融实验是移除或关闭某项操作,观察其余条件固定时的变化。若只从完整系统删掉一个模块,测到的只是“另一个模块已经开启时”的贡献。要知道它会不会依赖另一个模块,至少需要把四个格子补齐。
令 表示原文, 表示把原数据集标注的证据句移到摘要前部;令 表示按 CE 排序, 表示融合 CE 与原候选排名。这里的前移保留标题、全部句子及各句内部内容,但改变句间顺序。它使用已知答案相关信息,是 oracle 诊断:为理解失效机制借用金标准信息,不能作为真实检索方案部署。
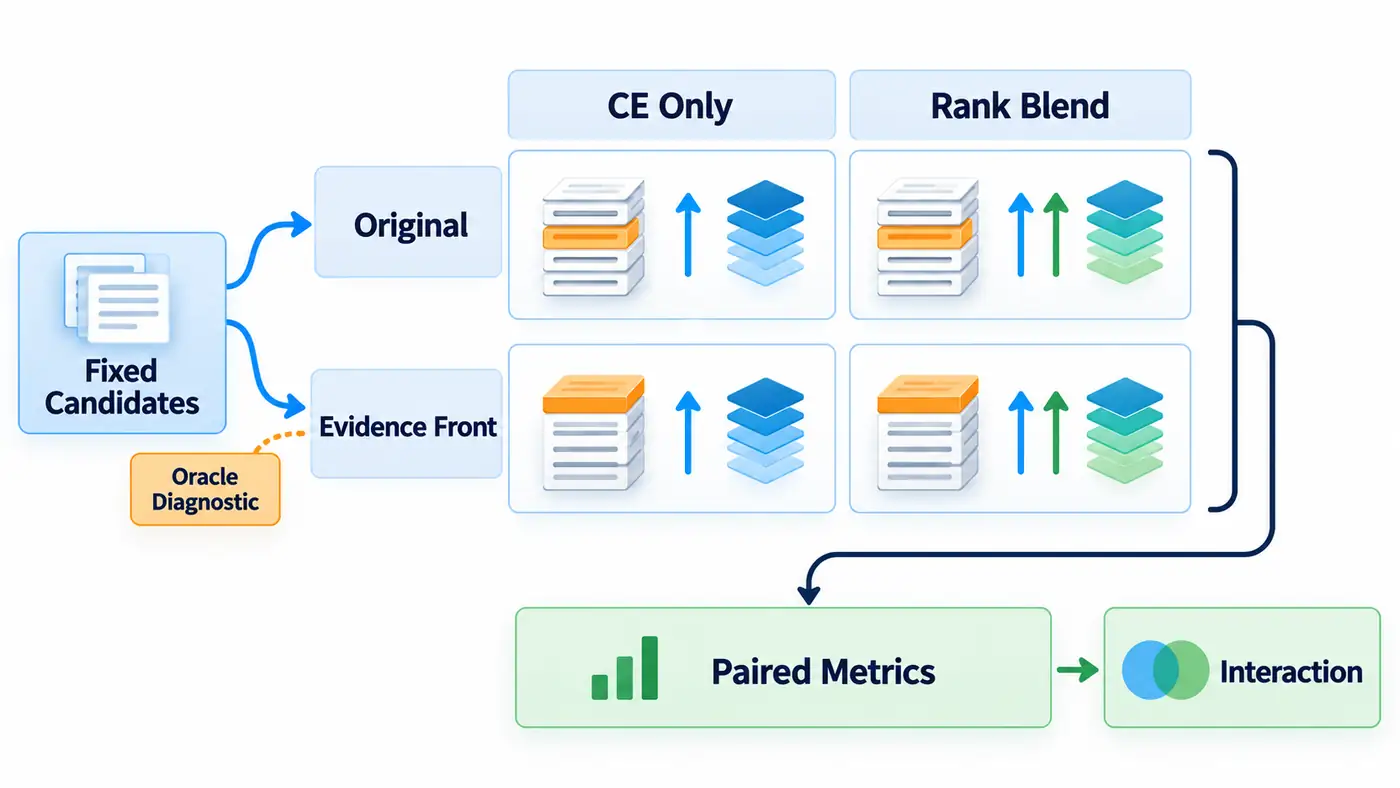
图中四格共享候选集合,最后按同一查询配对计算指标。图内图标仅说明流程,不表示测量值。材料复用此前两长两短四条探针,原文与前移版本及其审核记录逐字节固定;本次没有新造改写或重新挑选“效果明显”的样本。此前原文、前移、后移分数已经观察过,因此这也不是结果盲的首次验证。长短分组继承之前的前移/后移可见性规则,不保证原文与前移之间一定新增了可见证据。因此,操作名称只是输入处理方式,不能直接当作已经实现的机制。先核对每条材料的可见性记录,再解释具体变化,才能避免把预期效果写进实验定义。
三、公式:先说明在哪个背景下有效
记 为查询 在操作组合 下的 nDCG@10。它把前十名相关文档的折扣收益除以理想排序收益,值越大表示相关文档越靠前。本组每条查询恰有一个相关文档,若其名次 ,则 ,否则为零。
交互量定义为:
方括号分别是前移背景、原文背景下启用融合的增益;差值为正,只表示融合在前移后带来更大的增益,不表示前移本身有益。也可以交换两因素的角色,得到同一个差中之差。
融合采用已经冻结的公式:
是同一候选集中的文档, 是原 RRF 候选名次, 是当前文本条件下的 CE 名次,均从一开始。常数六十与等权重不调优;同分按文档标识字符串降序排序。融合的是“原融合排名与重排排名”,不是重新训练模型,也没有扩大候选集。
跨另一个因素平均的贡献同样可以计算,但不能掩盖条件:例如 的平均效应是两种 背景下前移效果的算术平均。本文同时保存条件效应、平均效应和每条交互,不仅报告一个总数。
四、官方代码阅读路线与最小实验
先读 BEIR 的 Rerank.rerank:它怎样拼接标题与摘要,怎样把批量分数放回查询和文档标识。再读 Sentence Transformers 的 smart_batching_collate_text_only 和 predict:联合输入采用最长侧优先截断,最大总长为五百一十二个 token;token 是分词器处理后的输入单位。最后检查 BEIR 评测代码如何调用 pytrec_eval。固定提交、具体行号和本地对应路径全部列在源码地图中。
本次实际使用 ms-marco-MiniLM-L6-v2,冻结模型与分词器 revision 为 233902d25c440f23af6f7d6e94d2946bac0bee0a。运行环境为 Python 3.12、PyTorch 2.6.0、Sentence Transformers 3.4.1,CPU、单精度、四线程、批量十六。原始 logit 是模型输出的未归一化标量,不作为正确概率解释。模型卡说明训练任务为 MS MARCO,本文没有重新训练,也没有套用卡片中的硬件速度。
先用四条查询各自的原前两名加相关文档试跑,本次合并去重后是十六对计分;再运行两种文本条件各二百对。四格只需两轮真实模型评分,因为每轮分数可以同时用于纯 CE 和融合。另有四对形状核对前向,单独记账。抽查输入形状为 ,最后隐层为 ,输出为 :三者分别表示批量与长度、批量与长度与隐藏维、批量与单个相关性分数。
五、评测协议与本次实际结果
四条查询都来自已观察开发数据;相关文档已经在固定五十个候选中,因此所有格子的 Recall@50 都为一。不能据此声称召回问题已解决,这只是探针选择的结果。下面给出全部正式结果,列名中的两个数字依次对应 与 。
| 查询/组别 | 原文 CE(00) | 前移 CE(10) | 原文融合(01) | 前移融合(11) | 交互 |
|---|---|---|---|---|---|
| 454/长 | 1.000000 | 1.000000 | 1.000000 | 1.000000 | 0.000000 |
| 30/长 | 1.000000 | 0.630930 | 1.000000 | 1.000000 | 0.369070 |
| 280/短 | 1.000000 | 1.000000 | 1.000000 | 1.000000 | 0.000000 |
| 155/短 | 0.630930 | 0.430677 | 1.000000 | 0.630930 | -0.168817 |
| 四条均值 | 0.907732 | 0.765402 | 1.000000 | 0.907732 | 0.050063 |
本次实际验证:前移在纯 CE 下平均降低 0.142331,在融合下平均降低 0.092268。融合在原文下提高 0.092268,在前移后提高 0.142331;两者之差就是正交互 0.050063。若只比较“全开”与“全关”,两者均值相同,会把内部的退步与恢复一起掩盖。
查询三十最容易理解:相关文档在原文 CE 中第一,前移后第二,融合又把它恢复第一。正交互来自对退步的缓解。查询一百五十五则不同:CE 排名由第二降至第四,融合分别给出第一与第二;原文背景下融合收益更大,故交互为负。两条不变查询也必须保留;排名指标有台阶和上限,分数变化可能没有跨越名次,零交互并不代表内部计算完全没变。
六、失败排查:算术正确之外还要核对什么
首先核对输入身份。四条材料与既有审核包哈希一致,非目标文档的 token 序列与分数跨文本条件完全相同。本次四百个分数与此前对应计分逐项相同;这是新推理完成后的对照,不是把缓存重放包装成新运行。原文重建、句序、候选清单或标识关联任何一项不符,都应先修复流程,不能先解释指标。
其次核对资源账。两种文本条件各使用 75683 个非填充 token,逐配对长度相等,但可见内容与位置不同;等长不等于等信息。实际推理共 10.56 秒,完整入口约 13.22 秒,进程峰值常驻内存 775897088 字节。初始检索成本没有重测;这些是本机一次测量,不是模型性能保证。融合没有增加模型调用,不能把四格误记成八百次模型推理。
最后独立复算。单独脚本从原始配对分数重建排名,用标准库计算指标与交互,用有理数核对倒数分数,再与官方评测结果比较;同时检查七种故意损坏的证据是否被拒绝。命令、退出码和输入哈希随包保存。首次审计命令因工作目录错误未执行,随后在正确目录通过;源码下载的首次网络失败也保留记录。没有把自动复算称为人工语义判断。
七、研究问题:这份消融证据能支持到哪里
作者推断:本组结果不支持“证据前移必然改善排序”,也不足以把正交互解释成一般协同。前移同时改变语篇顺序、证据位置和截断后留下的上下文;即使完整文档标签保持,也不能证明模型只响应证据可见性。短材料没有截断仍会退步,是需要保留的反例。
后续可检验的问题是:融合收益是否主要来自恢复原检索的高位文档,而不是“理解了更多证据”?目前只有四条非随机探针,两组各两条,且结果存在天花板。不能用四格当四个独立样本计算显著性,也不把重复同一确定性推理当新增样本。扩展实验需要先固定更多材料的选取、变换有效性与分组规则,再观察结果。
本篇不以诊断结果替换已经登记的确认方案。下一篇汇总这条研究主线的条件与失败;最终报告仍保留原文 CE、固定融合及原排名对照,届时才使用尚未评测的三百条确认查询。金标准辅助的前移操作不进入候选方法,也不在看到确认结果后调常数。
源码与复现入口
已发布并匿名核验的固定版本:完整源码目录、README 运行说明、SOURCE_MAP 源码地图。其中包含精确依赖、锁定资源、协议、全部配对分数与独立审计脚本;远端与本地归档逐文件一致。
按 README 准备环境和经哈希核验的缓存后,最小真实运行命令为:
python run.py --cache ./cache --out replay-smoke --smoke
预期产物为两组模型分数、四格排序、逐查询条件效应、交互、token 与资源账。去掉最后一个参数才运行本文四百对正式范围;试跑的小候选集不能用于替代正式指标。仅复核保存结果可执行 python audit.py --out results,不需要重新下载模型。包内已包含所需自写模块,完整数据与权重通过固定来源获取。
总结
一个模块的贡献必须说明“在谁已经开启的条件下”。四格对照的价值,是把下降、恢复与组合效果分开。本次最有用的发现不是一个正号,而是正交互背后两条方向相反的查询,以及“全开并不最好”的边界。
参考资料
检索与固定源码核验日期:2026-10-25。论文结论、模型说明与本次实验分别使用,不把官方基准数字当作本次结果。
- Wadden、Lin、Lo、Wang、van Zuylen、Cohan、Hajishirzi,2020,Fact or Fiction: Verifying Scientific Claims,EMNLP。
- Thakur、Reimers、Rücklé、Srivastava、Gurevych,2021,BEIR: A Heterogenous Benchmark for Zero-shot Evaluation of Information Retrieval Models,NeurIPS 数据集与基准赛道。
- Cormack、Clarke、Büttcher,2009,Reciprocal Rank Fusion outperforms Condorcet and individual Rank Learning Methods,SIGIR。
- Sentence Transformers,MiniLM 交叉编码器固定模型卡。链接使用已成功读取并核验的官方固定版本原文。
- BEIR,固定版本 Rerank 实现;Sentence Transformers,固定版本 CrossEncoder。
作者作品推广
除了写技术博客,我也在做一些让日常更有条理的小工具,欢迎了解我独立开发的两款 App:
- 日常收支小记:记下收支,也给每一笔钱安排好去处。记录日常账目,安排预算与储蓄目标。在 App Store 了解。
- 一事微光:从一件小事开始,让今天多一点微光。按当下的时间和精力选择行动,记录完成后的感受与发现。在 App Store 了解。
更多技术文章和个人作品,欢迎来我的网站:zffjzz.top。也欢迎把使用感受告诉我,让这些小工具慢慢变得更好。