- 日期:2026-09-26
- 讀者:研究生、科研新人和工程型研究者
- 範圍:完整語料、全部開發查詢、一個凍結模型;不是官方測試榜單。
- 交付狀態:配套源碼已公開,固定提交、文件哈希和讀者入口已核驗。
摘要:平均落後,也可能提供新證據
上一篇把 SciFact 的數據、標註和 BM25 鏈路鎖定了。本篇只推進一個問題:換成真實預訓練的句向量模型後,同一批查詢究竟有哪些改善、哪些退步?Embedding 是把文本編碼成可比較的稠密向量;BM25 則主要根據詞項匹配、詞頻與文檔長度打分。名字更新、參數更多,都不能代替對照實驗。
本次實際驗證:在相同的 5183 篇文檔和 809 條開發查詢上,all-MiniLM-L6-v2 的 nDCG@10 為 0.6602,BM25 為 0.6943。逐查詢分解為 150 勝、444 平、215 負。不過,稠密檢索找回了 BM25 在前一百名完全遺漏的 25 條查詢。平均落後和局部互補可以同時成立;這比一句“向量檢索不行”更適合作為後續研究起點。
一、復現價值:把比較對象說清楚
Sentence-BERT 論文提出用孿生網絡等訓練方式形成可用餘弦相似度比較的句向量;它提供方法依據,不是本文這個 MiniLM 檢查點在 SciFact 上獲勝的證據。論文與模型卡必須分開讀。BEIR 論文也強調跨任務檢索評價,不能從一個集合反推所有領域。BEIR
本次沒有訓練,也沒有搜索十個模型再挑贏家。選擇 MiniLM 是為了在 CPU 上完成真實編碼、窮盡相似度計算和逐例審計。凍結模型、最大長度、拼接方式和指標後才運行;結果不理想也保留。較 082 新增的是稠密表示及配對比較,複用的是語料、開發查詢、相關性標註和舊 BM25 排名。
還要保留上一篇最關鍵的語義邊界:這裡的 qrels 是查詢到相關文檔的映射,在該導出中對應 cited_doc_ids,不能等同於科學證據支持標籤。找到相關論文不代表判對主張真假。BEIR train 對應原始 train;本系列留出的 BEIR test 對應原始 dev,本篇沒有執行其檢索。SciFact
二、核心思想與公式:從文本到排名,再到差值
編碼器先產生 token 表示,再按注意力掩碼做均值池化並歸一化:
這裡 是第 個 token 的 384 維表示, 為有效位置掩碼;padding 不參與均值,特殊 token 仍參與。批量隱狀態形狀為 [B,L,384],池化後為 [B,384]。完整查詢、文檔矩陣分別為 [809,384] 與 [5183,384],相似度覆蓋全部 4193047 個查詢—文檔對,沒有近似索引誤差。
主要指標 nDCG@10 是按名次折扣、再以理想排序歸一化的相關性收益。本數據採用二值相關性,第一名的命中貢獻大於第十名。輔助指標 Recall@100 表示已知相關文檔被前一百名找回的比例,MRR@10 表示首個相關命中的倒數排名,未命中記零。
是同一查詢的同一種指標,。先按查詢 ID 對齊再相減,不能把兩個獨立排序的分數列直接相減。差值大於 記勝,小於其負值記負,其餘為平;平的是指標,並不意味著候選列表相同。
三、官方代碼閱讀路線:檢查默認值,而非只看接口
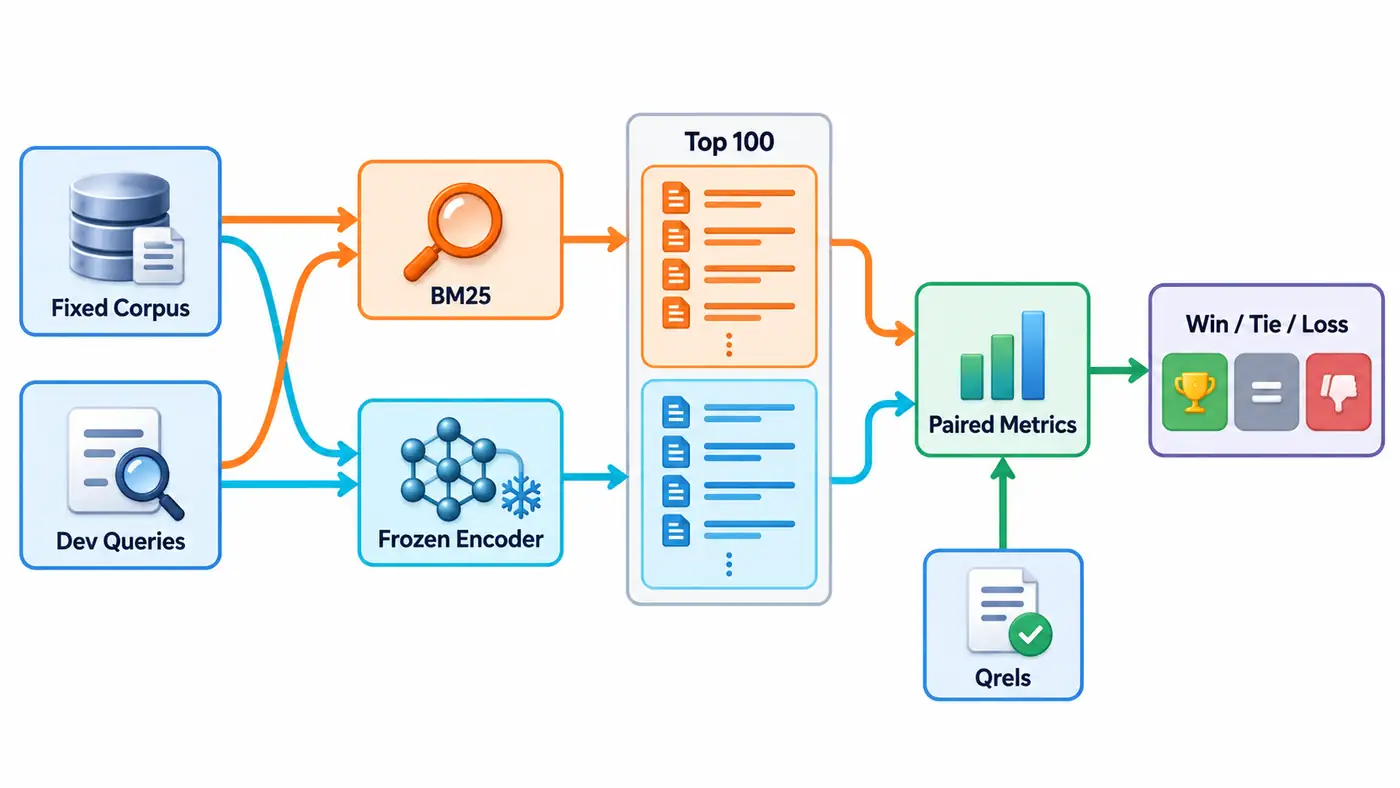
先看固定 revision 的 modules.json:Transformer、均值 Pooling、Normalize 構成實際路徑。再讀 Sentence Transformers 的 encode、Transformer.tokenize、Pooling.forward 與 Normalize.forward,核對評估模式、掩碼和截斷。最後讀 BEIR 的 DenseRetrievalExactSearch.search 與 cos_sim,檢查語料排序、ID 映射和 top-k 返回規則。具體 commit、行號與本地實現對應見源碼地圖;安裝版源碼與官方文件做了全文核對,換行差異單獨記錄。
模型卡說默認截斷超過 256 個 word pieces 的輸入,不能把底層 tokenizer 的長度上限誤當成句向量模型協議。本次顯式設為 256,文檔輸入是標題、一個空格、摘要;查詢不加提示詞。獨立重算兩條輸入的掩碼均值,與官方編碼輸出最大差為零;實測形狀 [2,8,384]→[2,384],模型處於評估模式且可訓練參數數目為零。
BEIR 按長度排序後批處理,再把向量映射回文檔 ID。若只保存矩陣、不保存 ID 順序,結果可能形狀正確而語義全錯。本篇額外保存順序、截斷長度、向量哈希與排名;這些審計層是配套實現,主編碼與搜索仍由官方庫執行。
四、最小實驗與評測協議:什麼被固定,什麼沒有
協議在推理前寫入 PROTOCOL.md。模型和 tokenizer 同用 revision 1110a243fdf4706b3f48f1d95db1a4f5529b4d41,權重等十一文件逐一鎖定哈希。BEIR 固定 ef83d293…,數據繼續使用 082 已驗證的文件哈希;沒有編造數據發佈日期或不可變版本號。
兩邊檢索相同完整語料,各自最多保留一百候選;稠密側沒有先用 BM25 篩文檔。上一篇 BM25 對一條查詢只返回 27 個有效候選,本篇不偽造補齊。兩邊使用同一 qrels、相同並列排序規則和同一獨立評分函數,並與官方評測交叉核對。
公平也有邊界。BM25 使用英文分析器和標題、摘要兩個字段的匹配組合;MiniLM 拼接文本並截斷。它們輸入預算和預訓練計算不等,本篇回答的是“這兩套凍結配置如何不同”,不能隔離出某一種表示的因果優勢。更沒有把模型的歷史訓練成本算成零。
首次導入因缺少 datasets 失敗,日誌保留。補齊後一次命令漏加 smoke 參數,執行了全量開發探索;沒有據此調整配置。隨後完成五查詢、十六文檔的資源檢查,再執行正式全量記錄。正式 CPU 運行採用 float32、四線程、batch 16、種子 83,Python 3.12.14、PyTorch 2.6.0、Sentence Transformers 3.4.1、Transformers 4.49.0。
實測總耗時 58.59 秒,其中查詢編碼約 0.84 秒、文檔編碼約 52.67 秒;進程峰值 RSS 為 1160839168 字節,約 1.08 GiB。總耗時包含導入和加載,排除下載;不是 GPU 顯存,也不能與上一篇已啟動服務的 BM25 查詢耗時直接作端到端速度比。
這種配對協議還有一個容易忽略的好處:它把“模型變了”和“問題換了”分開。若一個檢索器悄悄丟棄空結果查詢,均值就可能虛高;若兩個結果文件少了不同的 ID,直接比較總分會失去共同分母。因此審計程序要求兩邊查詢集合與標註集合完全一致,缺失立即失敗,零命中仍保留在統計裡。候選不足也不能用重複文檔補到一百。
復現實驗還應把結果緩存看成有身份的產物。本篇身份包含模型與 tokenizer revision、空提示詞、無解碼聲明、數據哈希、配置、依賴和源碼哈希;不同身份不共享向量。發佈包只保存必要排名與核驗記錄,大權重、虛擬環境和可重建向量緩存留在本地。讀者從固定下載鎖重建資源後,應先核對退出碼和形狀,再看分數是否接近;跨機器逐位一致性仍待人工核驗。
五、結果:均值如何由勝負構成
| 開發集指標 | BM25 | MiniLM | MiniLM 減 BM25 |
|---|---|---|---|
| nDCG@10 | 0.69427 | 0.66020 | -0.03407 |
| Recall@100 | 0.93506 | 0.93243 | -0.00264 |
| MRR@10 | 0.66252 | 0.62613 | -0.03639 |
主要指標上,勝查詢合計貢獻 ,負查詢貢獻 ,均以全部 809 條為分母,兩者相加就是淨差。不能僅拿獲益子集的均值寫標題。沒有報告顯著性或置信區間:這些開發主張可能共享原始文檔,查詢獨立性未經確認;一個固定模型的一次運行也不能代表模型家族的方差。
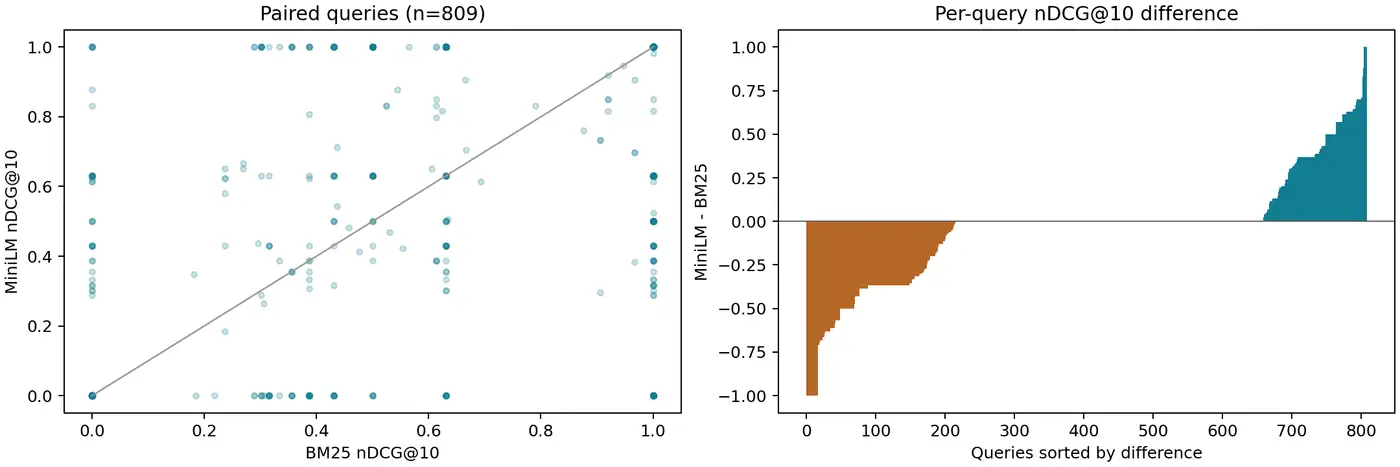
圖由 plot.py 讀取 results/development/paired.csv 生成。左圖每點是一條配對查詢,重疊點不表示只有一條;右圖按差值排序,零差區間並非缺失樣本。
候選覆蓋同樣值得拆開:732 條查詢兩邊至少命中一篇相關文檔,25 條僅稠密命中,30 條僅 BM25 命中,22 條兩邊都未命中。這是“至少一個命中”的分類,不是 Recall@100 的宏平均,尤其不能忽略一條查詢有多篇相關文檔。
六、失敗分析:保留反例,不急著給原因貼標籤
按預登記規則取最大正差、最大負差各三條,並按數值 ID 破除並列。查詢 331 的相關文檔從 BM25 第 71 位升到稠密第 1 位;查詢 69 的兩篇相關文檔卻從第 1、2 位退到第 12、23 位。查詢 199 更直接:BM25 第一名命中,稠密前一百完全未命中。完整六例和文檔 ID 都保存在配對結果中,沒有手工挑“最好講”的例子。
作者推斷:領域縮寫、詞面精確匹配和長摘要信息損失都可能解釋部分退步,但排名本身不能判定原因。本次 3681/5183 篇文檔被截斷,約 71.02%;查詢均未截斷。文檔編碼前共 1747679 個 token,截斷後保留 1242251 個。正例、負例的相關文檔都可能被截斷,因而“看到截斷就歸罪截斷”同樣是事後敘事。
另一個可核查失敗來自數值精度:用 float64 對保存向量重新計算全庫分數,八條查詢的前一百內部順序不同,最大保留分數差約 。專項審計確認它們候選集合及本文所有指標均未改變。正文保留官方 float32 結果,不把低精度重放說成逐位相同。
排查時先確認數據哈希、ID 順序、掩碼、歸一化和截斷,再討論語義。還要防止把未經人工核驗的自動分組稱為“人工錯誤類型金標”。本篇沒有人工標註,也沒有證明模型預訓練語料與 SciFact 零重合;模型卡列出的科學文獻來源使這一邊界尤其需要保留。
七、從現象到可檢驗的研究問題
第一條假設是,兩套排名存在可利用的互補。下一篇只改變融合規則,凍結本篇兩份排名,比較固定候選預算下的 RRF 與單路基線。25 條獨佔命中提供動機,卻不保證融合後能進入前十;如果提升只來自擴大候選預算,就不能歸功於融合公式。
第二條競爭解釋是,稠密模型的退步部分來自輸入裁剪。後續預處理篇應分別控制字段拼接和長度,先登記主要指標及允許的計算增量,再觀察相關文檔的排名變化。延長輸入如果同時增加計算量,也要報告。不能在本篇失敗樣本上不斷試到贏,再把留出的確認集叫成未經選擇的證據。
源碼與復現入口
本篇已發佈到統一倉庫的固定版本源碼目錄,讀者可從README 運行說明、SOURCE_MAP 源碼地圖和統一入口 run.py進入。版本為 8a3b931f2aa147a71db7812177f0ded4283ec9e4;全部 54 個分發文件已匿名拉取,與本地歸檔逐文件校驗一致。目錄保留源碼、配置、依賴、許可證、失敗日誌與逐查詢記錄,大模型權重和完整語料通過鎖定下載腳本獲取。
安裝依賴並執行下載準備後,最小真實命令為 python run.py --cache ./cache --out results/my_smoke --smoke;它運行真實模型的小範圍檢查,不能作為全量分數。去掉 --smoke 才是本文完整開發實驗,產出排名、逐查詢分數、環境與階段狀態。audit.py 可離線重算已保存的 809 條配對結果;向量精度檢查需先運行完整入口生成向量。本次未訓練、未運行確認集、未運行融合,也沒有用 toy 替代模型。
總結
本次凍結 MiniLM 配置沒有超過 BM25,但留下了更有用的研究資產:一組可追蹤的獲益、受損與共同失敗查詢。下一步的價值不是保證“把分數做高”,而是讓互補、截斷和字段處理這些競爭解釋分別接受受控檢驗。讀者可以從已公開的固定版本重放評測,繼續檢驗下一篇的融合假設。
參考資料
檢索與實際訪問日期:2026-09-26;2026-09-27 續跑複核論文、模型卡及固定源碼,完成公開發布。論文結論、模型卡說明與本次實驗分別標示。固定源碼若瀏覽工具緩存失效,已通過官方 raw 下載讀取並記錄哈希。
- Nils Reimers、Iryna Gurevych,2019:Sentence-BERT: Sentence Embeddings using Siamese BERT-Networks。
- Sentence Transformers:all-MiniLM-L6-v2 模型卡,本次權重固定上述 revision。
- Nandan Thakur 等,2021:BEIR: A Heterogenous Benchmark for Zero-shot Evaluation of Information Retrieval Models,v4。
- David Wadden 等,2020:Fact or Fiction: Verifying Scientific Claims。
- Sentence Transformers 3.4.1 固定源碼;BEIR 固定源碼。