- 日期:2026-09-26
- 读者:研究生、科研新人和工程型研究者
- 范围:完整语料、全部开发查询、一个冻结模型;不是官方测试榜单。
- 交付状态:配套源码已公开,固定提交、文件哈希和读者入口已核验。
摘要:平均落后,也可能提供新证据
上一篇把 SciFact 的数据、标注和 BM25 链路锁定了。本篇只推进一个问题:换成真实预训练的句向量模型后,同一批查询究竟有哪些改善、哪些退步?Embedding 是把文本编码成可比较的稠密向量;BM25 则主要根据词项匹配、词频与文档长度打分。名字更新、参数更多,都不能代替对照实验。
本次实际验证:在相同的 5183 篇文档和 809 条开发查询上,all-MiniLM-L6-v2 的 nDCG@10 为 0.6602,BM25 为 0.6943。逐查询分解为 150 胜、444 平、215 负。不过,稠密检索找回了 BM25 在前一百名完全遗漏的 25 条查询。平均落后和局部互补可以同时成立;这比一句“向量检索不行”更适合作为后续研究起点。
一、复现价值:把比较对象说清楚
Sentence-BERT 论文提出用孪生网络等训练方式形成可用余弦相似度比较的句向量;它提供方法依据,不是本文这个 MiniLM 检查点在 SciFact 上获胜的证据。论文与模型卡必须分开读。BEIR 论文也强调跨任务检索评价,不能从一个集合反推所有领域。BEIR
本次没有训练,也没有搜索十个模型再挑赢家。选择 MiniLM 是为了在 CPU 上完成真实编码、穷尽相似度计算和逐例审计。冻结模型、最大长度、拼接方式和指标后才运行;结果不理想也保留。较 082 新增的是稠密表示及配对比较,复用的是语料、开发查询、相关性标注和旧 BM25 排名。
还要保留上一篇最关键的语义边界:这里的 qrels 是查询到相关文档的映射,在该导出中对应 cited_doc_ids,不能等同于科学证据支持标签。找到相关论文不代表判对主张真假。BEIR train 对应原始 train;本系列留出的 BEIR test 对应原始 dev,本篇没有执行其检索。SciFact
二、核心思想与公式:从文本到排名,再到差值
编码器先产生 token 表示,再按注意力掩码做均值池化并归一化:
这里 是第 个 token 的 384 维表示, 为有效位置掩码;padding 不参与均值,特殊 token 仍参与。批量隐状态形状为 [B,L,384],池化后为 [B,384]。完整查询、文档矩阵分别为 [809,384] 与 [5183,384],相似度覆盖全部 4193047 个查询—文档对,没有近似索引误差。
主要指标 nDCG@10 是按名次折扣、再以理想排序归一化的相关性收益。本数据采用二值相关性,第一名的命中贡献大于第十名。辅助指标 Recall@100 表示已知相关文档被前一百名找回的比例,MRR@10 表示首个相关命中的倒数排名,未命中记零。
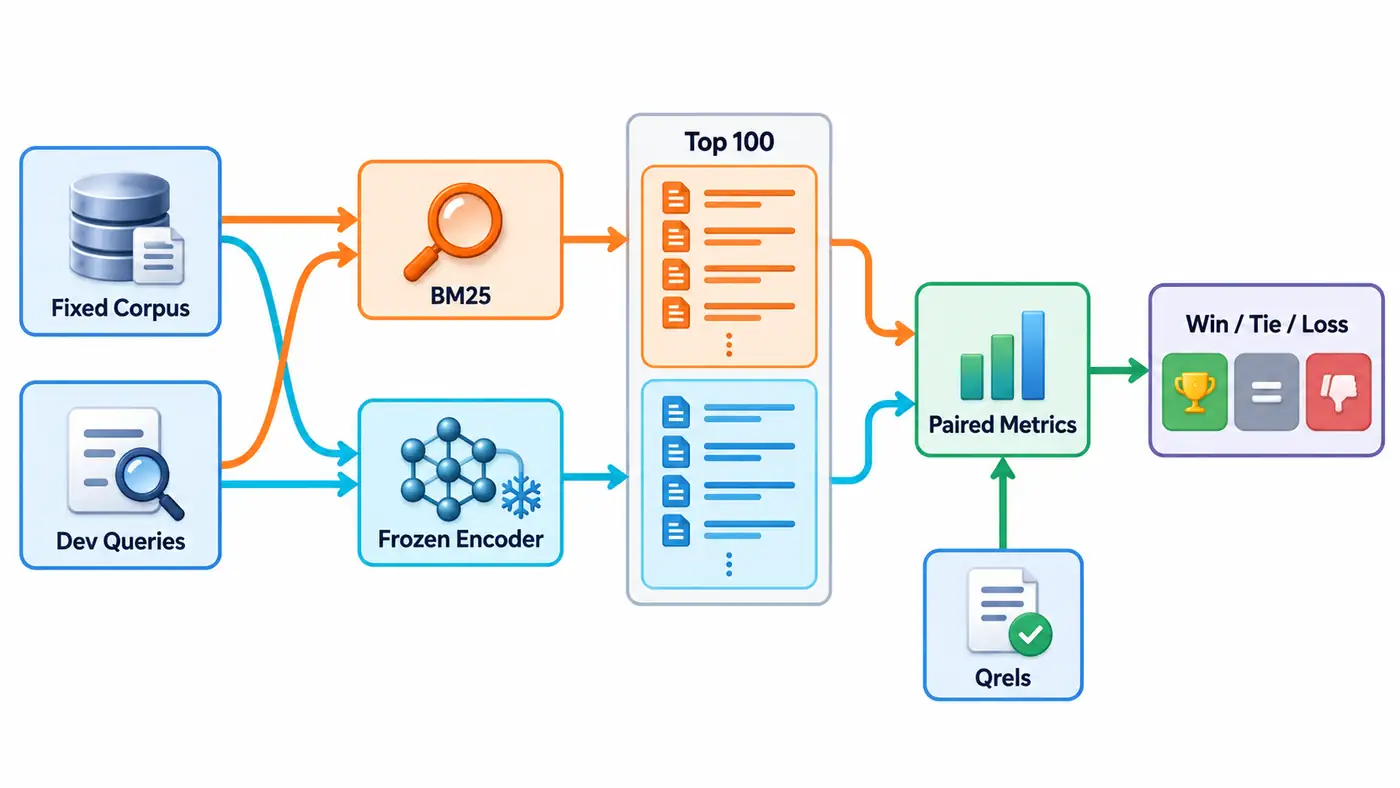
是同一查询的同一种指标,。先按查询 ID 对齐再相减,不能把两个独立排序的分数列直接相减。差值大于 记胜,小于其负值记负,其余为平;平的是指标,并不意味着候选列表相同。
三、官方代码阅读路线:检查默认值,而非只看接口
先看固定 revision 的 modules.json:Transformer、均值 Pooling、Normalize 构成实际路径。再读 Sentence Transformers 的 encode、Transformer.tokenize、Pooling.forward 与 Normalize.forward,核对评估模式、掩码和截断。最后读 BEIR 的 DenseRetrievalExactSearch.search 与 cos_sim,检查语料排序、ID 映射和 top-k 返回规则。具体 commit、行号与本地实现对应见源码地图;安装版源码与官方文件做了全文核对,换行差异单独记录。
模型卡说默认截断超过 256 个 word pieces 的输入,不能把底层 tokenizer 的长度上限误当成句向量模型协议。本次显式设为 256,文档输入是标题、一个空格、摘要;查询不加提示词。独立重算两条输入的掩码均值,与官方编码输出最大差为零;实测形状 [2,8,384]→[2,384],模型处于评估模式且可训练参数数目为零。
BEIR 按长度排序后批处理,再把向量映射回文档 ID。若只保存矩阵、不保存 ID 顺序,结果可能形状正确而语义全错。本篇额外保存顺序、截断长度、向量哈希与排名;这些审计层是配套实现,主编码与搜索仍由官方库执行。
四、最小实验与评测协议:什么被固定,什么没有
协议在推理前写入 PROTOCOL.md。模型和 tokenizer 同用 revision 1110a243fdf4706b3f48f1d95db1a4f5529b4d41,权重等十一文件逐一锁定哈希。BEIR 固定 ef83d293…,数据继续使用 082 已验证的文件哈希;没有编造数据发布日期或不可变版本号。
两边检索相同完整语料,各自最多保留一百候选;稠密侧没有先用 BM25 筛文档。上一篇 BM25 对一条查询只返回 27 个有效候选,本篇不伪造补齐。两边使用同一 qrels、相同并列排序规则和同一独立评分函数,并与官方评测交叉核对。
公平也有边界。BM25 使用英文分析器和标题、摘要两个字段的匹配组合;MiniLM 拼接文本并截断。它们输入预算和预训练计算不等,本篇回答的是“这两套冻结配置如何不同”,不能隔离出某一种表示的因果优势。更没有把模型的历史训练成本算成零。
首次导入因缺少 datasets 失败,日志保留。补齐后一次命令漏加 smoke 参数,执行了全量开发探索;没有据此调整配置。随后完成五查询、十六文档的资源检查,再执行正式全量记录。正式 CPU 运行采用 float32、四线程、batch 16、种子 83,Python 3.12.14、PyTorch 2.6.0、Sentence Transformers 3.4.1、Transformers 4.49.0。
实测总耗时 58.59 秒,其中查询编码约 0.84 秒、文档编码约 52.67 秒;进程峰值 RSS 为 1160839168 字节,约 1.08 GiB。总耗时包含导入和加载,排除下载;不是 GPU 显存,也不能与上一篇已启动服务的 BM25 查询耗时直接作端到端速度比。
这种配对协议还有一个容易忽略的好处:它把“模型变了”和“问题换了”分开。若一个检索器悄悄丢弃空结果查询,均值就可能虚高;若两个结果文件少了不同的 ID,直接比较总分会失去共同分母。因此审计程序要求两边查询集合与标注集合完全一致,缺失立即失败,零命中仍保留在统计里。候选不足也不能用重复文档补到一百。
复现实验还应把结果缓存看成有身份的产物。本篇身份包含模型与 tokenizer revision、空提示词、无解码声明、数据哈希、配置、依赖和源码哈希;不同身份不共享向量。发布包只保存必要排名与核验记录,大权重、虚拟环境和可重建向量缓存留在本地。读者从固定下载锁重建资源后,应先核对退出码和形状,再看分数是否接近;跨机器逐位一致性仍待人工核验。
五、结果:均值如何由胜负构成
| 开发集指标 | BM25 | MiniLM | MiniLM 减 BM25 |
|---|---|---|---|
| nDCG@10 | 0.69427 | 0.66020 | -0.03407 |
| Recall@100 | 0.93506 | 0.93243 | -0.00264 |
| MRR@10 | 0.66252 | 0.62613 | -0.03639 |
主要指标上,胜查询合计贡献 ,负查询贡献 ,均以全部 809 条为分母,两者相加就是净差。不能仅拿获益子集的均值写标题。没有报告显著性或置信区间:这些开发主张可能共享原始文档,查询独立性未经确认;一个固定模型的一次运行也不能代表模型家族的方差。
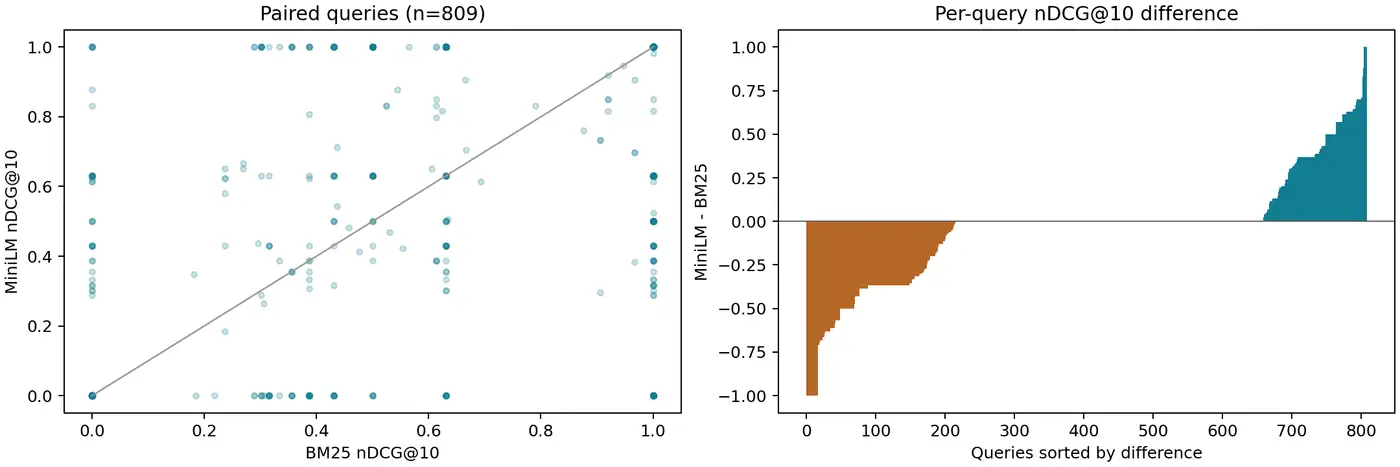
图由 plot.py 读取 results/development/paired.csv 生成。左图每点是一条配对查询,重叠点不表示只有一条;右图按差值排序,零差区间并非缺失样本。
候选覆盖同样值得拆开:732 条查询两边至少命中一篇相关文档,25 条仅稠密命中,30 条仅 BM25 命中,22 条两边都未命中。这是“至少一个命中”的分类,不是 Recall@100 的宏平均,尤其不能忽略一条查询有多篇相关文档。
六、失败分析:保留反例,不急着给原因贴标签
按预登记规则取最大正差、最大负差各三条,并按数值 ID 破除并列。查询 331 的相关文档从 BM25 第 71 位升到稠密第 1 位;查询 69 的两篇相关文档却从第 1、2 位退到第 12、23 位。查询 199 更直接:BM25 第一名命中,稠密前一百完全未命中。完整六例和文档 ID 都保存在配对结果中,没有手工挑“最好讲”的例子。
作者推断:领域缩写、词面精确匹配和长摘要信息损失都可能解释部分退步,但排名本身不能判定原因。本次 3681/5183 篇文档被截断,约 71.02%;查询均未截断。文档编码前共 1747679 个 token,截断后保留 1242251 个。正例、负例的相关文档都可能被截断,因而“看到截断就归罪截断”同样是事后叙事。
另一个可核查失败来自数值精度:用 float64 对保存向量重新计算全库分数,八条查询的前一百内部顺序不同,最大保留分数差约 。专项审计确认它们候选集合及本文所有指标均未改变。正文保留官方 float32 结果,不把低精度重放说成逐位相同。
排查时先确认数据哈希、ID 顺序、掩码、归一化和截断,再讨论语义。还要防止把未经人工核验的自动分组称为“人工错误类型金标”。本篇没有人工标注,也没有证明模型预训练语料与 SciFact 零重合;模型卡列出的科学文献来源使这一边界尤其需要保留。
七、从现象到可检验的研究问题
第一条假设是,两套排名存在可利用的互补。下一篇只改变融合规则,冻结本篇两份排名,比较固定候选预算下的 RRF 与单路基线。25 条独占命中提供动机,却不保证融合后能进入前十;如果提升只来自扩大候选预算,就不能归功于融合公式。
第二条竞争解释是,稠密模型的退步部分来自输入裁剪。后续预处理篇应分别控制字段拼接和长度,先登记主要指标及允许的计算增量,再观察相关文档的排名变化。延长输入如果同时增加计算量,也要报告。不能在本篇失败样本上不断试到赢,再把留出的确认集叫成未经选择的证据。
源码与复现入口
本篇已发布到统一仓库的固定版本源码目录,读者可从README 运行说明、SOURCE_MAP 源码地图和统一入口 run.py进入。版本为 8a3b931f2aa147a71db7812177f0ded4283ec9e4;全部 54 个分发文件已匿名拉取,与本地归档逐文件校验一致。目录保留源码、配置、依赖、许可证、失败日志与逐查询记录,大模型权重和完整语料通过锁定下载脚本获取。
安装依赖并执行下载准备后,最小真实命令为 python run.py --cache ./cache --out results/my_smoke --smoke;它运行真实模型的小范围检查,不能作为全量分数。去掉 --smoke 才是本文完整开发实验,产出排名、逐查询分数、环境与阶段状态。audit.py 可离线重算已保存的 809 条配对结果;向量精度检查需先运行完整入口生成向量。本次未训练、未运行确认集、未运行融合,也没有用 toy 替代模型。
总结
本次冻结 MiniLM 配置没有超过 BM25,但留下了更有用的研究资产:一组可追踪的获益、受损与共同失败查询。下一步的价值不是保证“把分数做高”,而是让互补、截断和字段处理这些竞争解释分别接受受控检验。读者可以从已公开的固定版本重放评测,继续检验下一篇的融合假设。
参考资料
检索与实际访问日期:2026-09-26;2026-09-27 续跑复核论文、模型卡及固定源码,完成公开发布。论文结论、模型卡说明与本次实验分别标示。固定源码若浏览工具缓存失效,已通过官方 raw 下载读取并记录哈希。
- Nils Reimers、Iryna Gurevych,2019:Sentence-BERT: Sentence Embeddings using Siamese BERT-Networks。
- Sentence Transformers:all-MiniLM-L6-v2 模型卡,本次权重固定上述 revision。
- Nandan Thakur 等,2021:BEIR: A Heterogenous Benchmark for Zero-shot Evaluation of Information Retrieval Models,v4。
- David Wadden 等,2020:Fact or Fiction: Verifying Scientific Claims。
- Sentence Transformers 3.4.1 固定源码;BEIR 固定源码。