- 日期:2026-10-05
- 读者:研究生、科研新人和工程型研究者
- 范围:真实小模型、六种模板、两种模型状态;开发实验,非完整基准。
- 验收状态:计算、自动审计与真人标签保持审查均已通过;人工结论依据用户于十月五日在本会话中的直接确认。
摘要
上一篇改变训练数据混合比例,却没有得到可信的新闻能力保持收益。本篇固定已选定的检查点,把问题缩小为:同一条影评换一种问法,微调收益还存在吗?我们复用六十四条情感开发样本和三十二条新闻开发样本,运行六百四十次真实生成。微调后的原 JSON 模板与指令改写都答对五十八条,但互有一条得失;交换指令顺序后只剩五十五条,格式仍全部合格。原单词输出约定则从五十七条降至三十三条。结果说明,格式、内容和任务迁移必须分别测量。用户已确认真人标签保持审查通过;这仍是有完整日志的开发探索,不能据此改称盲测。
目录
- 复现价值与核心思想
- 公式、变量与评测协议
- 官方代码阅读路线
- 最小实验与源码入口
- 结果、失败排查与研究问题
- 总结与参考资料
一、复现价值:别把熟悉的输出当成普遍能力
监督微调,即用输入和目标回答更新模型参数,可能同时改变任务判断、回答措辞和输出格式。只在训练时的提示上测成功率,无法分开这些变化。JSON 是一种结构化文本格式;生成合法对象并不保证对象中的情感判断正确。反过来,写出正确情感词却多加解释,也可能不满足接口约定。
论文报告:Sclar、Choi、Tsvetkov 与 Suhr 的 ICLR 2024 论文研究语义保持的提示格式变化,建议考察多种合理格式下的表现范围。原论文 v2支撑“单一提示不足以刻画稳健性”,并不提供本实验的预期分数。Yan 等人的对比式指令微调论文进一步研究等价指令的表示一致性;本文没有运行其训练算法,不能借用论文提升作为自己的证据。
相较 091,本篇新增变量是用户指令的呈现方式,冻结模型状态、原始文本、标签映射、聊天包装和解码规则。模型来自 SmolLM2-135M-Instruct,原始检查点本身已经过指令微调;“微调前”只表示我们这一小段增量训练之前,绝不是未经训练的语言模型。
二、核心思想:沿三个距离逐步外推
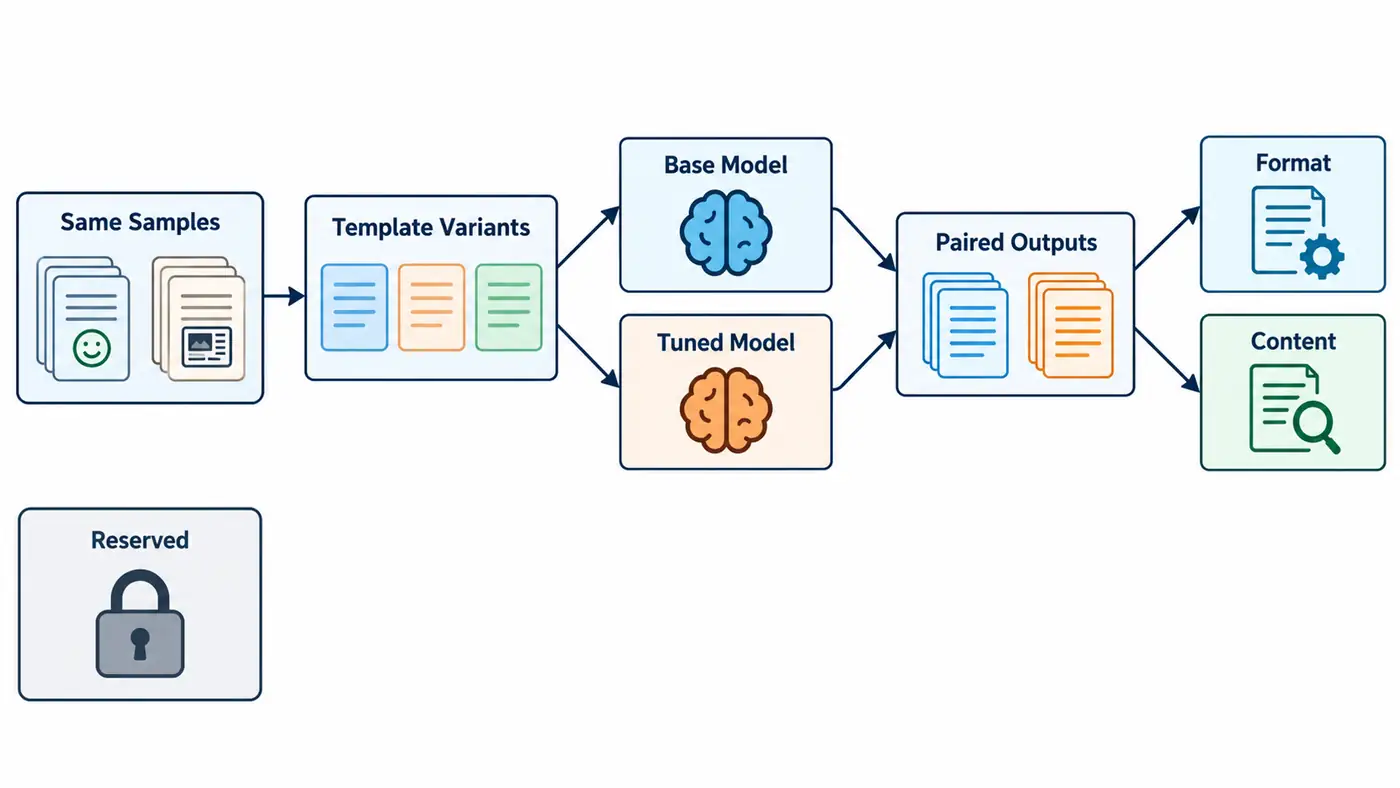
最近的一层是同一任务、同一输出约定,只改任务句的措辞。主对照把“分类这条影评的情感”改成“判断这条影评表达的情感”,保留 positive/negative 标签及完整 JSON 要求。第二个变体仅交换任务句与输出要求的前后位置,二者是次要对照,不能看完结果再挑表现更好的一个作结论。
再远一层沿用原 plain 模板,要求只输出一个小写情感词。这同时改变输出约定,不能归因于同义改写。最远一层是新闻主题分类,用 A/B/C/D 对应 World、Sports、Business、Science and Technology,并比较原指令与改写指令。两层诊断帮助限定收益,但不与主对照混为一个平均分。
新闻没有进入所选 target_only 检查点的增量训练,却在 091 参与过开发集选择;预训练数据也不可完全追溯。因此这里只能叫“训练排除的任务族”,不能叫从未接触的任务或盲测迁移。二元情感与四类新闻的难度、类别数不同,也不宜横向比较原始准确率高低。
三、公式与评测协议:格式和内容各记一笔
记第 i 个样本在模板 t 下的严格格式是否合格为 F_it,输出中唯一显式类别是否匹配原标签为 C_it。联合正确定义为:
这里 F、C、J 均取零或一;n 是同一任务的样本数,零号模板是原模板。每行差值属于负一、零、正一,对应输、平、赢。计算按原样本配对,不把一个样本的多个模板当成独立观测。正文只报计数和描述性差值,没有置信区间或多种子稳定性声明。
格式评分拒绝额外 JSON 键、重复键、错误大小写和对象外解释。内容评分沿用既有唯一标签抽取器;一段同时含 positive 和 negative 的回答视为歧义,不由程序猜其真实意图。C 是可重算的内容代理,不能称为人工语义准确率。条件正确率也不能只保留格式成功样本而省略分母,否则最难回答可能悄悄消失。
语义保持属于另一项证据。程序已检查原文逐字不变、标签和类别映射不变,并在推理前生成不含模型答案的人工审查包,共三百二十个模板与样本组合。用户随后在本会话直接确认“真人审查通过了”,我们据此记录回顾性审查通过,并保存确认原文及审查包哈希。用户未另交逐行批注及精确审查完成时间,因此保留原空表,不代填三百二十条判断,也不把确认记录时间冒充审查发生时间。
四、官方代码阅读路线:从输入到输出追一条样本
先读固定模型卡和 tokenizer 配置,确认聊天模板及特殊符号,再进入 Transformers 的 apply_chat_template。本篇修改的是用户消息内部的任务句,角色包装没有变化。拼接后再次分词时禁用重复添加特殊符号,并记录提示哈希和长度。源码地图列出核验过的永久行号。
随后读 LlamaForCausalLM.forward 和 generate 的贪心分支。实际首条输入为 [1,83],隐藏表示为 [1,83,576],词表 logits 为 [1,83,49152];三个维度分别是批量、序列长度及隐藏宽度或词表大小。首个生成 token 与末位置 logits 最大值一致,检查能发现截取输入前缀等常见错误,但不证明答案正确。
为让读者独立恢复微调检查点,入口同时包含六十四步训练重建。官方因果交叉熵会移位标签,我们传入未移位标签,只监督助手回答到真实结束符,前缀与填充为忽略值。每步十六个有效监督 token,总计一千零二十四个;独立移位损失与官方结果的最大差约为一亿分之十二。EOS 与 padding 使用同一编号时,必须依据真实长度保留有效 EOS。
实际安装的四个 Transformers 文件与一个 PyTorch SGD 文件均同固定官方提交逐字节一致。教学代码独立负责实验编排、掩码和评测,没有声称复现官方完整训练配方;许可证、提交与本地模块对应关系写入 SOURCE_MAP。
五、最小实验与源码复现入口
公开源码已发布并匿名核对五十六个文件:固定提交目录、README 与复现说明、SOURCE_MAP 与官方代码对应。公开确认记录补充了真人审查结论,运行时的待审日志仍保留为历史证据。
模型和 tokenizer 固定 revision 为 12fd25f77366fa6b3b4b768ec3050bf629380bac;SST-2 与 AG News 的精确 revision、二十个资源文件哈希均在资源锁中。情感训练三十二条、开发六十四条沿用旧划分;新闻三十二条开发样本每类八条。一百二十八条情感和六十四条新闻确认样本从未推理。开发样本已被反复分析,不能换个名称重新当测试集。
安装锁定依赖、执行下载校验后,最小入口如下,目录由读者自行指定:
python run.py --cache ./cache --out smoke-new --private ./private-new --smoke
python audit.py --cache ./cache --out smoke-new
试跑仍重建全部六十四步训练,只缩小推理到两条情感、四条新闻,共三十二次生成。预期产物包括逐步损失、检查点参数哈希、逐例预测、配对结果及环境记录。试跑用时二十七点四秒,峰值约二点六五 GiB;重建参数和全部训练步的损失、梯度范数与 091 一致。
正式实验直接复用已核验的 091 检查点,没有新增更新;六百四十次生成耗时九十二点七秒,峰值约一点六零 GiB,均是本机 CPU 实测、导入依赖之后计时。设备为 Apple 平台 CPU,Python 3.12.14、PyTorch 2.6.0、Transformers 4.49.0,四线程、单精度、贪心生成上限三十二 token,GPU 内存未测。
缓存身份同时记录模型、tokenizer、数据、模板、提示、解码、代码和检查点哈希。恢复时核对的是参数内容,不应把因序列化文件名变化造成的文件哈希差异误判为训练不一致。数据卡许可证不明确,分发包不含原影评、新闻、权重或输入 token;可用固定下载入口重建。
六、实际结果:同分也可能互有损失
下表每格依次为格式合格、内容代理正确、联合正确的数量。
| 模板 | 样本数 | 微调前 F/C/J | 微调后 F/C/J |
|---|---|---|---|
| 原 JSON | 64 | 0/50/0 | 64/58/58 |
| 改写任务句 | 64 | 0/54/0 | 64/58/58 |
| 交换指令顺序 | 64 | 0/53/0 | 64/55/55 |
| 原 plain | 64 | 64/57/57 | 64/33/33 |
| 原新闻 | 32 | 30/8/8 | 29/8/8 |
| 改写新闻指令 | 32 | 31/8/8 | 29/7/7 |
本次实际验证:主对照微调后有一赢、六十二平、一输,净差为零。编号 650 从正确 negative 变成错误 positive,736 则反向改善。两者相抵不表示输出完全相同,也不能只展示改善案例。交换顺序出现一赢、五十九平、四输,净损失三条;237、178、436、571 都从正确负向变成错误正向,222 改善。
这些输出全部满足 JSON 约定,因此这一局部损失不能归因于 JSON 解析失败。原 plain 的格式也始终全过,但内容下降二十四条。新闻则仍在每类均衡样本上接近恒定分类器的八条正确地板,无法据此证明已获得稳定的可迁移新闻能力。
输入长度与成本另列在日志。任务句改写使每条影评多两个输入 token;交换顺序的总输入 token 与原模板相同,但位置不同。微调前改写模板有十七条达到生成长度上限,原模板只有一条。因此差异可能混有输出长度与抽取行为,不能统称为“纯语义敏感”。
七、失败排查与可检验研究问题
先排工程错误:检查权重哈希、样本集合、标签对应、提示原文、截断和计分器。本次没有输入截断;原始六百四十条输出已逐条重解析,八个解析边界用例通过。公开包对八条可能复述原数据的长输出保留哈希和派生分数,六百三十二条可直接重解析;完整原始审计留在本地,公开审计的覆盖差异明确记录。
再排解释越界。作者推断是:当前更新可能较稳定地适应了 JSON 回答,却没有在所有输出约定下改善情感判断。这个推断与表中现象相容,但尚未通过因果干预验证。单个小模型、单种子、少数英语开发样本和有限模板,都限制外推范围。
后续可检验两个竞争解释:其一,损失来自指令位置;其二,损失主要来自输出约定引起的类别偏置。人工变换审查通过后,下一步应登记等 token 长度的位置对照,并按冻结方案在多个训练种子上复测。若不同种子下损失方向反复变化,就应撤回稳定模板效应的判断;若只在 plain 出现类别塌缩,则优先研究输出约定。不能看完确认集再改模板寻找胜出。
八、总结
本次最有价值的证据不是一个漂亮总分,而是同分模板中的一赢一输、格式完全正确时仍出现的内容损失,以及新闻低基线带来的解释上限。正文、源码、图像和日志已经保存,用户也已确认真人审查通过。计算验证与人工确认各有记录,原始失败和探索边界继续保留;完成本篇验收后,下一篇进入多种子研究。
参考资料
检索并实际打开日期:2026-10-05;以下均为一手材料。
- Melanie Sclar、Yejin Choi、Yulia Tsvetkov、Alane Suhr,ICLR 2024:Quantifying Language Models’ Sensitivity to Spurious Features in Prompt Design,v2。
- Tianyi Yan 等,Findings ACL 2024:Contrastive Instruction Tuning。
- HuggingFaceTB:SmolLM2-135M-Instruct 固定模型卡。
- Richard Socher 等,EMNLP 2013:Recursive Deep Models for Semantic Compositionality Over a Sentiment Treebank;SST-2 固定数据卡。
- Xiang Zhang、Junbo Zhao、Yann LeCun,2015:Character-level Convolutional Networks for Text Classification;AG News 固定镜像数据卡。
- Hugging Face 与 PyTorch:固定生成实现、固定 SGD 实现。