- 日期:2026-09-23
- 適合讀者:研究生、科研新人和工程型研究者
- 復現範圍:整理 052–080 的證據索引,封裝並重放 080 的報告實驗;不重新訓練模型。
摘要
一個月後,最容易丟失的往往不是代碼,而是“這個數字究竟由哪次實驗得到”。本輪從注意力、檢索和訓練方法走到解釋性、校準與結果報告,最後需要留下能夠再次運行、檢查和質疑的研究資產。本文的目標很具體:把一份已有實驗整理成自包含的小包,在兩個空工作目錄中重算報告,並主動修改代碼、輸入和環境記錄,檢查流程能否發現變化。成功標準是證據鏈清楚,而不是文件夾整齊。
目錄
- 復現價值與本輪收穫
- 核心思想與校驗公式
- 官方代碼閱讀路線
- 最小實驗與代碼庫結構
- 評測協議與實際結果
- 失敗排查與證據邊界
- 後續科研問題
- 總結與參考資料
一、復現價值與本輪收穫
論文報告。 Pineau 等人在 JMLR 2021 總結了 NeurIPS 2019 的可復現性計劃,包括代碼提交、社區復現挑戰和論文檢查表。論文討論的障礙不僅是代碼缺失,還包括數據差異、訓練說明不足、指標不明確、選擇性報告和結論超出證據。[1] 因此,“倉庫能啟動”只是研究可檢查性的一個條件。
本次實際驗證。 掃描目錄中的三位編號,052–080 共二十九篇,均保留通過記錄。本次重新檢查其元數據、中文字數、本地鏈接、圖片文件與四十七個 Python 源文件的語法;歷史運行和視覺驗收記錄予以保留,沒有把全部模型重新跑一遍。完整導航見 研究代碼庫索引。
從這些文章可以提煉三類可複用資產。第一類是概念到實現的對應關係,例如注意力公式對應哪些張量變換;第二類是實驗協議,例如檢索候選、數據劃分與拒答閾值如何確定;第三類是反證工具,例如消融、輸入擾動和獨立計數審計。代碼庫應保存三者之間的關係,而不只是收集訓練腳本。
本輪的教學實驗也有共同邊界:小規模合成數據能幫助暴露接口和指標錯誤,卻不能替代真實數據、官方模型及原論文預算下的復現。月度整理時,應優先把這些未驗證項變成下一輪實驗,而不是把文章狀態“通過”解釋成科學結論已經普遍成立。
二、核心思想與校驗公式
本文把“實驗包”定義為代碼、配置、輸入、環境記錄和預期輸出的集合。清單,即 manifest,是這些對象的目錄與內容指紋;SHA-256 是把文件字節映射成固定長度摘要的算法,用來發現內容是否變化。
這裡 (p_i) 是包內相對路徑,(h_i) 是保存的摘要,(K=5) 是本例載荷文件數。校驗既比較摘要,也比較文件集合,因而缺失和意外新增文件都會被發現。哈希只說明字節是否與基線一致,不能證明標籤正確,更不能證明作者誠實。
(C) 是報告代碼,(D) 是保存的實驗摘要,(\theta) 是統計協議,(E) 是運行環境,(s) 是隨機種子;(O_A,O_B) 是兩個工作目錄生成的結果。此處比較五個確定性輸出的字節摘要,同時要求它們匹配事先從 080 保存的基線,而不是隻檢查兩個新運行彼此相同。
輸入分數的邏輯形狀是 [3,5,4]:三個舊模型運行、五個擾動預算、四種攻擊。它不是新訓練的張量,也不是六十個獨立種子。兩個報告重放不增加模型實驗的樣本量,不能讓原有誤差線自動變窄。
三、官方代碼閱讀路線
先讀 PyTorch 的 Reproducibility 文檔:相同種子並不保證不同版本、平臺或 CPU/GPU 之間結果完全一致。[2] 閱讀時分別標記隨機數來源、算子確定性和運行環境,避免把所有變化都歸因於種子。
接著打開官方 torch/random.py。[3] 本次看到 manual_seed 委託給內部實現,後者為可用設備設置種子,並調用默認生成器;get_rng_state 返回的是 CPU 默認生成器狀態。由此可以提出代碼閱讀問題:斷點恢復保存了哪些生成器狀態,數據加載順序是否也恢復?記錄一個整數種子並不能自動回答這些問題。
最後讀 DVC 的階段和鎖文件說明。[4] cmd 描述執行命令,deps 描述輸入依賴,outs 描述輸出;dvc.lock 記錄階段狀態與內容摘要。把腳本讀取的外部文件漏在依賴列表之外,會讓“輸入沒有變化”的判斷失去依據。本文借用這種顯式依賴思路,使用標準庫實現一個更小的固定流程。
本次實際打開的是 PyTorch 文檔顯示的 2.14 頁面和檢索日 main 源碼,二者不應被假定為同一提交;源碼尚未固定 commit。DVC 也只進行了文檔閱讀。相關框架運行、版本兼容性與斷點恢復實驗均待人工核驗。
四、最小實驗與代碼庫結構
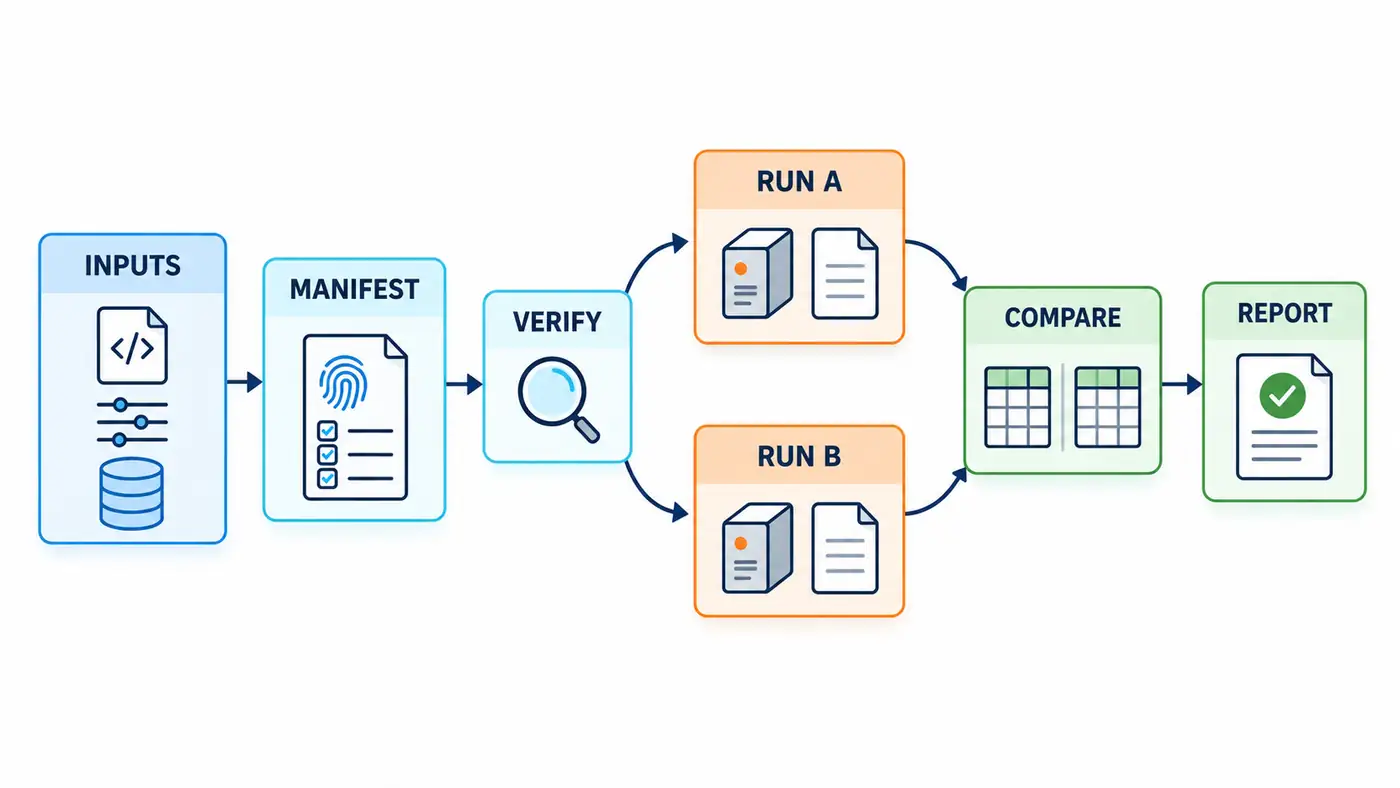
圖中先校驗輸入,再分到兩個工作目錄,最後比較結果;分叉表示兩份獨立目錄,代碼按順序執行。它不表示兩臺機器、容器隔離或並行加速。
從本篇目錄執行,輸出目錄應為尚不存在的新路徑:
python3 code/replay.py --out code/my_replay
PYTHONPYCACHEPREFIX=/tmp/081-pycache python3 -m py_compile code/replay.py code/capsule/report.py code/capsule/audit.py
僅需 Python 標準庫,實際基線為 CPython 3.9.6。入口會核對解釋器版本與實現;更換版本時應建立另一個經過審查的基線,而不是刪除檢查後仍聲稱相同環境。依賴和完整命令見 代碼說明。
capsule/ 原樣保存 080 的報告器、獨立審計器,以及三個輸入文件。capsule_manifest.json 保存這些文件的摘要、來源、隨機種子和預期輸出摘要。運行器使用當前解釋器創建子進程,保留每條命令的標準輸出、錯誤輸出和結果;舊輸出目錄已存在時拒絕覆蓋。
報告器內部的蒙特卡洛抽樣固定種子為 80,運行器另將 Python 哈希種子設為 81。這裡沒有新增訓練、數據抽樣或模型下載。獨立審計器不導入報告器函數,而是從整數失敗計數和分數運算重新核對統計結果;它可以發現部分實現錯誤,但仍共享同一批上游資料。
個人庫的公共層只負責運行身份、證據路徑和驗證結果,具體指標留在各實驗中。比如檢索召回率、拒答覆蓋率和攻擊成功率即使都是小數,也不能用一個含義模糊的 score 字段混合比較。附帶的 研究卡模板 要求寫清分母、方向、劃分和結論範圍。
五、評測協議與實際結果
本次檢驗的是保存摘要的可重放性。開始執行前,五個載荷摘要與五個確定性輸出摘要均取自已有 080 文件。每份工作目錄從載荷複製開始,沒有預放結果;隨後執行報告器和審計器,再與基線比較。
本次實際驗證。 兩個工作目錄均成功處理六十條條件日誌和二十個統計組;五個確定性輸出分別是報告 JSON、窮舉重採樣列表、CSV 表、Markdown 表與審計 JSON。它們在兩次重放之間、以及與 080 基線之間均字節一致。詳細記錄見 重放驗收日誌。
| 檢查對象 | 判定規則 | 實際結果 |
|---|---|---|
| 輸入與代碼 | 文件集合及摘要一致 | 五個載荷通過 |
| 報告重算 | 兩個新目錄分別匹配舊基線 | 每次五個輸出通過 |
| 計數與統計 | 獨立審計重新計算 | 兩次均通過 |
| 漂移樣例 | 明確拒絕變化 | 七類均被發現 |
七類樣例分別改變代碼、配置、數據、文件缺失、額外文件、解釋器版本記錄和輸出表。故障只注入臨時副本,不修改原始實驗。前三類通過追加字節模擬文件漂移,證明的是完整性檢查會生效,不是所有語義錯誤都會被檢測。
耗時日誌整份保留,但不要求字節一致,因為真實運行時間會變化;其記錄數、分數形狀與 Python 版本仍被檢查。這一排除規則在清單中事先寫明,不能在看到差異後任意刪除不喜歡的字段。
六、失敗排查與證據邊界
第一類失敗是輸入身份不明。文件名相同不代表內容相同,配置漏記默認值也會使兩個“同名實驗”實質不同。應先查載荷摘要和配置,再查結果,而不是直接調整容差讓比較通過。若清單與文件同時被修改,本例不會認證其真實性;正式歸檔需要獨立版本記錄。
第二類失敗是隱藏依賴。腳本從個人目錄讀取緩存、依賴當前工作路徑,或複用舊結果,都可能產生虛假的重放成功。本例使用相對包路徑並在新目錄執行,但沒有實施文件訪問追蹤或網絡沙箱,因此不能聲稱證明了所有外部依賴都不存在。
第三類失敗是同錯一致。兩次運行共享同一錯誤公式,仍會生成相同表格。因此需要原始計數、獨立實現和人工語義檢查。上游若存在標籤錯誤或測試汙染,本次摘要審計不能修復;它也沒有重新核驗逐樣本預測和模型權重。
第四類失敗是統計對象被替換。重放同一結果不是新的隨機重複;跨設備差異也不等於方法效果差異。當前結論嚴格限於這臺機器、這個解釋器和這份載荷。跨操作系統、依賴升級、真實 GPU 訓練、官方 benchmark 與區間覆蓋率均未運行,待人工核驗。
語法檢查和 CPU smoke test 已通過。現有結果目錄拒絕覆蓋,便於保留失敗證據;前置校驗失敗會直接打印錯誤,執行階段失敗則在新目錄寫入未完成狀態。不要把失敗記錄清空後只留下最終成功運行。
七、後續科研問題
作者推斷。 下一輪最有價值的問題,是這種記錄方式能否幫助第三方定位復現差異。可以固定數據和代碼,逐項改變解釋器、數值庫和硬件,預先定義預測誤差容差,再比較變化發生在哪個階段。當前的字節相等標準適合小型報告流程,不能未經論證就用於所有浮點訓練結果。
還可以研究最小證據保存量:只有彙總指標、保存逐樣本預測、再增加中間激活,分別能發現哪些故障?應先列出待檢測的錯誤,再比較存儲成本與檢出能力。保存更多文件本身不保證更可靠,關鍵是能否反駁具體的錯誤解釋。
對研究生而言,可以從索引中選一篇仍缺真實數據驗證的實驗,固定官方提交,補一組強基線與失敗分析,形成新的研究卡。對初學者,先嚐試改壞一個輸入再觀察錯誤信息,往往比同時安裝許多實驗管理工具更容易理解證據鏈。
八、總結
個人研究代碼庫應讓每條結論都能回到來源、協議、輸入和運行記錄。本次留下二十九篇既有實驗的導航,以及一個經過雙目錄重放和故障檢查的小包。它證明了有限範圍內的流程可檢查性;後續科研的任務,是繼續檢驗這些教學實驗尚未覆蓋的假設。
參考資料
檢索日期:2026-09-23。以下一手頁面與源碼均已實際打開。在線文檔與分支內容可能變化,未運行的版本兼容性待人工核驗。
- Joelle Pineau, Philippe Vincent-Lamarre, Koustuv Sinha, Vincent Lariviere, Alina Beygelzimer, Florence d'Alche-Buc, Emily Fox, Hugo Larochelle. Improving Reproducibility in Machine Learning Research (A Report from the NeurIPS 2019 Reproducibility Program). JMLR 22(164):1–20, 2021:論文頁面、正式 PDF。
- PyTorch Contributors. Reproducibility,頁面顯示 2.14;本次未安裝或執行該框架版本。
- PyTorch Contributors. 官方 torch/random.py,檢索日 main,未固定提交;用於閱讀種子和生成器狀態路徑。
- DVC Contributors. dvc.yaml Files:Stages 與 dvc.lock,在線文檔檢索日版本;本次未執行 DVC。