- 日期:2026-10-08
- 讀者:研究生、科研新人和工程型研究者
- 資料截止:2026-10-08;重點檢索近12個月,並保留爭議起點的2025年研究。本文為證據深讀,未運行模型訓練或復現實驗,不聲稱全面覆蓋。
摘要:答對更多,不只對應一種解釋
強化學習之後,一個模型第一次回答就能解出更多題,我們能否說它獲得了新推理能力?關鍵不在於承認或否認進步,而在於弄清楚進步發生在哪裡:原本偶爾答對的題變得穩定,原本未能解出的題開始可解,還是輸出格式更符合評分器?這些變化都有價值,卻需要不同證據。
本文對照四項研究。**目前較穩妥的判斷是:提高採樣效率與擴大有限預算內的可解題範圍都可能發生,效果取決於起點、任務和訓練方式;它們都不足以單獨證明某種內部推理機制從無到有。**這不是給正反觀點各留一半空間,而是把不同強度的結論放回各自能夠支持的實驗條件。Yue等、ProRL、MATH-Beyond和課程強化學習提供了四個不同切口。
先把“會做”拆成三個問題
可驗證獎勵強化學習,簡稱RLVR,是讓模型生成候選解,再根據答案核對或程序測試等反饋更新參數。獎勵告訴模型哪些輸出更值得保留,卻不一定提供完整解法。本文把接受這次強化學習之前的檢查點稱為“起點模型”;它可能已經經過指令微調或推理蒸餾,不能見到論文裡的base一詞就認定它是原始預訓練模型。
第一種“會做”是單次可靠性:隨機嘗試一次時多大概率正確。第二種是預算內可達性:允許嘗試多次,能否至少得到一個正確答案。第三種是可遷移的解題機制:面對新結構、被幹預的條件或更高難度,是否仍能運用某種方法。這三種說法逐漸增強,後一種不能由前一種自動推出。
常見的pass@k衡量前次採樣中至少一次成功的情況,再在題目上彙總。它與“從候選中實際選出正確答案”的能力不同:評測器知道哪些答案通過驗證,真實使用者未必知道。單題的一個直觀概率模型是:
這裡是固定題目,是固定模型、提示和解碼協議下的單次成功概率,是獨立同分布採樣次數。公式只是解釋指標,不是本次測量;有自適應搜索或相互依賴的候選時,不能直接套用。不同題目的也不同,不能先把準確率平均,再代入公式冒充整個數據集的pass@k。指標定義見Yue等§2.2。
由此出現一個容易忽略的事實:**即使只提高原本極小的成功概率,高採樣預算下的覆蓋率也可能上升。**反過來,連續失敗只能說明在當前協議下沒觀察到成功,不能把判成嚴格的零。本文所說“邊界擴大”,首先指可觀察的預算內邊界,而不是數學上證明原模型永遠不可能生成該答案。
論文的分歧,哪些來自設置不同?
起點較強時,獎勵可能主要讓答案更集中
Yue等在數學、代碼和視覺推理上比較訓練前後的pass@k。論文報告了小時RL模型較好、較大時起點模型追上甚至超過的現象。數學實驗以預訓練模型為起點,代碼與視覺部分則不全是這一設置。§4.1還按同一道題區分訓練前後是否解出,而非只比較平均分。原文§3–4.1
這支持“在所測配方中,強化學習常把已有成功變得容易採到”的解釋。**本篇的限定是:有限模型與有限預算的觀察,不能升級成所有強化學習算法的能力上限定理。**尤其不能把“訓練後可解題集合接近訓練前的子集”,改寫成每一條推理過程都已被逐條證明存在。
延長訓練後的收益,也並非處處一致
ProRL加入穩定訓練和維持探索的設計,包括約束策略分佈偏移的KL項、重置參考策略,以及多領域任務訓練。它從DeepSeek-R1-Distill-Qwen-1.5B起步,§4把結果分為覆蓋下降、較早平臺和持續增長三類,並在訓練未見的boxnet任務上報告改善。原文§2、§4.2–4.3
因此,不應斷言RL總是隻改善低預算表現,但也不能把改善全部歸因於訓練時長:任務混合、探索控制和起點都與前一項研究不同。已經蒸餾過的起點意味著,實驗回答的是“此檢查點還能通過RL進步多少”,不是“沒有先前推理監督也能從零學會多少”。跨任務遷移是有用證據,仍不是內部算法新生的直接觀察,也未排除極低概率解法被放大的可能。
要找邊界,題目本身也要留出空間
MATH-Beyond從數學題庫中篩出指定模型在1024次嘗試下仍未解出的題,並提供模型專屬子集、並集和交集。它把“新解出的題”與“原來能解、後來失去的題”分開定義;對部分RL模型的評估顯示擴展有限。原文§2–4;ICLR 2026正式版
它更適合診斷難例可達性,卻不是未經篩選的日常數學題分佈。某模型專屬集合上的擴展率,與另一模型另一集合上的擴展率,分母已經不同,不能直接排成能力榜。本篇還建議用新的採樣批次重測起點模型:篩選時零成功的題,複測時可能出現稀有成功;這會影響“新增”的歸屬,而不必意味著任何一方造假。
教師引導有效,不等於純獎勵獨自發現
2026年的課程強化學習預印本先探測當前可達邊界,再用少量教師推理軌跡做監督微調,最後通過RL鞏固。作者在數學評測上報告了pass@256改善。論文也指出:採用組內相對獎勵時,如果一組候選全部失敗,獎勵驅動的優勢項可能全部為零。原文§3–4
這給出了明確的學習信號問題,但改進來自包含教師信息的組合過程。若要回答“RL自身貢獻了什麼”,還需控制教師內容和預算,比較僅教師微調、僅RL以及組合訓練。全失敗組沒有該項信號,也不意味著整個模型絕不會進步:其他題目的參數更新、正則項及遷移仍可能改變它。
| 研究切口 | 關鍵條件 | 觀察或主張 | 不能據此證明 |
|---|---|---|---|
| Yue等 | 多種起點與現有RL配方 | 小預算改善可伴隨覆蓋收縮 | RL永遠無法擴展 |
| ProRL | 蒸餾起點、多任務、延長訓練 | 收縮、平臺和增長並存 | 時長是唯一原因 |
| MATH-Beyond | 按模型失敗篩出的難題 | 隔離預算內新增成功 | 普遍任務上的總體能力 |
| 課程RL | 教師微調與RL交替 | 組合流程擴大觀察覆蓋 | 無外部信息的新能力創造 |
表中各行對應上述原文,不能橫向比較提升幅度。前三項已有正式會議記錄;課程RL在本次核驗中只確認到arXiv預印本。
真正需要對齊的是一次完整測量
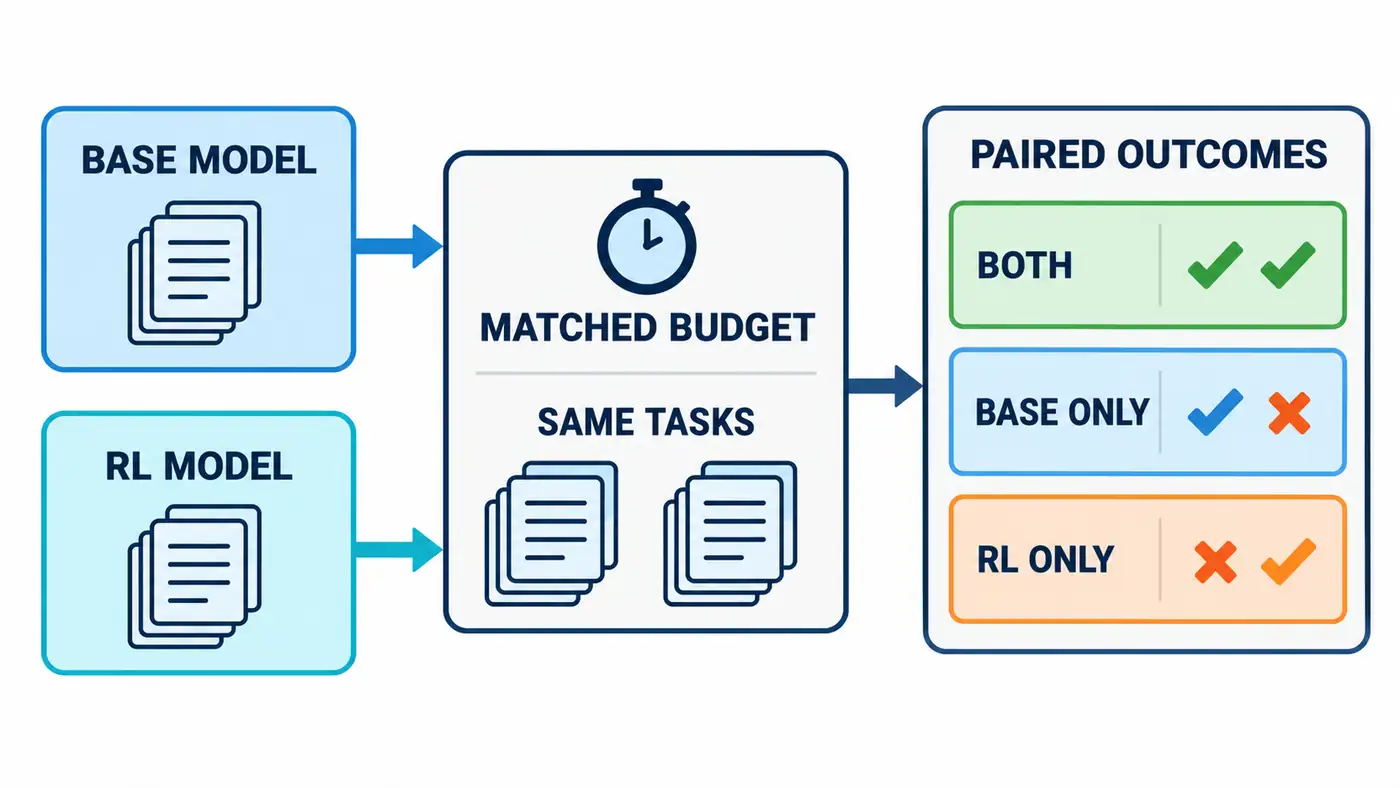
圖示為本文建議的評測流程,不是論文數據或已證實的因果機制。勾叉左側代表起點模型,右側代表RL模型;僅畫出至少一方成功的三類,雙方均失敗的第四類也必須記錄。RL ONLY表示當前預算內僅訓練後成功,不自動代表全新推理機制。
同樣的採樣次數不保證同樣的計算成本。Yue等的通用評測上限為16384個token,ProRL的評測設置為32k;兩者即使都畫pass@k,也不是跨論文的嚴格等預算對照。Yue等§3、ProRL§3.4。訓練數據、教師生成和試驗配方選擇消耗的預算,還應與測試時生成成本分開報告。
提示模板、溫度和答案提取器也應凍結。否則,某模型可能只是更熟悉輸出格式,或得到更適合自己的解碼參數。共同協議便於解釋因果,分別調優的協議便於比較各自最佳表現;兩種實驗都能做,但調優預算和目標必須寫清,不能把它們混成同一個結論。
可比性還包括數據身份。要區分訓練題、配方選擇用的驗證題和最終測試題,檢查題目及近重複解法是否交叉。ProRL說明曾用來自評測基準的混合驗證集監控訓練;本篇因此不把所有報告收益都稱為完全獨立的確認結果。原文§3.3。這是一項解釋限制,不等於已經證明數據洩漏。
最後,答案正確與推理正確仍有距離。數學題可能猜中末尾數字,程序也可能只通過不充分的測試。MATH-Beyond還展示了答案解析規則造成的誤判。原文§3.1。若主張新增解題方法,就需要檢查關鍵步驟、補充測試或受控變式;僅憑流暢的文字解釋不足以完成這一步。
下一項實驗,怎樣讓兩種解釋給出不同預測?
下面是後續研究設計,尚未執行。先固定一個起點檢查點和一組獨立題目,保存完整候選、判分記錄及生成成本。對訓練前後模型使用共同的採樣預算網格,並另做相同總生成token預算的比較,分別報告可靠性、新增覆蓋和失去覆蓋,避免只挑一個對自己有利的。
**檢驗一:收益是否主要來自重新分配概率?**如果低預算差距明顯,高預算差距逐漸消失,而且新增題在獨立重採樣後也被起點模型解出,就更支持這種解釋。若高預算差距持續存在,證據更支持實用可達範圍擴大;但仍不能僅憑有限失敗斷言原概率為零。
**檢驗二:擴展依賴什麼訓練信息?**設置只做RL、只用教師軌跡微調、兩者組合的條件。保持教師題目與軌跡一致,記錄教師調用、訓練token和更新次數。若組合優於僅教師條件,才更能支持RL對鞏固或遷移有額外作用;若只在教師覆蓋過的模板上提升,結論就應收窄。
**檢驗三:新增成功是否能遷移到解法結構?**從新解出的題型製作預先確定的變式,改變表面措辭、無關線索及組合結構,並用獨立驗證方式判分。若提升跨變式保持,且關鍵步驟有效,才更接近“學到可複用方法”的主張。解釋文本不同本身不是機制證據,也不應由生成文章的助手冒充人工語義金標。
實驗前還應約定預算上限和停止規則,完整保留正負結果。如果預算用完仍無法區分兩種解釋,結論就是當前測量分辨率不足;不追加採樣直到出現期待的答案,也不把仍然開放的問題寫成算法已經無效。
總結:把“新能力”寫成可檢驗的主張
對讀者最有用的立場是分層報告:單次正確率提高,說明更可靠;同題同預算下新增成功增多,說明觀察到的可達範圍變化;控制訓練信息後仍有跨結構遷移,才進一步支持可複用方法的學習。每前進一步,都需要新的證據。
因此,讀到“RL創造能力”或“RL只會採樣”時,先補上四個限定:相對於哪個起點、在哪類任務、用了多少預算、用什麼驗證。爭議的價值不在於選一句口號,而在於把下一次實驗設計得足夠具體,讓競爭解釋有機會被區分。
參考資料
- Yang Yue、Zhiqi Chen、Rui Lu、Andrew Zhao、Zhaokai Wang、Yang Yue、Shiji Song、Gao Huang. Does Reinforcement Learning Really Incentivize Reasoning Capacity in LLMs Beyond the Base Model? 2025,NeurIPS 2025。正式論文;本文主要定位版本:arXiv v5。兩位Yang Yue為不同作者。
- Mingjie Liu、Shizhe Diao、Ximing Lu、Jian Hu、Xin Dong、Yejin Choi、Jan Kautz、Yi Dong. ProRL: Prolonged Reinforcement Learning Expands Reasoning Boundaries in Large Language Models. 2025,NeurIPS 2025。會議頁;正式論文;arXiv v1。本文討論初代ProRL,不混用後續版本數字。
- Prasanna Mayilvahanan、Ricardo Dominguez-Olmedo、Thaddäus Wiedemer、Wieland Brendel. MATH-Beyond: A Benchmark for RL to Expand Beyond the Base Model. 2025預印本,ICLR 2026。會議頁;正式論文;arXiv v1。
- Pengxiang Cai、Tianchen Fang、Xiaohan Li、Qingyuan Zeng、Guocong Li、Jintai Chen. Curriculum Reinforcement Learning Can Incentivize Reasoning Capacity in LLMs Beyond the Base Model. 2026,arXiv預印本v1,首次提交2026-06-21。原文;版本記錄。截至檢索日未核實到正式會議錄用信息。