- 日期:2026-10-23
- 读者:研究生、科研新人和工程型研究者
- 范围:四条已观察开发查询,五十个冻结候选,四种输入条件;八项文本变换已于2026年10月24日完成语义与标签保持检查。
摘要:先问什么结果会让自己改变解释
“把证据放到前面,重排就会更好”,是一个很容易接受的直觉。上一篇却发现,十八条退步查询中,十七条的已召回相关文档没有截断。现在需要的不是再找几个符合故事的例子,而是安排让这个解释可能失败的对照。
本次实际完成八百次真实模型计分:长文本和短文本各两条,分别比较原文、原样重建、证据前移、证据后移。两个组都出现前移后排名下降,未出现排名指标提升。完整句子都还在,不等于重排后的语义一定不变;八项变换随后通过语义与标签保持检查,原相关性标签得以沿用。这项检查解除标签保持的待审项,不消除小样本和多变量共同变化的限制。
复现价值:区分性来自预测,而不来自实验规模
所谓区分性实验,是让不同解释对同一观察给出不同预期。若退步主要因为相关证据未进入模型,那么恢复证据可见性应当带来选择性改善;若文本完整时顺序变化仍能改变分数,就需要考虑位置、篇章组织与模型打分偏好。两种现象也可能同时存在,不必强行选出唯一原因。
SciFact 论文报告的任务包含科学主张的支持或反驳,以及证据句定位;本文沿用其公开标注,只评测文档相关性。[1] 支持和反驳主张的文档都可能是相关文档。检索分数因此不能解释成科学判断正确率,更不能把一个重排分数称为模型对主张的置信概率。
本篇延续同一检索研究项目,相比上一篇新增的受控变量是相关文档内的句子位置。模型、查询、标题和候选列表全部冻结。四个探针来自此前已经观察过的一百条开发查询,既不是随机代表样本,也不是新的确认集。三百条确认查询继续保留,融合方案仍留到后续单独比较。
核心思想与公式:同时观察有截断和无截断
令 为文档 的原标注证据句索引并集, 为其余句子。前移输入按照“证据块、其余块”拼接,后移输入反过来;每个块内部保留原顺序,所有句子都保留一次。并集用于操作定位,不意味着多个理由集合必须联合出现才足以支持判断。
交叉编码器联合读取查询与文档,输出标量分数:
其中 是查询, 是输入条件, 是句序变换, 是冻结权重;分词器把一对输入共同限制到五百一十二个 token。token 是模型读取的子词单位,联合上限还包括查询和特殊符号,不能把它误写成摘要可用五百一十二个词。
主指标 nDCG@10 衡量前十位相关文档的排序质量,越靠前折损越小,并以理想排序归一化。本次每条查询只有一篇标注相关文档;它位于第 名时,前十内指标为 ,超过前十则为零。预先登记的配对量为:
表示该查询的 nDCG,两个横线各是两条查询的均值。 只是描述性组差:两组主题与文档难度未随机匹配,不能把它当作截断的独立因果效应,更不能用四条样本做总体显著性宣称。
官方代码阅读路线:标签、文本与截断逐层对齐
先读 SciFact 的数据格式说明,区分文档编号、证据集合和从零开始的句号索引。[2] 本次使用原始训练标注与分句语料,把证据定位到实际句子;不让语言模型重新生成“看起来合理”的证据。原始摘要逐句去除首尾空白后,拼接结果必须与 BEIR 文本一致。
再读 BEIR 的 Rerank.rerank,确认标题、空格、摘要的拼法,以及候选分数如何对应文档编号。[3] 最后读 Sentence Transformers 的联合分词和 predict:本次执行官方模型路径,只在外部替换相关文档的文本视图,不修改网络。[4] 字符偏移审计记录证据句末端是否落在保留输入内,完整句可见和仅部分出现分开记录。
模型固定为 cross-encoder/ms-marco-MiniLM-L6-v2,模型与分词器修订均为 233902d25c440f23af6f7d6e94d2946bac0bee0a。模型卡说明其面向段落重排;这不是领域能力保证。[5] 官方源码的提交、行号、许可证及实际字节核对记录见源码地图。
最小实验:先选材料,后看模型分数
选择规则在本篇推理前冻结。先要求查询恰有一篇标注相关文档,且在五十候选中;变换前后原始 token 数相同。长文本要求前移后证据全部可见、后移后至少一句不完整;短文本要求所有条件均不超过长度上限且证据全部可见。每组按固定前缀加查询编号的哈希排序取前两条,不按模型输赢选择。
合格池有十条长文本和三十七条短文本,最终选出长组 454、30,短组 280、155。目标文档联合原始长度分别是 608、728、376、226。只修改每条查询的标注相关文档,其余四十九个候选完整保留;因此这是借助标签的诊断探针,不能作为无需标签的真实检索改进。
四种条件各自重新计分全部候选。原样重建是实现负对照,用于抓住拼接和映射错误;短文本是无证据截断的对照,用来观察顺序本身的敏感性。长文本的证据可见性检查是操作正控,只检验变换是否做到预定事情,不预设模型分数必须提高。
运行固定 CPU 单精度、四线程、批量十六、随机种子一百零七,不训练。先用同样四条查询的前两候选加相关文档去重试跑,本次每条实际仍为两个候选,共三十二次计分;估计正式推理约十六点七秒,低于一千二百秒预算。正式运行八百对,推理二十点八六秒,总耗时二十四点六零秒,峰值进程内存 786579456 字节,约零点七三 GiB。
实际验证:证据完整出现,并未保证名次改善
下表沿用经检查保持的原始相关性标签,数值与审核前保存的计算一致。身份对照与原文完全一致,故不重复列出。
| 查询与组别 | 原文相关文档名次 | 前移名次 | 后移名次 | 前移减后移 nDCG |
|---|---|---|---|---|
| 454,长文本 | 1 | 1 | 1 | 0.000000 |
| 30,长文本 | 1 | 2 | 1 | −0.369070 |
| 280,短文本 | 1 | 1 | 1 | 0.000000 |
| 155,短文本 | 2 | 4 | 2 | −0.200253 |
长组均值为 −0.184535,短组为 −0.100127,组差为 −0.084409。查询 30 的四个证据句从仅一句完整可见变为全部可见,目标分数却从后移的 4.870255 降到前移的 3.922231。查询 155 没有证据截断,前移同样使排序下降。它们构成已通过语义检查的局部反例,仍不是隔离截断作用的因果证据。
也不能只盯名次。查询 280 前移后的分数从 5.811522 升至 7.137649,仍排第一,因此 nDCG 不变;查询 454 分数下降也未掉出第一。名次具有离散性和天花板,零指标变化不等于模型没有响应。四条原文中三条已经第一,还进一步限制了可以观察到的改善空间。
每个条件实际有效输入总量都是 75683 token,候选召回率均为一。形状检查为输入 、末层表示 、分数 ,分别表示批量、联合长度、隐藏维度和单分数输出。二百个原文分数与上一篇保存记录完全相同,身份对照误差也为零。
评测协议:哪些解释仍然混在一起
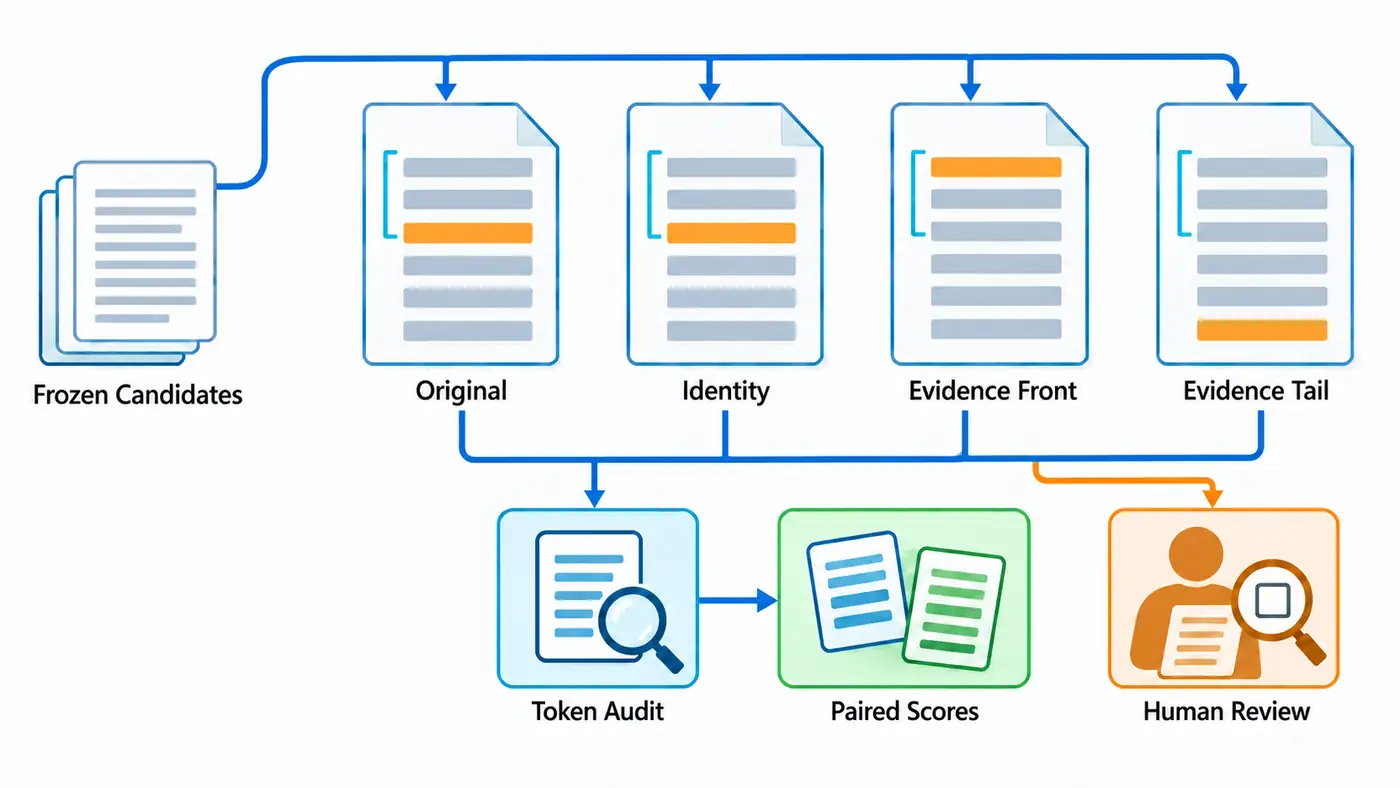
图中前缀窗口示意长文本;短文本的全部内容都在窗口内。四条件共享材料审计,语义检查与分数计算分开,审核包不展示模型结果。不过正文与聊天已经披露结果,因此不能据此宣称本次是独立盲审。
前移同时改变证据位置、前后文连接,以及截断后剩下哪些非证据句。即使 token 总量相同,模型看到的语境也并不等价。因此目前的作者推断只能是:证据完整可见不是排序改善的充分条件,篇章或顺序效应值得继续区分。它不证明截断永远无关,也没有证明另一种“覆盖有用排名”解释已经获胜。
该实验没有专门只抽取上一篇的十八条退步样本,检验的是更强、更一般的恢复直觉;它不能估算那些退步中有多少由截断造成。后续应继续遵守已登记的固定排名融合对照,不能看到前移不佳就临时换模型、挑新样本,或提前试用确认集寻找好结果。
失败排查与语义检查边界
第一次材料构建因文本一致性断言失败而停止:原始分句带有末尾空白,直接用空格连接与 BEIR 导出不一致。修复为逐句去除首尾空白后,全语料五千一百八十三篇均能重建;此修复发生在选样冻结和任何本篇模型前向之前。网络限制导致的源码读取失败也保留了日志,后续匿名重试核验通过。
独立脚本没有调用主运行脚本的指标函数,而是从保存分数重新排序、计算折损和配对差,检查全部八百对、候选集合、句子排列与输入身份。七类损坏测试均被拒绝,包括改分数、漏候选、改 token 数和伪造审核通过。它证明确定性账本一致,不证明文本语义合法。
语义检查覆盖四查询的前移、后移共八个变换:指代是否仍明确,否定和时间关系是否改变,对照组描述是否被拆散,完整文档是否仍保持原相关性。八项检查已于2026年10月24日通过,相关记录与材料哈希单独归档。原始空白回复表和运行时待审日志作为历史证据保留,以带日期的后续记录反映当前状态。检查没有提供逐项理由,因而不能据此声称获得了细粒度错误解释。原数据集证据标注、脚本复算与语义判断分别回答不同问题,不能互相替代。
源码与复现入口
本篇技术配套包已公开并核验:源码目录、README 运行说明、SOURCE_MAP 源码地图。公开版本的五十六个文件与本地及 ZIP 逐一匹配,运行入口与前版一致,沿用前版公开副本的真实试跑记录。包内含配置、材料、依赖锁、逐对分数、审计器与无分数审核页;大资源按固定版本和哈希获取。新增语义检查记录与更新后的说明文档已随固定版本公开;实验代码、输入和数值保持原样。
按 README 安装依赖并执行数据准备后,最小真实命令为:
HF_HUB_OFFLINE=1 TOKENIZERS_PARALLELISM=false python run.py --cache ./cache --out replay-smoke --smoke
预期产生三十二对分数、输入哈希、阶段日志、形状和按原标签计算的指标;删除试跑参数并指定新目录可复跑八百对。再运行 python audit.py --out replay-smoke 独立复算。原始结果、失败和空白审核表同时保留。重跑程序仍输出冻结时的待审状态;解释本次已确认材料时,需联合读取带哈希的后续检查记录,不能把程序输出当作新审核。
总结
一个有用的最小实验不必让新方法胜出,但必须让自己的解释面临输掉的可能。本篇把证据可见性、顺序变化和实现错误分别放进对照,也暴露了小样本天花板与语义合法性限制。语义与标签保持检查已经完成,下一步将带着这些边界进入强基线比较,不因反例成立就提前承诺新方法会赢。
参考资料
检索与固定源码核验日期:2026-10-23。论文支撑任务背景,本文数值来自实际保存日志;语义与标签保持检查于2026年10月24日通过。
- David Wadden、Shanchuan Lin、Kyle Lo、Lucy Lu Wang、Madeleine van Zuylen、Arman Cohan、Hannaneh Hajishirzi,2020,Fact or Fiction: Verifying Scientific Claims,EMNLP,会议页面。
- SciFact 作者,固定版本的数据格式说明。
- BEIR 作者,固定版本 Rerank 实现。
- Sentence Transformers 维护者,固定版本 CrossEncoder。
- Sentence Transformers,本次权重版本的模型卡。
作者作品推广
以下是作者自有产品推广。除了写技术博客,我也在做一些让日常更有条理的小工具,欢迎了解我独立开发的两款 App:
- 日常收支小记:记下收支,也给每一笔钱安排好去处。记录日常账目,安排预算与储蓄目标。在 App Store 了解。
- 一事微光:从一件小事开始,让今天多一点微光。按当下的时间和精力选择行动,记录完成后的感受与发现。在 App Store 了解。
更多技术文章和个人作品,欢迎来我的网站:zffjzz.top。也欢迎把使用感受告诉我,让这些小工具慢慢变得更好。