摘要
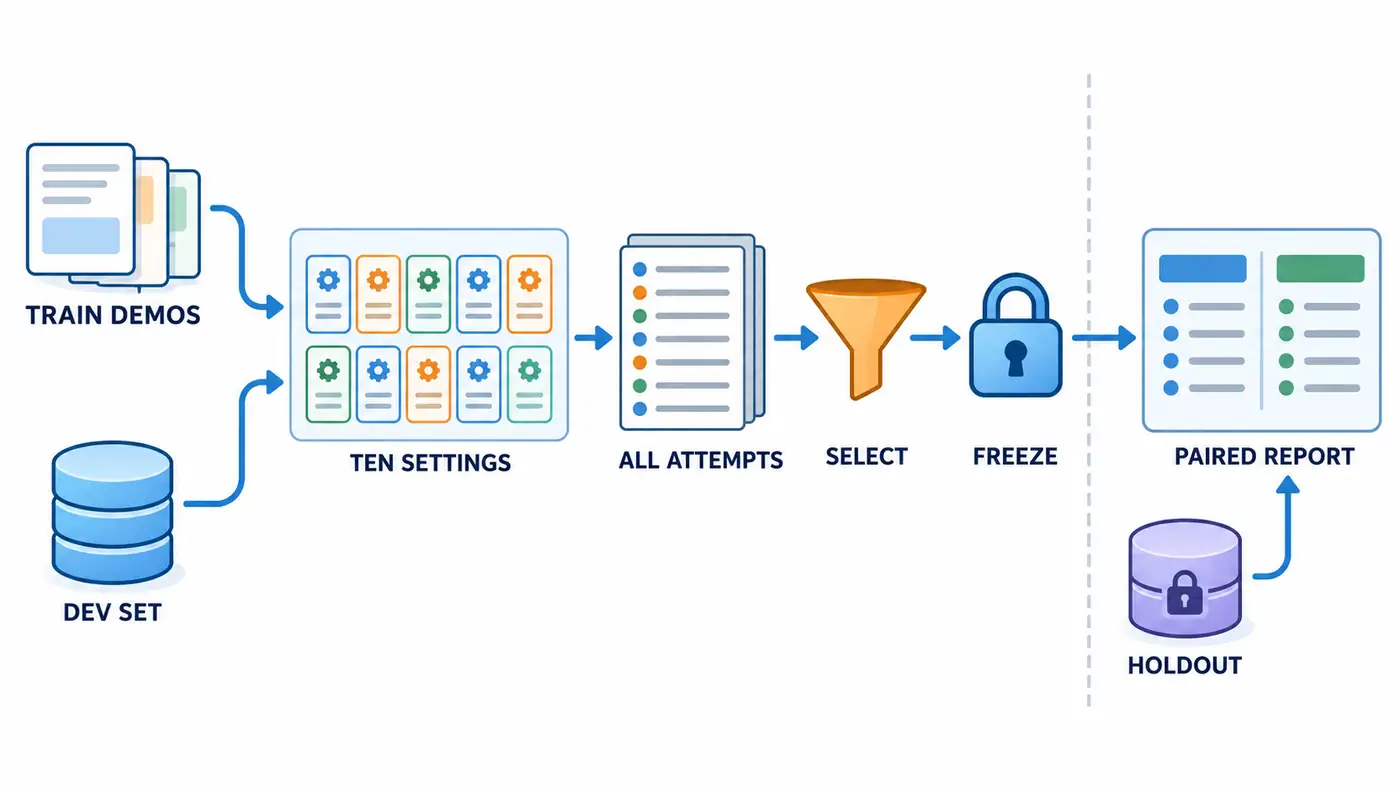
上一实验给两个固定检查点计算了配对区间,却没有回答一个更早的问题:为什么偏偏比较这两个?如果研究者换过提示词、示例顺序和答案表示,再挑最高分写进摘要,区间即使算对,也可能没有覆盖选择过程带来的乐观。本篇把十种协议的全部开发结果放在一起,选定一个方案后,才打开此前保留的128条确认样本。目标是复现一次可审计的“搜索—冻结—确认”,不是证明做过搜索的提升一定消失。
复现价值:把挑选过程也视为实验
选择偏差指评估对象经过数据驱动的筛选后,筛选时的成绩不再像事先指定对象的成绩那样容易解释。它不要求训练模型,也不要求故意隐瞒:多改几次提示词、只记住最顺眼的一行,已经在做选择。
论文报告:Cawley与Talbot在2010年的研究指出,有限样本上的模型选择准则也会被过拟合,选择步骤必须纳入性能评估设计。[1] 本篇借用这个问题框架,没有复现其核方法实验,更没有把论文中的偏差规模套到语言模型上。
本次实际验证:复用真实SmolLM2-135M-Instruct及公开SST-2数据,十种设置只接触64条开发题;选择之后仅评估胜者与固定零样本基线。与前篇相比,改变的是评测协议的选择过程,冻结的是原始模型、数据划分和语义准确率定义。新增产物是包含全部尝试、选择时间和源码哈希的冻结文件。
核心思想与公式:最高分不是免费得到的
设第种设置在开发集上的准确率为,选择规则是
这里表示一整套提示与答案计分协议,是被选择的协议编号;同分按预先列出的顺序选第一个。即使各设置的估计没有系统偏移,取最大值也倾向于保留有利波动。一个基本关系是
期望是对重复抽样而言,不是对这十个数字简单求均值;设置之间可以相关,这个不等式仍成立。但它没有告诉我们本次乐观了多少,更不意味着所有设置真实能力相同。把十次试验当作十枚独立硬币,通常不符合共用模型、题目和模板的事实。
模型如何给出答案也要固定。对上下文和候选答案,采用
是冻结权重,是第个候选token,是其长度;只求候选部分的对数概率和,不把题目token算进去。两候选取较大者,再映射回原始负面或正面标签。字母A/B只是显示位置,换序时标签映射随之改变。
官方代码阅读路线:先追数据,再追分数
从固定版本的SST-2任务配置读起:它声明公开GLUE数据、原始问题模板、两个文本候选和准确率。[4] 接着看_encode_pair怎样处理上下文与续写边界,再看_loglikelihood_tokens取哪些位置的概率,最后进入process_results核对argmax和标签。
本篇直接调用官方HFLM.loglikelihood与ConfigurableTask.process_results,没有把整个simple_evaluate运行器都称为已复现。独立路径另外做一次真实Transformer前向计算,检查候选token、因果位移和得分。源码地图给出已实际下载核对的永久文件行号;七个官方文件与安装版本逐字节一致。统计部分再读SciPy的bootstrap:配对开关决定两个方案是否使用同一批重采样题号。[5]
最小实验:十种设置究竟是什么
模型与tokenizer固定在12fd25f…,GLUE固定在bcdcba79…;完整revision和12个资源文件哈希见资源锁。仍按最初的题号哈希顺序取64条开发样本、后128条确认样本,二者没有交集。数据来自公开验证划分,不能称官方测试榜单。[6][7]
九种历史协议来自前面的示例顺序和选项实验,重复的原始零样本协议只算一次。新增第十种只写Review: {sentence},下一行写Sentiment:,候选仍为negative与positive。全部设置在本次新推理前写入配置,没有看确认成绩后补候选。两组四示例只取训练集,沿用已经固定的题号和顺序。
| 开发设置 | 正确数/64 |
|---|---|
| 原始零样本 | 32 |
| 四示例A:正序/逆序 | 31/37 |
| 四示例B:正序/逆序 | 33/44 |
| 列出选项、答文本:正序/逆序 | 31/32 |
| 列出选项、答字母:正序/逆序 | 32/33 |
| 简短提示词 | 52 |
这张表保留了全部十项,包括低于基线的结果。简短提示词以52/64胜出。历史九项成绩此前已经看过,因此这不是事前注册的全新十臂研究;准确说,它是对回顾性候选集合做一次前瞻确认。旧模型微调结果没有混入本表,人工评分器也没有参与挑选。
评测协议与真实结果
运行顺序是开发集两题乘十条件试跑、开发集全量评测、写入选择文件,最后才做确认。冻结记录时间为2026年10月14日09:16:38,记录胜者、基线、全部得分、待确认题号及执行源码哈希。确认入口拒绝试跑模式,也拒绝源码身份变化;保留的新闻64题没有使用。
本次实际验证:确认集上,简短提示词89/128,原基线65/128;胜者新增正确28题、退步4题、其余96题结果相同。配对提升为18.75个百分点,95%百分位区间为[10.9375,26.5625]个百分点。确认集正负各64题,恒选正面只能得到64/128,这个简单诊断也一并报告。
开发集提升是31.25个百分点,确认后的提升缩小但仍为正。因此不能写成“选择偏差让优势完全消失”,也不能把开发集81.25%的绝对准确率沿用到确认结论;确认准确率实际为69.53125%。作者推断:这支持当前冻结模型和当前任务下,简短提示相对原模板更合适;它不识别提升究竟来自措辞、长度还是模型预训练习惯。
一个容易遗漏的边界是“未使用”的含义:确认样本早已下载,前篇还用其文本进行不依赖标签的精确重叠排除;它此前没有参与模型成绩选择,也没有推理记录。这是本地研究流程中的留出,并非第三方保管的秘密盲测。如今它已被消费,后续不能一边查看错题一边继续宣称它未见。
前向计算使用CPU、float32、eager注意力、四线程和batch size 1;不套聊天模板,不加BOS/EOS,不生成回答,也不训练。最大输入512,超过就停止而非静默截断。十条件开发正式运行包含640次题目协议评测、1280个候选;确认只比较两个冻结方案,共256次评测、512个候选。独立与官方得分最大差为零。
资源也属于证据。开发阶段导入后131.505秒、峰值RSS约1.91GB;确认阶段32.995秒、约1.38GB。首题logits形状分别为[1,36,49152]和[1,23,49152],依次是批量、输入长度与词表大小。耗时随负载变化,不能当吞吐基准。原始零样本、四示例和简短提示的开发候选输入token总量分别为4506、26522、3588;独立复算又计算了一遍,这些数字不是整个进程的总运算量。预算不同,因此本篇比较的是可选协议,不是等计算量下的示例因果效应。
区间回答什么,不回答什么
对第条确认题,令为胜者是否正确减去基线是否正确,则
,正一是胜者新增正确,负一是退步,零是两者同对或同错。以题目为单位同时重采样两列正确性,固定随机种子9900,计算两万次差值的百分位区间。全部重采样结果与直接共享索引实现一致;独立标准库脚本还用离散分布卷积复算经验区间。[2][5]
这个区间描述已经选定的固定协议在当前按行抽样假设下的差异,没有重演每次搜索,所以不覆盖整个研究策略的不确定性。接口没有电影或来源分组标识,按行独立只是条件假设;预训练是否见过这些评论也无法排除。即使确认优势保留,也不能据此声称中文情感、其他模型或其他任务都提高。
开发到确认的变化混合了抽样难度、类别组成与筛选效应,不能把两次提升相减就命名为“选择偏差的精确估计”。若想估计搜索策略,应在新的外层划分中重新完成内层挑选,而非只给当前赢家多画一条误差线。反复看确认分数再改提示,会把确认集重新变成开发集;可重复使用留出数据需要额外方法与假设,本篇没有实现那类机制。[3]
失败排查:先排身份错,再解释模型
本次首先遇到临时环境文件被清理,随后新解析到的PyArrow版本与固定NumPy不兼容。错误发生在模型运行之前;恢复兼容版本后,试跑与正式运行才继续。测试驱动还曾把本地选择脚本误识别为同名标准库,已只修复加载方式,冻结实验源码未改。失败命令与退出码都保留。
复跑若不一致,按资源哈希、题号集合、示例ID、上下文哈希、候选token和语义映射逐层排查。不能为了对齐结果而直接修改期望哈希。八个破坏测试检查错分、重复题、缺题、错误标签及确认题泄漏,能证明确定性检查会拒绝坏记录,却不能替代对自然语言语义的真人判断。
可检验的后续问题
简短提示胜出至少有两个解释:它更符合模型熟悉的补全文体,或者较少的上下文减少了无关竞争。本次同时改变表述和长度,无法区分。后续可在新保留数据上预先安排同长度改写与同措辞长度对照,再报告全量条件;已经消费的128题不能重新包装成未见确认集。
另一个问题是赢家是否稳定。重排开发集或改变随机划分后,胜者可能不同。可以先在现有开发数据上做探索性稳定性分析,但它不能挽回已经看过的确认集。若资源只允许一次确认,就承认只有一个独立确认结果,保留失败边界,比事后追加条件直到显著更有研究价值。
源码与复现入口
完整公开源码已固定到提交4d027f931e0f:本篇目录、README与完整运行步骤、SOURCE_MAP官方实现映射。51个公开文件已匿名下载并与本地源码及归档逐项核对,公开副本的审计和真实模型试跑均通过。
最小离线命令为python audit.py,输出候选求和、标签映射、选择结果和确认差值的独立审计。真实模型入口为python run.py --cache ./cache --phase development --smoke --out smoke-new,先按README安装锁定依赖并运行prepare.py。预期保存逐题记录、阶段状态、环境与身份文件。配套包包含完整自写模块、下载器、配置、许可证及源码地图;不分发模型权重、原始评论或隐含本机路径。
总结
搜索本身不是错误,省略搜索过程才会让证据难以判断。本篇把十种尝试、一个冻结胜者和一次留出比较分开记录。可检验的结论来自确认数据及其限制;开发集上的最高分负责提出候选,不应独自承担最后的证明。
参考资料
检索与实际访问日期:2026-10-14。
- Gavin C. Cawley、Nicola L. C. Talbot,2010:On Over-fitting in Model Selection and Subsequent Selection Bias in Performance Evaluation,JMLR 11,2079–2107;全文。
- Rotem Dror、Gili Baumer、Segev Shlomov、Roi Reichart,2018:The Hitchhiker’s Guide to Testing Statistical Significance in Natural Language Processing,ACL。
- Cynthia Dwork等,2015:Generalization in Adaptive Data Analysis and Holdout Reuse。本篇仅引用问题背景,未运行其算法。
- EleutherAI:固定提交SST-2任务配置。
- SciPy:1.13.1版bootstrap文档。
- HuggingFaceTB:固定版本SmolLM2-135M-Instruct模型卡。
- NYU/GLUE:固定版本数据卡;Richard Socher等,2013:Recursive Deep Models for Semantic Compositionality Over a Sentiment Treebank,EMNLP。