- 日期:2026-10-13
- 读者:研究生、科研新人和工程型研究者
- 范围:同一小模型的两个训练检查点、64条既有开发样本;探索性分析,不是完整基准排名。
摘要:领先一题,究竟说明什么
两份结果分别是58题正确和57题正确。排行榜会把前者放在上面,却不会告诉我们:它们是各有所长,还是只在同一题上分歧?这两种情况可以有相同的平均分差,支持的研究判断却很不同。
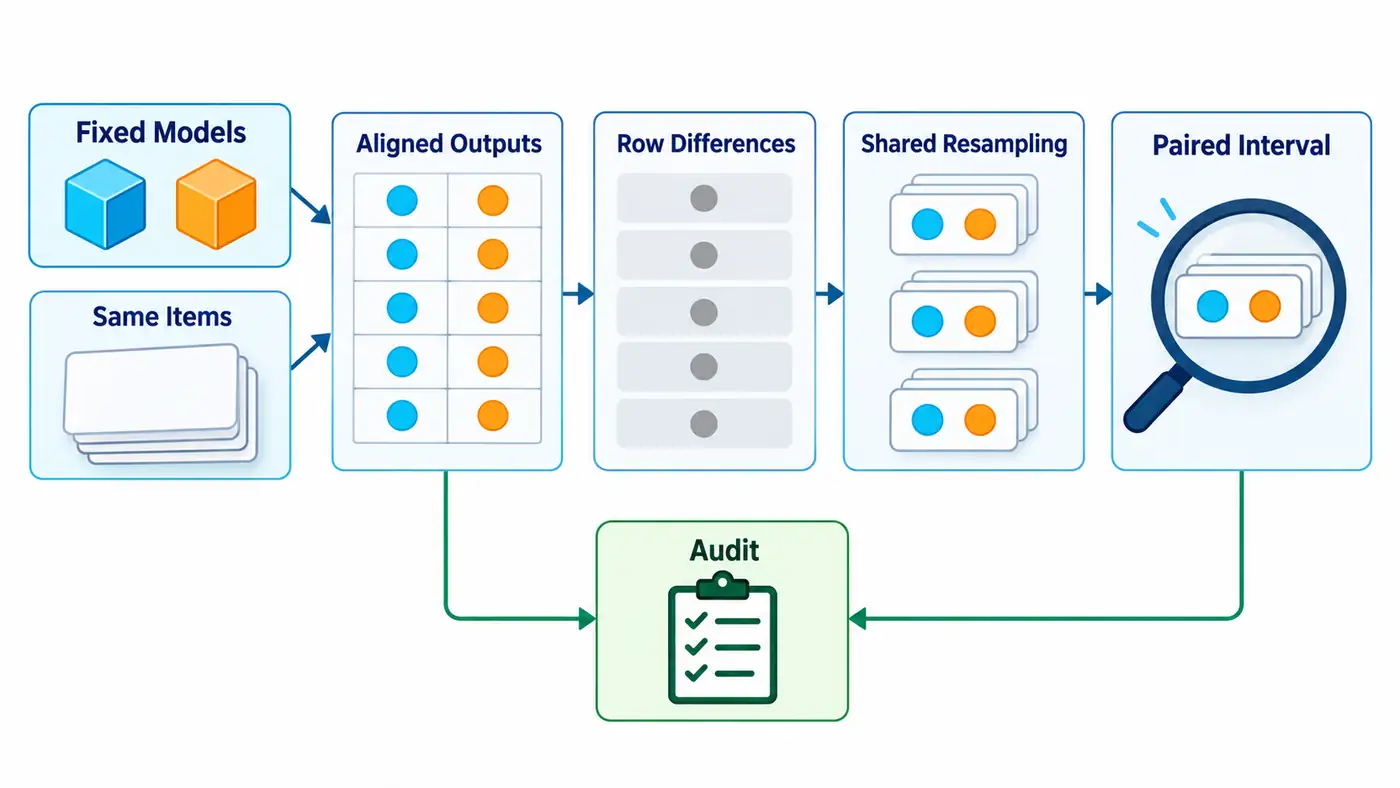
本篇复用此前训练得到的两个真实检查点,重新生成同一批SST-2情感分类样本的回答,再用配对区间检查这一个差距。实际结果是:后者0胜、1负、63平,差值为负1.5625个百分点。配对百分位区间为负4.6875到0个百分点;打散对应关系的错误对照则得到负12.5到正9.375个百分点。区间变窄说明保留对应关系很重要,但只有一条分歧,不能据此宣布稳定胜出或两个模型等效。
复现价值:承接评分审计,再问不确定性
前一篇检查答案抽取规则与人工审核的边界;已有总体审核确认,但没有提供逐题标签,所以人工误判率仍然未知。本篇不把那个确认当作可计算的人工金标,也不重新挑评分器。我们返回已有训练项目,冻结严格JSON格式且标签正确的联合指标:只有输出是指定JSON对象、唯一情感标签符合数据标签,才计为正确。
新增问题只有一个:当两模型做的是同一组题,应如何描述平均差值的不确定性? 改变的是统计重采样方式,冻结的是检查点、数据、提示、解码与评分。配对指每题同时保留两个模型的结果;自助重采样又称bootstrap,指从已观测单位中有放回抽样,用这些重复样本观察统计量的变化。
这里的两个模型是同一基础模型经过不同训练顺序得到的检查点,不是两个架构或两个厂商系统。此前结果已经公开,我们按种子编号取前两个重排检查点,没有资格把选择称为事前盲选。这份区间用于理解现有开发结果,不能替代最后的确认评测。
核心思想与公式:先配对,再求差
令第题两个模型的联合正确性为,固定以B减A:
其中,只能取负一、零或一,分别表示B输、打平、赢。百分比乘一百后得到百分点差。本次两个正确性数组形状均为,差值数组也为;不能把两个数组拼接后声称有128个独立观察。
每次重采样产生一组行索引,两个模型必须共用它们:
星号表示一次有放回重采样的统计量,从原来的行均匀抽取。我们固定两万次重复、随机种子9800,取差值分布的2.5%与97.5%线性分位数。这里显式选择百分位法,便于审查每一步,不声称它在小样本下有精确覆盖率。
为何独立抽两个数组不合适?在独立同分布的行假设下:
代表同一随机题上的两份正确性,协方差描述两者共同答对或共同答错的程度。打散配对会丢掉这一项。本例两者高度同向,错误抽法因此给出更宽区间;如果协方差为负,方向可能相反,不能把“配对总会更窄”当作定理。
官方代码阅读路线:一个参数背后的协议
论文层面,Dror等人在ACL2018讨论了任务、度量与实验设置如何影响统计检验选择;它并没有报告本文两个检查点的成绩。[1] 实现层面,我们使用SciPy 1.13.1的官方bootstrap接口。先读参数校验函数:开启配对后,它把数据转换成共享的行索引;再读重采样函数;最后读百分位和标准误的计算。[2]
最容易漏掉的是默认值:官方默认方法为BCa,而本文明确指定百分位法;随机状态也明确传入NumPy的Generator。只抄函数名而不保存参数,复跑就可能改变结果。源码地图给出固定提交、函数和行号,并记录官方文件与安装文件逐字节相同。模型生成继续调用固定Transformers版本的模板、前向与生成接口。[3]
教学脚本另写了一条直接索引路线,逐次对照全部两万份官方差值;独立审计脚本则不导入生产评分代码或SciPy,重新解析输出、统计四格表,并用二项分布复算本例的经验重采样分位数。前者能抓接口理解错误,后者能抓共享实现中的算术错误;两者都不是对总体统计假设的证明。
最小实验:身份先于分数
基础模型是SmolLM2-135M-Instruct,模型和分词器锁定同一修订;两个检查点分别来自种子93与94的类内重排训练。[4] 原训练都使用32条样本、64次更新和1024个监督token。本次不重新训练,而是核对检查点文件哈希,再加载真实权重生成回答。
数据沿用SST-2的固定验证划分中64条开发样本,标签为31负、33正。[5] 训练顺序变化未改变模板、贪心解码、最大32个生成token或输入上限。先做两题乘两模型的资源试跑,再执行完整128次生成;保留128条SST-2与64条新闻确认样本,均未推理。
实际运行在CPU、单精度、四线程完成。新输出的token、提示哈希、题号、标签与原缓存逐项相同,只有测得耗时不同。每模型输入5250个token、输出512个token,包含结束符。首题输入形状为,模型输出张量为,最后一维是词表大小。正式运行在导入依赖后耗时22.675秒,进程峰值常驻内存为1,677,852,672字节;包含进程启动的总墙钟时间为25.699秒。GPU内存未测,因为没有使用GPU。环境与资源数据均来自真实日志。
第一次试跑卡在旧云盘源码缓存读取,尚未进入推理。我们保留中断记录,把下载核验清单缩减为本次必需的11个模型、分词器与验证集文件,官方源码另行匿名获取核验。没有更换数据或模型,也没有把失败轮次从实验史中抹去。
缓存身份也需要可审计。只写模型名不够:同名模型可能有新修订,分词器模板或解码上限变化也会改变输出。本包把基础权重与分词器修订、检查点哈希、数据文件哈希、提示配置、解码规则以及代码哈希纳入身份记录。真实推理与统计重放各自保存命令、退出码和输入身份;读者能够判断自己重算的是哪一批输出,而不是只看到一个无法追溯的总分。
评测协议与实际结果:把一分差拆开
| 同一道题的情况 | 题数 | 对B减A的贡献 |
|---|---|---|
| 两者都正确 | 57 | 0 |
| 两者都错误 | 6 | 0 |
| A正确、B错误 | 1 | −1 |
| A错误、B正确 | 0 | +1 |
这张表比两个平均值多提供了一个事实:全部差异来自验证题号481。两个输出都满足JSON格式,区别是情感标签。仅有这个题号和模型差异,不能推导“否定句导致训练顺序不稳定”等语义解释;那需要另行定义错误类别、准备反例,并在新的样本上检验。
本次实际验证: A为90.625%,B为89.0625%;配对区间为个百分点,独立错误对照为个百分点。两万次官方重采样与直接索引完全一致,独立算术复算也通过。区间只描述当前两个固定检查点在这批开发行上的重采样敏感性。
还必须解释上界为何恰好为零。经验样本里没有B独赢的行,重采样无法凭空产生这种行。因此,这个端点不是“B在总体上不可能更好”的证据。仅对不一致题做双侧精确二项检验,当前只有一次失败,得到;它表示在该对称无优势假设下,一次不一致的方向没有提供反对假设的证据,不是零假设为真的概率;它同样不能证明两模型相等。区间估计、显著性检验和等效检验回答的是不同问题。
失败排查:先找丢失的对应关系
复算器首先拒绝重复题号、漏配对、标签不一致和提示哈希错位,再检查评分与原文是否相符。八项检查包括故意破坏这些字段,以及打乱记录顺序后结果仍不变。按行号相减而不按稳定题号对齐,往往会得到看似正常的均值,却失去真正的比较对象。
第二个隐患是观察单位。当前数据接口没有电影或原评论分组标识,我们只能公开说明按行重采样的条件假设。若未来取得一部电影下多个句子的映射,就应整组抽取电影并保留组内句子;不能伪造分组,也不能把同一题的多个模板当作新独立样本。缺少分组证据时,这份区间对新电影分布的外推仍待核验。
第三个隐患是选择过程。开发样本此前参与过分析,bootstrap不会自动消除这种选择偏差。把重复次数从两万加到二十万,只能减少蒙特卡洛近似误差,不能增加新题,也不能补回未观察到的胜负模式。训练种子的波动同样不在本篇区间之内;要研究训练程序,必须重新定义跨运行的估计对象。
从结果提出可检验的研究问题
作者推断是:本例最值得补充的是新独立样本上的分歧结构,而不是更多小数位。可检验假设可以写成:“在冻结评分与提示后,两个检查点的性能差是否仍集中于少数题?”随后预先规定样本来源、分组单位、主要指标和实际关心的差值大小。
如果要宣称等效,应在看新结果之前给出可接受差值范围,再选择适合设计的区间或检验;不能看见区间接触零就改写成“效果一样”。下一步还要记录所有候选提示和评分设置,把改进选择留在开发集,最后只对冻结方案做确认。本文没有提前打开保留集来让故事更完整。
源码与复现入口
本篇源码已公开并逐文件核验:固定提交源码目录、README运行说明、SOURCE_MAP源码地图。54个分发文件与本地归档一致,下载后的独立复算和真实模型试跑通过。
最小命令如下,它只重放已保存的真实预测,不产生新的模型回答:
python run.py --out replay-new
预期得到逐题配对表、汇总、重采样频数和环境记录。README另给真实模型试跑、完整128输出重建及前篇固定源码获取命令;模型权重和原数据通过锁定来源取得,不依赖作者本地路径。独立审计、配置、精确依赖、失败说明与许可证一并交付。
总结
领先一题是一个观测事实,科研报告还应交代这一题属于什么样的配对结构、估计依赖什么抽样假设、哪些不确定性没有覆盖。本次保留对应关系后得到更窄区间,也看到只有一条分歧带来的边界问题。可审查的结论因此是一个有限的开发集观察,而不是新的模型排行榜。
参考资料
检索并实际访问日期:2026-10-13。
- Rotem Dror、Gili Baumer、Segev Shlomov、Roi Reichart,2018,The Hitchhiker’s Guide to Testing Statistical Significance in Natural Language Processing,ACL;论文全文。
- SciPy开发者,bootstrap 1.13.1官方文档;固定提交实现。
- Hugging Face,Transformers 4.49.0固定生成实现。
- HuggingFaceTB,SmolLM2-135M-Instruct固定模型卡。
- Richard Socher等,2013,Recursive Deep Models for Semantic Compositionality Over a Sentiment Treebank;SST-2固定数据卡。