- 日期:2026-10-07
- 读者:研究生、科研新人和工程型研究者
- 范围:固定小模型与官方评测器,64条开发样本;不是完整GLUE基准或未见测试集。
摘要:先问分数是怎样产生的
前六篇围绕微调讨论了格式与内容的代价。本篇进入第三单元,先不改模型,而是拆开负责打分的机器:同样叫“SST-2准确率”,输入怎样拼接、答案怎样计分、样本怎样编号,都可能不同。仅写“使用官方评测器”,不足以让另一位研究者重现同一个测量。
**本次实际验证:**使用原始SmolLM2-135M-Instruct,在官方任务配置下得到32/64;独立实现对128个候选答案的得分逐项重算,差异为零。更有价值的是,第一次完整运行虽返回相同总分,日志题号却有61处错配,被身份断言拦下。这不是一个“模型提高多少”的故事,而是一个“证据是否对应正确题目”的实验。
复现价值与论文位置
task是评测框架中对一个任务的可执行描述,通常包括数据、划分、提示、候选、答案和指标。YAML则是保存这些字段的配置格式,容易阅读,却不代表全部行为都写在这一页里;未填写的字段仍会从框架取得默认值。
**论文报告:**Socher等在2013年提出情感树库,GLUE论文随后把SST-2纳入多任务语言理解评测。[1][2] 这支持任务来源与研究位置,不支持把本篇64条子集当成完整GLUE结论。lm-evaluation-harness是软件项目;本次使用其2025年发布的0.4.9.2固定版本,不声称它是最新版本,也不虚构一篇与软件同名的新论文。[3]
相对093,本篇新增问题是“官方得分能否被逐项重算”;冻结原始模型、既有开发样本与数据标签,新增变量是测量协议。我们没有拿093训练后的检查点来混比。新增产物包括有效配置、候选token得分、官方逐题结果、身份检查和可追溯失败记录。
核心思想:准确率之前还有一条计算链
官方SST-2任务把原句接到固定问题前,结尾为Answer:,候选依次为negative、positive。[4] multiple_choice在这里表示对给定候选计分,不是要求模型自由生成一个选项字母。令上下文为,第个候选分为个token,则
对应同一条样本,对应候选位置,是冻结的模型权重。候选对数似然越大越优;负数要选择更接近零的那个。公式只累计候选token,不把整段题干的概率混进去,也不自动除以候选长度。
是数据标签,是实际评测行数,本次为64。两个候选位置分别映射标签零和一,得分完全相同时取第一个候选。最终平均的是逐题零一正确性,不能先平均所有负面词得分再与正面词均值比较。
模型输入是一行token编号,去掉最后一个候选token后形状为,输出logits为;词表维度为49152。若题干长度为,候选第一个token由位置预测。这里的移位与训练交叉熵相通,但没有反向传播或权重更新。
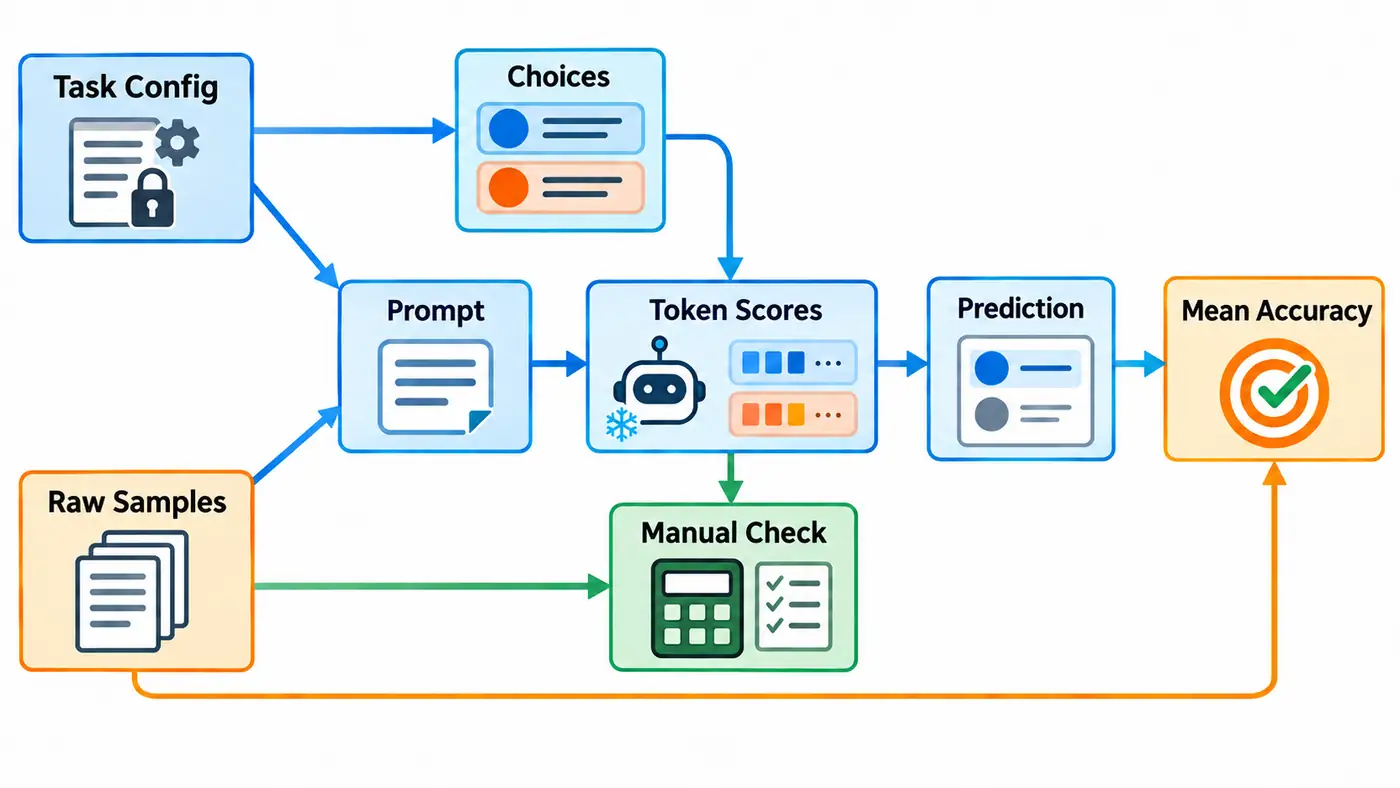
图中原始样本同时提供题干与金标签;金标签只进入对错计算和复核,不进入模型选答案的路径。Manual Check表示原设计中的人工复核环节,没有获得真人确认;本次采用下文披露的独立脚本算术复算。
官方代码阅读路线:从短配置追到默认行为
第一步读固定提交的glue/sst2/default.yaml,把每一字段改写成可检查的问题:读哪份数据,取哪一划分,模型究竟看见什么,零对应哪个候选?不要只读任务名称。
| 层级 | 本次有效设置 | 要检查的含义 |
|---|---|---|
| 数据 | GLUE的sst2配置、validation | 有标签的验证集,被本项目当开发集 |
| 提示 | 原句、固定问题、Answer冒号 | 不套聊天模板,不另加系统提示 |
| 示例 | num_fewshot=0 | 实际加入零个示例,不等于模型从未受过指令训练 |
| 候选 | negative、positive | 按此顺序映射标签,前面补一个空格 |
| 输出 | multiple_choice | 计算候选似然,没有自由生成与答案抽取 |
| 聚合 | acc、mean | 均值来自指标注册,YAML未显式写出 |
第二步读TaskConfig、fewshot_docs和construct_requests。[5] target_delimiter默认是一个空格;它不显眼,却属于实际评分字符串。训练划分为train,未来增加示例时会用到相应样本来源,但本次提示中示例数确实为零。未设置few-shot划分不代表可以从评测题中任意找示例。
第三步沿_encode_pair进入Hugging Face后端。[6] 因果模型按上下文与候选拼接后的字符串分词,再切分边界;独立实现还断言题干token是拼接结果的前缀。若分词跨越边界,简单分别编码再拼接可能不等价。本次两个带空格的候选都各占一个token,编号分别为3524和2731;不附加EOS,不做长度归一化。这个特殊事实不能外推到任意模型或答案。
最后读process_results的argmax与metrics.mean,再读官方simple_evaluate入口。[5][7] 七个安装文件已经与固定官方提交逐字节核对。源码地图给出具体函数、行号、许可证和本地对应模块,读者可以定位每一层的责任。
最小实验与冻结协议
模型与tokenizer沿用revision 12fd25f77366fa6b3b4b768ec3050bf629380bac。[8] 框架固定到ad3f4d0cad1cfcdb815f1e795f7947e49ed9f2e9。配置指向的GLUE数据固定到bcdcba79d07bc864c1c254ccfcedcce55bcc9a8c,并核对其67349条训练和872条验证记录与此前Stanford副本逐行一致;确认的是句子、标签和编号,不是两个压缩文件必须同哈希。
仍按088的哈希顺序取64条开发、另留128条确认;前面单元保留的64条新闻确认也未推理。读取确认行以保存划分身份,不等于把它们送入模型。数据来源许可标记未知,因此公开包保存索引、哈希和派生分数,不分发影评原文、完整提示或题干token编号。
官方支持custom_dataset接口,本地用它读取已校验的固定parquet,改变的是下载和缓存入口;原始任务名、提示、标签、候选和评分逻辑保持一致。该差异必须明说,不能把定制传输描述成毫无覆盖的默认命令。
CPU单精度、四线程、eager注意力、候选批量一、随机种子94、长度上限512。独立实现遇到超长输入直接失败;本次上下文19至61个token,没有截断。请求缓存与模型响应缓存关闭,保存的身份键仍包含模型、tokenizer、数据、提示、计分设置与代码哈希,避免未来复用错结果。
本次实际验证:对上总分,还要对上题号
先对四题进行独立真实前向计算,耗时0.93秒,峰值内存约1.31GB;保守估算正式流程约119秒,低于600秒和4GiB预算。两题官方smoke通过后,再执行64题正式核验。成功运行从第三方导入后计时12.10秒,其中独立评分4.81秒、官方调用5.81秒;峰值RSS为1310195712字节,未测GPU内存。
最终官方与独立实现均为32/64,128个候选得分最大绝对差为零;所有标签、提示哈希、候选边界和最终题号一致。模型预测61条negative、3条positive,开发标签则为31条负面、33条正面。总分接近二分类偶然水平,并不自动证明模型只能猜测;这里还观察到了明显的标签偏向。
四题复核包已经列出真实似然。例如编号400的两个得分为-3.8741与-4.7651,标签为positive;评分规则会选择negative并判错。编号615则选negative且与金标一致。四题各候选只有一个token,所以求和退化为原分数,适合先核对方向、映射和均值。
**复核状态(2026-10-08更新):**原计划要求真人重算四题,实际没有收到真人结果,官方验证已先行完成;这一顺序偏离保留。纯算术检查改为独立脚本复算:四题均预测negative,正确数为2/4;完整64题复算为32/64,与官方逐题记录一致。输入、脚本哈希与执行结果已归档。当前验收通过,但这不是人工审核,也没有新增语义金标。
失败排查:总分正确也可能留下错证据
第一次64题调用传入哈希顺序的题号列表。该固定版本按数据原始顺序筛选题目,却用调用者列表顺序回填日志的doc_id,于是61条日志题号与原数据idx不一致。独立身份断言让程序以退出码一停止。只看50%的总分,会完全漏掉这个问题。
修复仅对传入题号排序,64题集合和全部候选得分未变;再次运行通过。初次返回、失败日志、修复前源码和身份差异均保留。这是针对该版本的输入规范化,不是声称最新框架仍有同一问题,更不是借调试重新挑测试题。
复核也有层级。重新计算已有得分的均值,只能发现聚合错误;重新编码题干,才能检查提示与样本身份;独立执行模型前向并逐token取概率,才覆盖评分路径。本次分别保存这三层记录,没有用最后一个总分替代前面的检查。即使两个实现完全一致,它们仍可能共享同一预训练模型、分词器或错误的任务假设,因此一致性不能证明语义标签绝对正确。
此外,官方尝试读取调用目录的Git信息时输出非仓库提示,流程仍正常返回;本项目用实际固定提交和安装文件哈希确认来源,不把调用目录的版本号当成评测器版本。警告、真正失败和已核验成功必须分开记录。
也不要把本次32/64与088的57/64直接解释为能力下降。权重相同,但提示形式、聊天模板和评分方式同时改变;前者是候选似然选择,后者是自由生成后解析。差距提出了协议敏感性问题,却没有单独隔离哪一个因素造成差异。
可检验的研究问题与总结
**作者推断:**当前负面偏向可能来自提示形式与候选先验的共同作用。后续应先固定一套评分规则,再分别改变训练划分中的示例选择和顺序,保存同题配对结果;另一个实验才处理选项文本、字母与归一化。不能同时改完所有因素,再给单一原因贴标签。
第三单元的起点因此不是一张新排行榜,而是一份测量说明:数据版本、题号身份、完整提示、候选边界、计分公式、聚合与失败都可追踪。协议审核通过只说明“这些数字按声明的方法算对了”,不说明模型已有稳定能力,也不恢复反复使用开发集所失去的确认性证据。
源码与复现入口
源码已经公开并完成固定提交核验:完整目录、README与运行说明、SOURCE_MAP官方实现地图。53个分发文件与本地逐字节一致;从公开版本导出的副本也通过真实模型试跑。固定源码包保留10月7日的待人工审核历史记录;10月8日仅调整验收方式并补充独立算术核验,模型、数据、代码和原结果未改。当前完成状态不代表真人复核已经发生。
安装依赖、用prepare.py获取并校验资源后,最小真实入口为:
HF_HUB_OFFLINE=1 TOKENIZERS_PARALLELISM=false python run.py --cache ./cache --out smoke-new --private private-new --smoke
该命令评分两题、四个候选,并保存官方与独立记录;去掉--smoke运行同一64条开发样本。随后执行python audit.py --cache ./cache --out smoke-new,离线核对身份与算术。当前已经执行四题独立计算、两题官方试跑、一次被拦截的完整运行及排序修复后的完整运行,没有训练模型或评测保留确认集。
参考资料
检索日期:2026-10-07。软件版本、数据与模型精确哈希见源码资源锁;论文只支持其对应研究背景。
- Richard Socher等,2013,EMNLP:Recursive Deep Models for Semantic Compositionality Over a Sentiment Treebank。
- Alex Wang等,2018初版、ICLR 2019,arXiv v3:GLUE: A Multi-Task Benchmark and Analysis Platform for Natural Language Understanding。
- Lintang Sutawika等,EleutherAI,2025:lm-eval v0.4.9.2软件发布记录。
- EleutherAI:固定SST-2任务配置。
- EleutherAI:固定Task实现。
- EleutherAI:固定token边界实现、Hugging Face后端。
- EleutherAI:固定评测入口、指标注册与聚合。
- HuggingFaceTB:固定模型卡;NYU:固定GLUE数据卡。