- 日期:2026-09-29
- 读者:研究生、科研新人和工程型研究者
- 范围:真实模型、冻结候选、四组预处理对照;开发集探索,不是完整基准排名。
摘要
上一篇用同一批候选比较原始融合排序与交叉编码器,发现重排没有提高主要指标。接下来最容易出现的故事是:“摘要太长,重要信息被截掉了。”这个解释听起来合理,却还不是证据。今天把它拆成两个可干预变量:文档是否带标题、成对输入最多保留多少 token。保持权重、查询和候选不变,才能检查方法胜负对输入协议有多敏感。
本篇比较四个提前登记的条件,逐对保存实际输入长度、得分和名次。我们关心的不只是哪个均值更高,还包括同一条相关文档是否被截断、哪些查询改变方向,以及结果能否支持下一步假设。所有数字来自本次真实运行;关于证据位置的解释仍是待验证推断。
目录
- 复现价值与边界
- 核心思想、公式与模块
- 官方代码阅读路线
- 最小实验与评测协议
- 实际结果与失败分析
- 可检验的研究问题
- 源码与复现入口
- 总结与参考资料
一、复现价值:先检查输入,再评价方法
SciFact 原任务包含科学论断检索、支持或反驳判断以及理由定位。本系列只使用其 BEIR 导出版本的文档相关性标注,不把相关文档排得更靠前等同于事实核验成功。[1] 前几篇已固定完整五千余篇语料上的检索输出,这次继续使用上一篇的开发查询子集。新增问题是重排阶段的文本表达,而非召回算法或训练方法。
标题可以概括主题,也可能占用摘要空间;更长输入可能保留关键句,也可能加入干扰。二者都没有必然收益。若只把最大长度改大,并发现分数上升,仍需问:是可见内容变了、输入位置变了,还是某几个查询主导均值?复现的价值在于把这些问题转成可检查的记录。
论文报告:Nogueira 与 Cho 的工作说明用 BERT 联合编码查询与候选段落进行重排的路线。[2] 本次实际验证:执行已训练的 MiniLM 交叉编码器,没有复现该论文训练,也没有使用其报告成绩作为对照。作者推断:协议变化可能解释部分方法差异,需要当前四组实验检验。
二、核心思想:把文本构造放进评分函数
交叉编码器让查询和文档在同一个 Transformer 中交互,输出相关性分数。可以写成:
这里, 是查询, 是原文档, 表示是否拼接标题, 是字段构造, 是长度上限为 的分词和截断过程, 是固定模型权重。改变标题或长度,即使权重完全相同,模型看到的输入也已不同。本次输出是一个原始标量分数,不把它解释为校准后的相关概率。[3]
分词器把词拆成 token,即模型处理的文本单位。长度上限包括查询、文档以及三个特殊符号,并不是允许摘要单独占满指定长度。批输入形状为 , 是批大小, 是补齐后的序列长度;隐藏状态为 ,分类头输出 。官方实现使用最长序列优先截断,超限时优先从较长的一侧删减。[4]
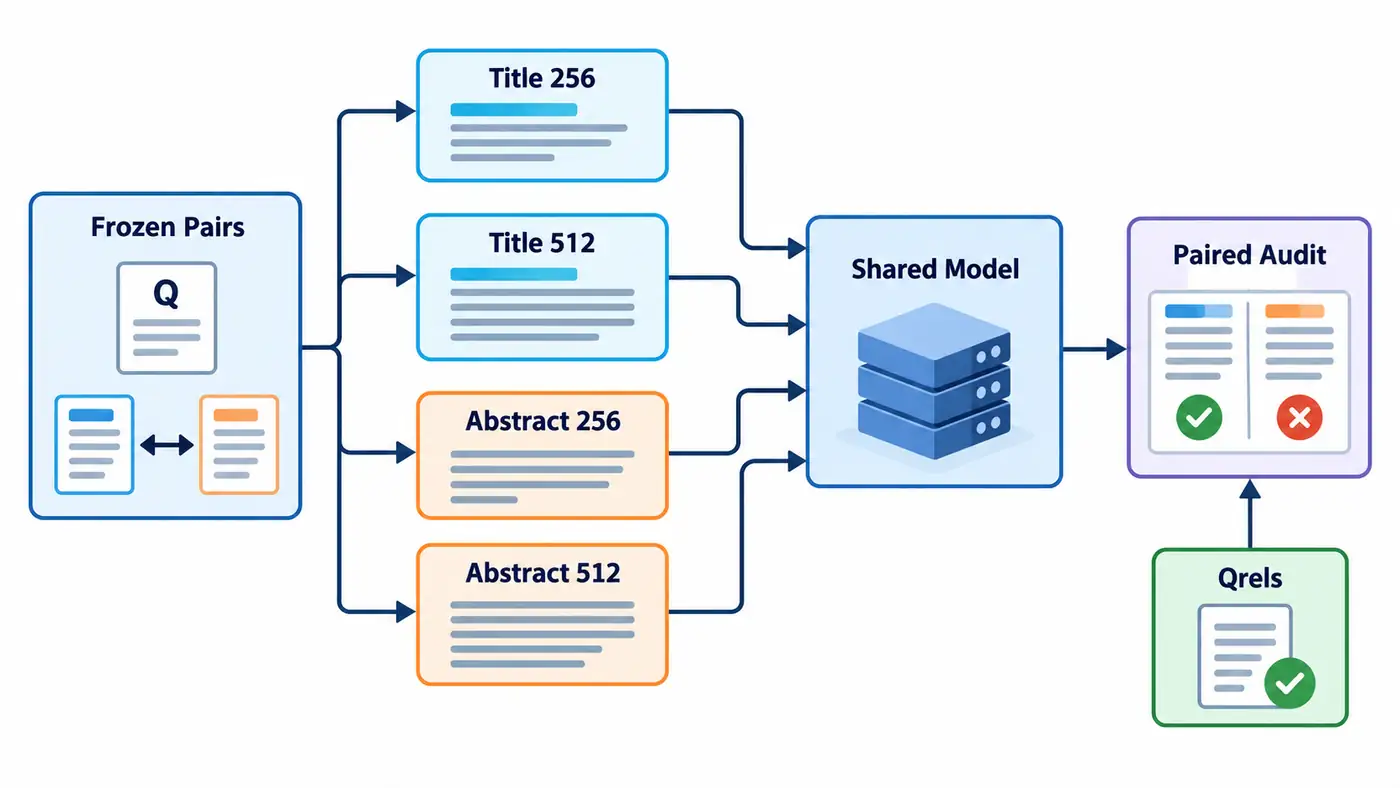
四组都接收同一候选对并使用同一权重。图中的共享模型表示参数共享,不表示把四份输入同时拼成一条序列;标注只在配对评测时使用。原 RRF 是倒数排名融合留下的固定排序,作为参照保留,其检索阶段预处理没有改变。
三、官方代码阅读路线
先读 BEIR 的 Rerank.rerank:它按候选 ID 构造查询与文档对,把标题、空格和摘要拼接,然后把预测分数重新对应到文档 ID。[5] 本篇保留这个文件的原始字节;摘要条件通过传入空标题实现,避免改写官方评分逻辑。标题条件则保持上一篇的拼接方式。
再读 Sentence Transformers 的 smart_batching_collate_text_only,确认字符串去除首尾空白、动态补齐、longest_first 和 max_length。接着沿 predict 看到模型切换至评估模式、关闭梯度并返回单标签分数。[4] 最后核对模型卡和配置,确认实际是六层模型、隐藏维度三百八十四、一个标签,而不是根据名称猜测结构。[3]
本地对官方文件、许可证和安装版本做了哈希或规范化换行后的全文比较。源码地图给出完整提交号、文件行号和本地入口。独立编写的部分包括条件编排、token 审计、配对差计算与绘图;这些不是论文原始实现,不能混称“全部官方复现”。
四、最小实验与评测协议
使用固定的一百条开发查询,每条五十个 RRF 候选,共五千个查询—文档对。查询仍按上一篇的哈希规则选择;没有因本次效果重新抽样。完整语料规模为 5183,四组均不重建索引、不替换候选、不训练,三百条确认查询继续留出。
四个条件是“标题+摘要、上限二百五十六”“标题+摘要、上限五百一十二”“仅摘要、上限二百五十六”“仅摘要、上限五百一十二”。固定模型与分词器 revision、CPU 单精度、四线程、批大小十六和随机种子。种子控制运行状态,不表示重新抽取查询。最大长度是干预变量,因此实际处理 token 和计算量不会相等;这不是等计算预算的模型能力比较。
主指标为 nDCG@10,即考虑相关文档名次并按理想排序归一化的折扣增益。辅助指标为首个相关结果倒数名次的 MRR@10,以及前十、前五十召回率。分数相同时按文档 ID 字符串降序排列。因为候选集合固定,Recall@50 必须相同;若它变化,优先排查实现,而不是庆祝提升。
每条查询保留四组分数与原排序的配对差。还计算描述性交互量:
是相应条件的平均 nDCG@10,下标一、零表示保留、去掉标题。 描述标题效应是否随长度改变,不是总体因果交互的统计证明。全部条件事先登记、全部报告,不把开发集最好条件直接宣布为最终方案。
第一次命令漏传试跑参数,误启动完整条件,随后中断并保存退出码一百三十及已有日志。纠正后先跑五查询乘十候选的四组试验,仅按耗时与内存决定是否扩展。正式运行与误启动分开留档,已有分数没有参与参数选择。资源、形状和每阶段状态均随源码发布。
五、实际结果与失败分析
| 条件 | nDCG@10 | MRR@10 | Recall@10 | 相关对截断数 |
|---|---|---|---|---|
| 固定 RRF | 0.670906 | 0.637361 | 0.7775 | 不适用 |
| 标题+摘要,256 | 0.659686 | 0.615258 | 0.8125 | 95 |
| 标题+摘要,512 | 0.669133 | 0.626750 | 0.8175 | 20 |
| 仅摘要,256 | 0.650207 | 0.602718 | 0.8100 | 86 |
| 仅摘要,512 | 0.638613 | 0.592262 | 0.8000 | 18 |
本次实际验证:四组均未超过固定 RRF 的主要指标,方法胜负没有翻转。带标题的 512 条件精确重现上一篇五千个分数;全部条件 Recall@50 都是 0.905。更长窗口在带标题时提高 nDCG@10 约 0.009447,十二胜、七十八平、十负;仅摘要时却下降约 0.011594,十胜、七十四平、十六负。标题效应从短窗口的 0.009479 增至长窗口的 0.030520,描述性交互量约 0.021040。
每组候选中有 108 个标注相关的查询—文档对。带标题时,窗口扩大使其截断数从 95 降至 20;仅摘要时从 86 降至 18,却没有换来均值改善。查询 token 全部保留。短窗口去掉标题后,保留的摘要 token 从 1009770 增至 1101794,但主要指标仍降低,因此“摘要看得更多就一定更好”在这里不成立。
预登记规则选出的查询 308,其相关文档在带标题条件下从第六升到第一;查询 1050 和 1166 则都从第一降到第二。这些是可复算的名次变化,不是已经解释清楚的语义错误。一个查询改善也不能替另外两个退步查询提供理由。
四组正式推理合计 394.74 秒,整次运行 418.88 秒,进程峰值 RSS 1040351232 字节;实测 Python 3.12.14、macOS、CPU 单精度。计时包含范围见日志,不含下载和历史检索,GPU 显存未测。固定运行顺序也意味着耗时只作资源记录,不作严格性能结论。
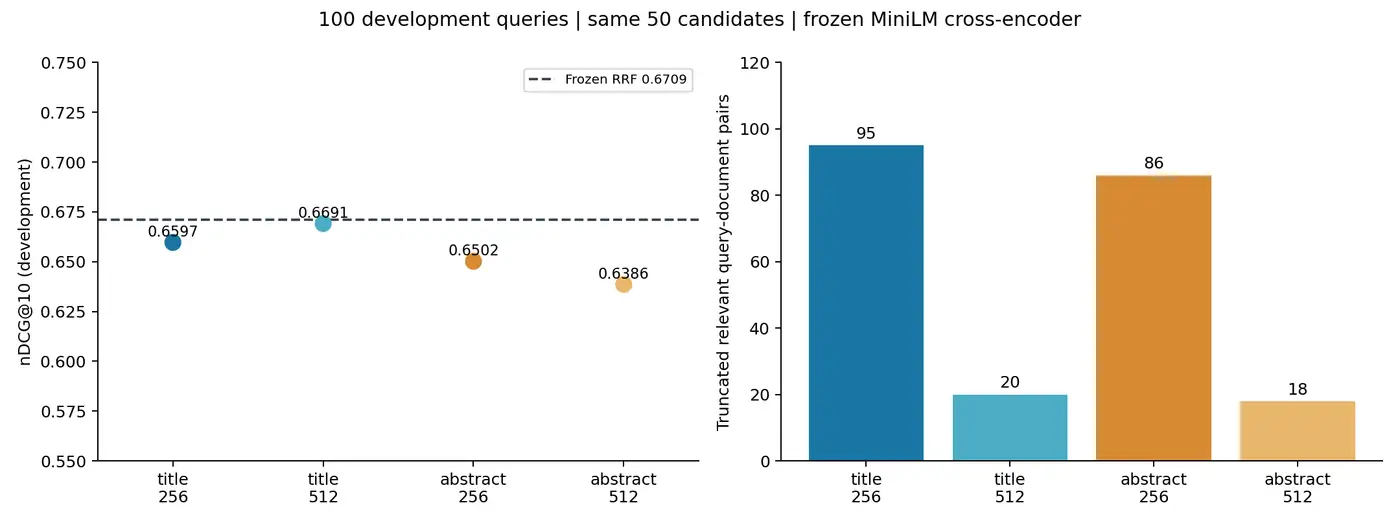
图由配套绘图脚本读取已保存汇总生成,左侧展示主要指标与固定 RRF 参照,右侧是被截断的相关查询—文档对数,不是独立文档数,也不是丢失证据句数。未做多次独立采样,因此不绘制没有依据的误差线。
失败排查按证据层次进行。第一,核对各组候选 ID 完全一致,排除“换了一批更容易的候选”。第二,核对成对输入长度而非字符长度;实际记录查询、标题、摘要和特殊符号,并与模型入口抽样比对输入 ID 哈希。第三,独立重算逐查询指标和合计值,避免格式或聚合错误伪装成模型变化。
第四,区分“相关文档被截断”和“支撑论断的句子被截断”。相关性标签只指出文档有关,不能告诉我们剩余前缀是否足够。这里没有制作人工金标,也没有声称人工确认错误原因。第五,不能只挑改善案例;按预登记的绝对长度效应排序选择案例,保留负向变化及所有未变化查询。
六、把直觉改写成可检验问题
假设甲是“较长窗口通过保留后部证据改善排序”,假设乙是“标题或前缀词项已足够,新增文本主要改变干扰”。二者都能解释一部分均值变化,但预言不同。下一步可以在开发样本中标注证据位置,再比较真正新增证据可见的样本与证据始终可见的样本;标注需要独立人工完成,当前尚未执行。
另一个区分实验是固定实际摘要 token 数,再改变标题是否存在或所在位置。如果收益只在增加文本预算时出现,就不宜归因于标题语义本身。这个设计还需检查位置变化、截断边界和标签有效性,不应直接把本次去标题对照包装成纯语义因果实验。
所有这些都是后续问题,不是已取得的结论。当前只对一个冻结模型、一批已使用的开发查询负责。模型训练语料污染没有审计,未标注相关文档也可能被当作不相关;没有跨领域结果、总体置信区间或“长上下文理解能力”结论。下一篇迁移实验需要在换域前明确冻结方案,并如实记录方案来自开发探索。
七、源码与复现入口
已发布并匿名核验的固定版本:完整源码目录、README 运行说明、SOURCE_MAP 官方源码地图,以及统一运行入口。远端五十三个文件与本地归档逐一核对一致。
安装固定依赖并按 README 获取已锁定资源后,最小运行命令是 python run.py --cache ./cache --out smoke-new --smoke。它执行四组真实模型推理,输出逐对分数、实际 token 计数、逐查询指标、汇总和阶段日志。完整范围删除试跑开关,使用新的输出目录。本次实际完成一百查询乘五十候选乘四条件;仅运行离线审计不能替代模型推理。
数据版本由公开归档及文件哈希标识,模型和分词器固定同一提交。缓存身份包括字段、长度、模型、数据、提示设定、解码方式和代码哈希;入口每次重新推理,不偷偷复用旧得分。包内包含全部自写模块、许可和小型验证记录,大资源按校验过的下载步骤获取。本地压缩包另作验收归档,读者入口以公开源码为准。
八、总结
预处理是评分函数的一部分,方法名称不能代替输入协议。可靠的复现需要同时交付条件定义、真实输入审计、逐查询变化和失败记录。即使找到一个更高分的设置,也只能说明这个冻结系统对设置敏感;只有提出竞争解释并设计能区分它们的下一次实验,才开始接近可检验的科研问题。
参考资料
检索与实际访问日期:2026-09-29。固定版本与文件哈希见源码地图。
- David Wadden 等,2020,Fact or Fiction: Verifying Scientific Claims,EMNLP。
- Rodrigo Nogueira、Kyunghyun Cho,2019初版、2020年v5,Passage Re-ranking with BERT。
- Sentence Transformers,MS MARCO MiniLM-L6-v2 固定模型卡。
- Sentence Transformers 3.4.1,CrossEncoder 固定源码。
- BEIR,Rerank 固定实现。